
ECCV 2020, Conferencia Europea de Visión por Computador: análisis de la detección de objetos de extremo a extremo con transformadores.
 Si hace clic en la imagen, puede ver el texto completo.
Este artículo fue publicado por el equipo de Facebook AI. algoritmos de detección de objetos más simples que tradicionales y arquitecturas más competitivas.Prestó la atención de muchas personas. Esto se llama DETR (Transformador de Detección). Las características de DETR son 1) que utiliza una función dicotomía y 2) que utiliza un transformador que se utiliza a menudo en el procesamiento del lenguaje natural. Lo es.
¿Problema resuelto por este artículo?
Los métodos de detección de objetos existentes son demasiado complejos y utilizan una variedad de bibliotecas. Por lo tanto, era bastante difícil utilizar el método existente.
Por ejemplo, para detectar un objeto utilizando métodos de detección de objetos existentes, era necesario tener en cuenta la forma de la caja de fijación y cómo se manejaba cuando la caja de fijación estaba superpuesta. Pensemos en ello como un todo, porque es más eficiente.
Eso es, Se necesitaba una arquitectura más simple para resolver el problema de que era bastante difícil utilizar los métodos de detección de objetos existentes, y esto se resolvió en este artículo.
Todo el DETR.
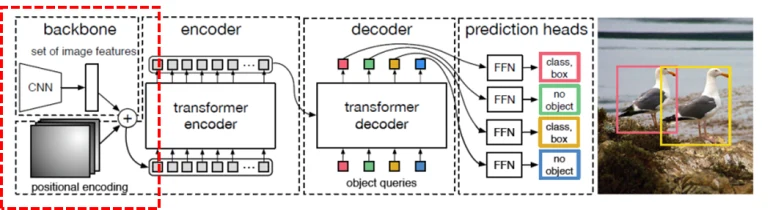
1) Una red de columna vertebral (CNN) se utiliza para extraer características para la imagen, y 2) una codificación posicional se utiliza para obtener información relativa de ubicación en la imagen.
* * *
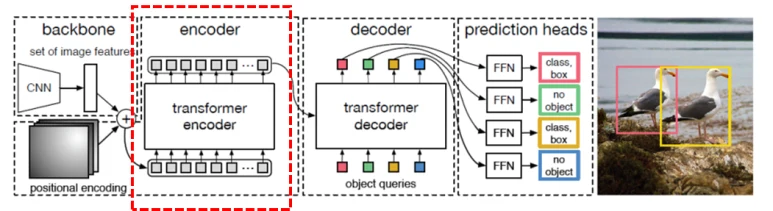
La característica extraída de la red de columna vertebral y la información relativa de ubicación obtenida de la codificación posicional son entrada al encoder. Aquí, cada información del píxel corresponde a datos secuenciales. Por lo tanto, un transformador adecuado para el procesamiento de datos secuenciales se utiliza como un encoder.
* * *
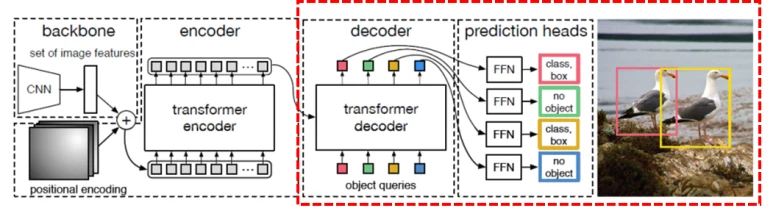
Por otro lado, la salida del encoder y la consulta de objetos (un número fijo de embeddings de ubicación aprendida) son entrada al decodificador, y la salida del decodificador se pasa a la red de avance de alimentación (FFN) que genera la salida final. El valor final del resultado es: 1) si existe un objeto particular, contiene información sobre la clase para ese objeto y la caja de vinculación asociada con donde existe ese objeto; y 2) si un objeto particular no existe, ningún objeto está representado como una clase, lo que significa que no existe.
* * *
Utilice la función de pérdida de emparejamiento binario para asegurarse de que el emparejamiento entre el resultado final y el valor real es exitoso.Hagámoslo. Esto le permite detectar cada una de las instancias no duplicadas a través de la función de pérdida coincidente.
Como resultado, es toda la estructura para extraer características de la imagen cuando se introduce la imagen, y luego transformarla para que los resultados de detección de objetos reales puedan obtenerse.
Esto es bipartidista que coincide.
En el pasado, el problema de predicción establecido se resolvió indirectamente utilizando NMS (pensión no máxima). Específicamente, el problema de predicción de conjunto se resolvió encontrando un lugar aleatorio y luego comprimelo en uno, sin especificar cuántas instancias de objetos existían en toda la imagen.
Sin embargo, según el informe, Establece el problema de predicción con él. Directel New York Times.
Específicamente, el problema de predicción de conjunto fue resuelto arreglando, "Sólo las imágenes N pueden tener una instancia de objeto."
Eso es, Permite que la dimensión de salida sea N, y cuando se compara con la verdad terrestre real, realiza una dicotomía para coincidir uno a uno, de modo que el problema de predicción de conjunto se resuelve..
Por ejemplo, si usted pin N a 6 que puede haber hasta seis instancias de objetos en toda la imagen, usted realiza una coincidencia binaria en el proceso de aprendizaje para que la instancia no se solape. En este caso, se induce a la instancia a no superponerse.
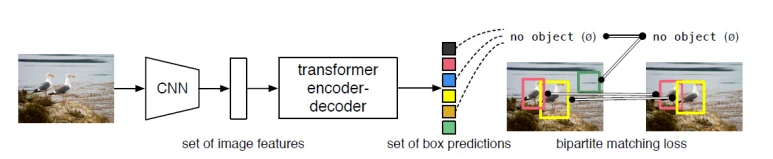
Supongamos que la predicción de dos aves que realizan la detección de objetos utilizando la imagen tomada durante el proceso de aprendizaje es la siguiente:
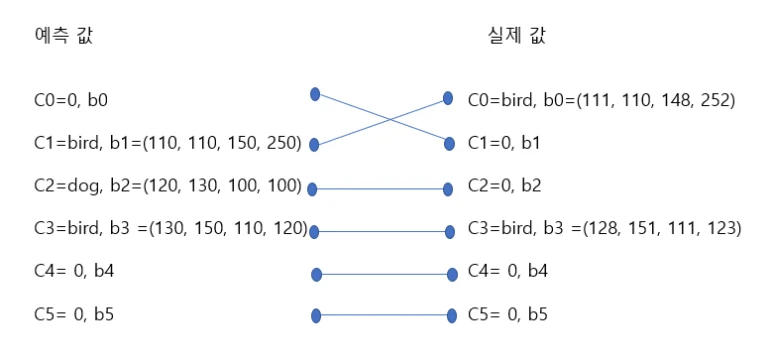
C = clase
b = información del cuadro de enlace (x coordenadas, y coordenadas, ancho, altura)
Porque N=6, el valor de predicción es C0 a C5.
Aquí, el valor de predicción C2 contiene el resultado equivocado, que configura el valor de pérdida coincidente para tener un valor de pérdida más bajo cuando la clase es la misma y la información de la caja es similar. Y cuando todo el partido está terminado, todo el valor de pérdida realiza este partido en la dirección más baja.
Realizar coincidencias basadas en información de clase y de caja. (El valor de predicción C1 coincide con el valor C0 real, y el valor de predicción C3 coincide con el valor real C3), y los valores de predicción restantes sin la clase se corresponden aleatoriamente con los otros valores del mundo real.
En el proceso de aprendizaje, se enseña a reducir la información de la clase en el cuadro de enlace. Entonces, si hay un valor de predicción incorrecto (valor de predicción C2) en el valor de predicción, se corresponde con el valor real (valor de predicción C2).
De esta manera, si el aprendizaje tiene éxito, sólo se puede predecir la ubicación y el número de objetos. El problema es resuelto por el problema predicado. Si el partido binario se realiza, incluso si cada posición de salida se cambia en el resultado de la predicción (por ejemplo, las posiciones de C1 y C3), no habrá problemas con el partido binario en absoluto, por lo que el orden será cambiado y sólo se aprenderán dos cajas de enlace para detectar el pájaro para que la redundancia de la instancia pueda evitarse naturalmente..
¿Por qué usaste Transformer?
Un transformador es una de las arquitecturas que se utilizan para entrenar mejor la incrustación de datos cuando se enumeran los datos secuenciales.
Transforemer 1) Se utiliza para comprender la información contextual de toda la imagen a través de la atención, y 2) para facilitar la comprensión de la interacción de cada instancia en la imagen.
Específicamente, el mecanismo de atención permite a cada pixel realizar la atención asignando puntos de atención uno al otro, en cuyo caso la instancia está separada, y el contexto se entiende por cada instancia.
También, Los transformadores se utilizan para facilitar la asociación de píxeles lejos de una gran caja de fijación.
Incluso en el procesamiento del lenguaje natural, si la duración de una oración se desvía, puede que no sea fácil identificar la asociación entre la primera palabra y la última palabra. Los transformadores pueden identificar fácilmente la relación en este caso. Al igual que el procesamiento de lenguaje natural en imágenes, hay un problema que hace difícil comprender fácilmente la asociación de píxeles lejos de una gran caja atada.
¿Qué es Encoder?
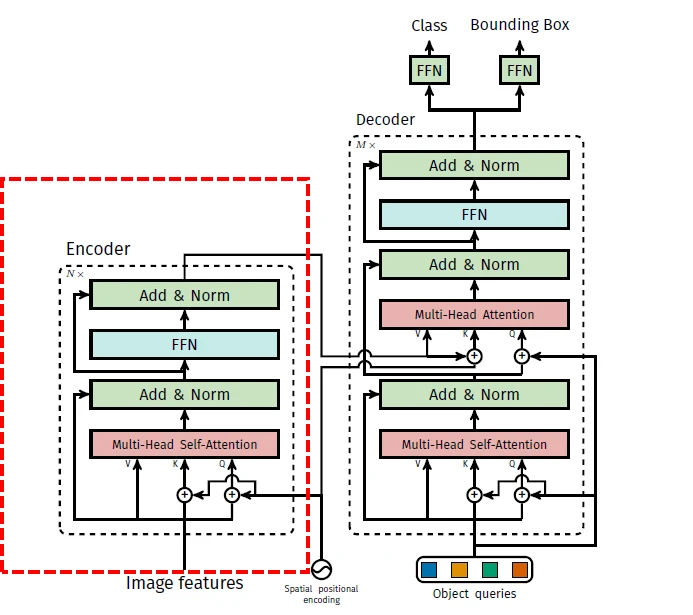
El encoder toma los datos de posición de cada píxel que contiene la información de características de la imagen y realiza la codificación.Lo hago. Específicamente, el encoder recibe un mapa de características con un tamaño d*HW de continuidad.
(d=image feature, HW = cada pixel location information)
Además, la información de codificación posicional se puede introducir para codificar y procesar adecuadamente la información de ubicación para los datos de imagen reales presentes en 2D.
Por otro lado, cuando la información de la imagen se introduce en el encoder, se aprende la información de interacción y asociación para cada píxel mientras se realiza la auto atención. La información codificada se utiliza en la parte decodificación.
Después de que se hayan realizado todas las codificaciones, puede visualizar el mapa de autoatención para ver que las instancias individuales están debidamente separadas de la siguiente manera: En otras palabras, Específico específico Se puede ver que cada píxel (punto rojo) está adecuadamente separado de qué parte está relacionado.
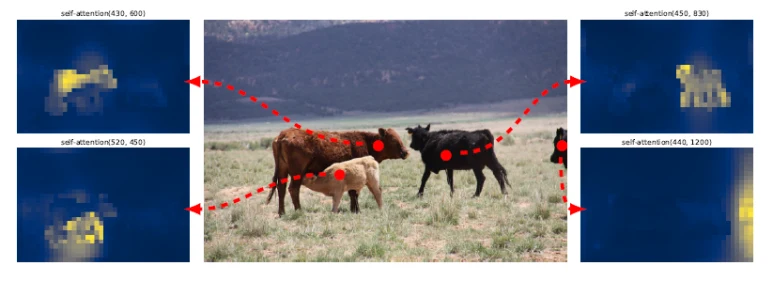
El mapa de autoatención. Cuatro vacas están debidamente separadas.
¿La función de Decoder?
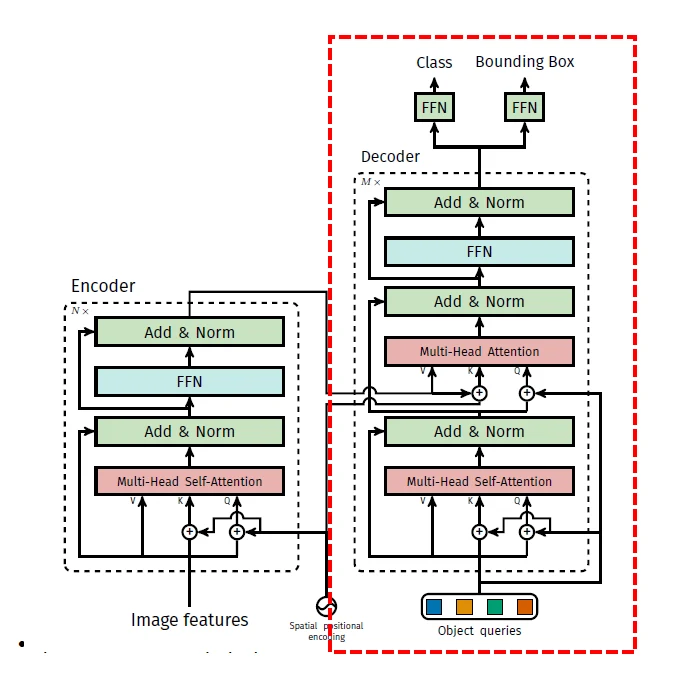
El decodificador recibe las consultas de objetos N como entrada inicial, recibe la información codificada del encoder, y puede entender el contexto de toda la imagen.. Cuando la información codificada es recibida del codificador, la información de codificación posicional es también entrada y la información de ubicación para los datos de imagen reales presentes en 2D puede ser codificada y procesada adecuadamente.
El decodificador permite que cada consulta de objetos a la clase de salida y la información de caja de conexión para una sola instancia. Es decir, una arquitectura está configurada para distinguir N diferentes instancias únicas.
Como resultado, Si el encoder separa una instancia a través de la atención global, el decodificador extrae la clase y el límite de cada instancia.
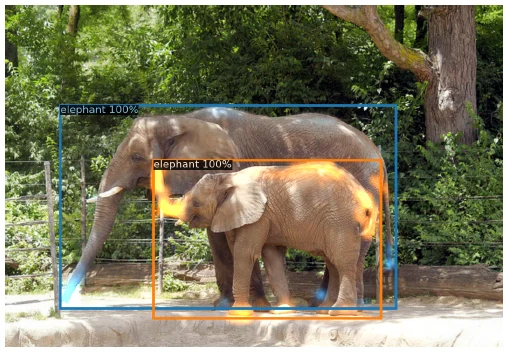
La imagen siguiente muestra un mapa de atención de cada uno de los objetos N en la parte decodificador. Al final de cada instancia, se puede ver que el valor de socre de la atención está altamente formado (expresado en azul y naranja).. En este caso, la línea inferior es hacer que la caja de fijación se ajuste.
DETR muestra buen rendimiento para objetos grandes, pero bajo rendimiento para objetos pequeños. El problema con DETR es que tarda mucho tiempo en aprender. Para compensar esto, parece necesario desarrollar tal tecnología que pueda manejar objetos pequeños bien al mismo tiempo que reduce el tiempo de aprendizaje del DETR.
Este artículo del archivo refleja la situación en su fecha de publicación. Contacte con el despacho para analizar su caso.