
Actualmente, la mayoría de las empresas no pueden prestar servicios satisfactorios a sus clientes debido a la falta de personal e infraestructura en el departamento de servicio al cliente. Para complementar esto, estamos introduciendo chatbots para mejorar la calidad del servicio al cliente.
Muchas empresas incorporan chatbots para responder con rapidez las 24 horas y reducir el personal necesario para atender consultas. Por ejemplo, AT&T utiliza bots para responder a llamadas de atención al cliente.
Sin embargo, estos chatbots no son simplemente un servicio que se puede implementar mediante la plantación de unas pocas líneas de código o proporcionando una API. La introducción de chatbots por ciertas empresas requiere el procesamiento de datos de atención al cliente, no sólo la integración de servicios, en los datos necesarios para aprender el módulo IA de chatbots.
En este post, explicaremos una patente relacionada con cómo procesar los datos de aprendizaje necesarios para aprender el módulo IA de chatbots.
[patented]
Si hace clic en la imagen, puede ver la patente de registro.
Esta patente está relacionada con un método para aumentar los datos de entrenamiento del módulo de chatbot.
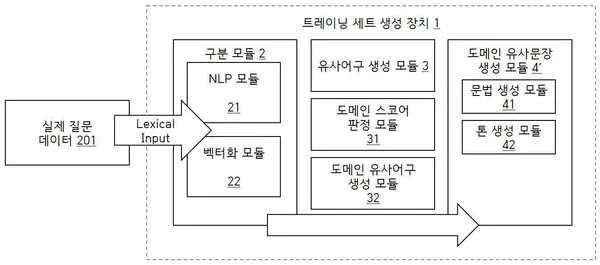
Cuando se trata de aprender módulos de chatbot, generalmente necesita tres preguntas y tres respuestas. Esto significa que usted necesita tener un conjunto de datos de qué preguntas responder. Sin embargo, las tres preguntas y las tres respuestas no siempre pueden estar tan satisfechas como queremos que sean. El problema es la cantidad de datos en el aprendizaje supervisado.
Así, para el aumento de datos, se analizan datos de preguntas del mundo real para producir declaraciones de preguntas similares con el mismo significado y se utilizan como datos de entrenamiento para chatbots. Específicamente, si usted ya tiene tres preguntas y tres respuestas para aumentar la cantidad de datos, la patente afirma que si usted tiene un conjunto de preguntas que utiliza el procesamiento del lenguaje natural para entender el significado de la frase, usted puede generar otro tono de preguntas con la misma intención y generar un conjunto de datos con múltiples preguntas y una respuesta.
Si agrega datos al patrón, se producirá el mismo efecto. En primer lugar, incluso si hay muy pocos datos de respuesta para ese dominio al construir un chatbot, la cantidad de datos que pueden ejecutar suficientemente el módulo IA del chatbot puede generarse específicamente para el dominio. Y debido a que los datos proporcionados por el cliente basado en la palabra y la similitud de la frase se pueden generar en un grupo de múltiples oraciones del mismo significado, si el cliente que quiere desarrollar un chatbot es una startup, puede resolver el problema de que la cantidad de datos que tienen es muy baja.
Además, muy pocos conjuntos de datos pueden producir resultados significativos e incluso una pequeña cantidad de pruebas puede maximizar los resultados. Esto minimiza el preprocesamiento y elimina la necesidad de que los clientes etiquetan cada nueva pregunta, reduciendo la carga de trabajo tanto de la compañía chatbot como del cliente.
Este artículo del archivo refleja la situación en su fecha de publicación. Contacte con el despacho para analizar su caso.