
许多企业因客服人员及基础设施不足,难以充分满足客户需求,因此引入聊天机器人以改善服务质量。
随着聊天机器人的引入,有很多公司希望迅速响应,24小时同时减少回应客户所需的人数. 例如,如果AT&T调用CS,就是让bot响应.
然而,这些聊天器并不仅仅是一种可以通过植入几行代码或提供API来实现的服务. 某些公司引进聊天员需要处理客户支持数据,而不仅仅是服务整合,以进入学习聊天员的AI模块所需的数据.
在本文中,我们将解释一项专利,该专利涉及如何处理学习聊天人AI模块所需的学习数据.
[被射
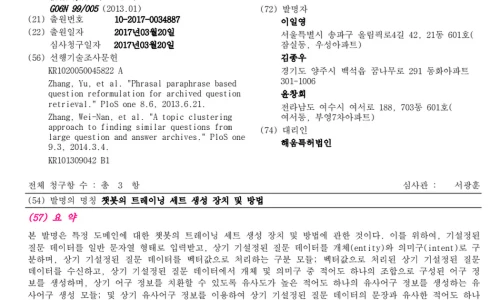
点击图像即可看到注册专利.
这一专利与增强聊天舱训练数据的方法有关。
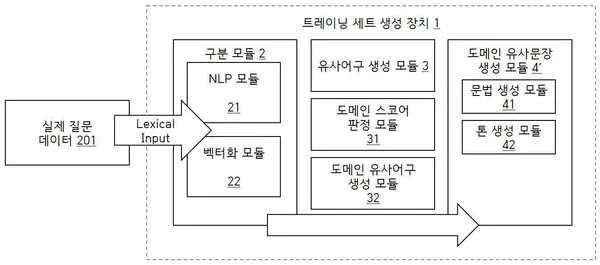
在学习聊天器模块时,通常需要三个问题和三个答案。这意味着你需要一个数据组来回答什么问题。然而,三个问题和三个答案不能总是像我们希望的那样满足。 问题在于监督学习中的数据量。
因此,对于数据增强,对现实世界的问题数据进行分析,以产生具有相同含义的类似问题语句,并用作聊天员的训练数据. 具体来说,如果您已经有三个问题和三个答案来增加数据的数量,专利称,如果您有一个问题集,使用自然语言处理来理解句子的含义,您可以以同样的意图生成另一个问题基调,并生成一个包含多个问题和一个答案的数据集.
如果将数据添加到图案中,也会产生同样的效果. 首先,即使构建聊天器时该域的回答数据很少,能够充分运行该聊天器AI模块的数据数量也可以专门为该域生成. 而由于客户端基于单词提供的数据和短语的相似性可以生成成一组具有相同含义的多个句子,如果想要开发一个聊天器的客户端是一个启动,那么它可以解决他们拥有的数据量非常低的问题.
此外,很少的数据集能够产生有意义的结果,即使是少量的测试也能使结果最大化。 这减少了预处理,也消除了客户给每个新问题贴上标签的需要,减少了聊天器公司和客户的工作量.
本文基于发表时的情况撰写。如需就具体事项咨询,请联系IPLEX。