
В настоящее время большинство компаний не могут предоставить удовлетворительные услуги своим клиентам из-за нехватки персонала и инфраструктуры в отделе обслуживания клиентов. В дополнение к этому мы внедряем чат-ботов для улучшения качества обслуживания клиентов.
С появлением чат-ботов существует множество компаний, которые хотят быстро реагировать, 24 часа в то же время, что и сокращать количество людей, необходимых для реагирования на запросы клиентов. Например, если AT&T вызывает CS, он говорит боту ответить.
Однако эти чат-боты — это не просто сервис, который может быть реализован путем установки нескольких строк кода или предоставления API. Внедрение чат-ботов некоторыми компаниями требует обработки данных поддержки клиентов, а не только интеграции услуг, в данные, необходимые для изучения модуля ИИ чат-ботов.
В этой статье мы расскажем о патенте, связанном с тем, как обрабатывать данные обучения, необходимые для изучения модуля ИИ чат-ботов.
[запатентовано]
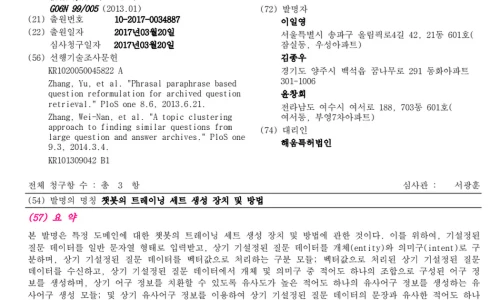
Если нажать на изображение, то можно увидеть регистрационный патент.
Данный патент связан с методом увеличения обучающих данных модуля чатбота.
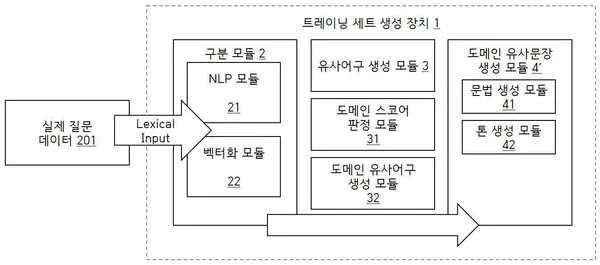
Для обучения чат-бота обычно необходимы наборы вопросов и соответствующих ответов, то есть данные о том, какой ответ должен следовать на каждый вопрос. Однако такие пары не всегда доступны в нужном количестве. Это та же проблема недостаточного объёма данных, которая возникает при обучении с учителем.
Таким образом, для увеличения данных анализируются данные реальных вопросов для получения аналогичных утверждений вопросов с тем же значением и используются в качестве данных обучения для чат-ботов. В частности, если у вас уже есть три вопроса и три ответа для увеличения объема данных, патент гласит, что если у вас есть набор вопросов, который использует обработку естественного языка для понимания смысла предложения, вы можете генерировать другой тон вопросов с тем же намерением и генерировать набор данных с несколькими вопросами и одним ответом.
Если вы добавите данные в шаблон, произойдет тот же эффект. Во-первых, даже если при создании чат-бота очень мало данных вопросов-ответов для этого домена, количество данных, которые могут достаточно запускать модуль ИИ чат-бота, может быть сгенерировано специально для домена. И поскольку данные, предоставленные клиентом на основе слова и сходства фразы, могут быть сгенерированы в кластер из нескольких предложений одного и того же значения, если клиент, который хочет разработать чат-бот, является стартапом, он может решить проблему, что объем данных у него очень низкий.
Кроме того, очень немногие наборы данных могут дать значимые результаты, и даже небольшое количество тестирования может максимизировать результаты. Это минимизирует предварительную обработку и устраняет необходимость для клиентов маркировать каждый новый вопрос, уменьшая нагрузку как на компанию, так и на клиента.
Материал отражает ситуацию на дату публикации. Обратитесь в IPLEX, чтобы обсудить обстоятельства вашего дела.