현재 대부분의 회사가 고객지원 서비스 부서의 인력과 인프라의 부족으로 고객들에게 만족할만한 서비스를 제공하지 못하는 상태이다. 이를 보완하기 위한 방법으로 고객지원 서비스의 품질 향상을 위해, 챗봇을 도입하고 있는 실정이다.
챗봇의 도입으로 인해 고객 응대에 필요한 인력을 줄임과 동시에 24시간 빠르게 응답 처리하고자 하는 회사들이 상당히 많이 생기고 있다. 예를 들어, AT&T는 CS에 전화를 하면 봇이 응대하도록 하고 있는 것처럼 말이다.
하지만, 이러한 챗봇은 단순히 코드 몇 줄을 심거나 API를 제공하여 구현할 수 있는 서비스가 아니다. 특정 회사에서 챗봇을 도입하려면 단순히 서비스 integration으로 단번에 끝나는 것이 아니라 기존에 쌓여 있던 고객 지원 데이터를 챗봇의 인공지능 모듈의 학습에 필요한 데이터로 가공하는 과정이 필요하다.
본 포스팅에서는 챗봇의 인공지능 모듈의 학습에 필요한 학습 데이터를 가공하는 방법과 관련된 특허를 하나 설명하고자 한다.
[특허 내용]
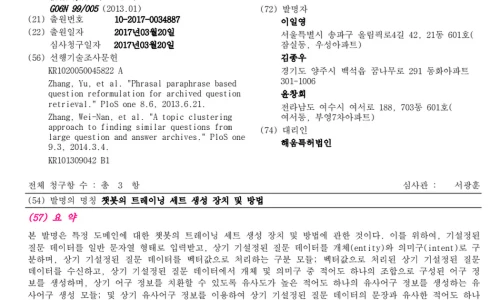
이미지를 클릭하면 등록특허공보 전문을 확인할 수 있다.
본 특허는 챗봇 모듈의 트레이닝 데이터를 증강(Data Augmentation)을 위한 방법과 관련된 특허이다.
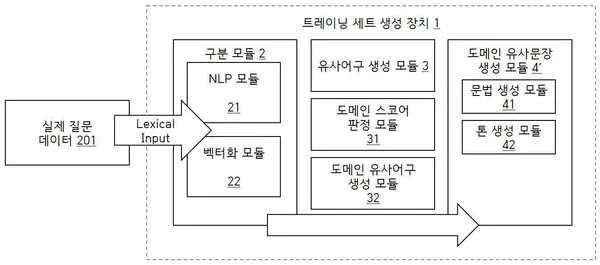
보통 챗봇 모듈을 학습시킨다고 하면 질문 셋과 해답 셋이 필요하다. 즉, 어떤 질문에 어떤 답변을 하면 되는지에 대한 데이터 셋이 필요한 것이다. 다만, 질문 셋과 해답 셋이 항상 우리가 원하는 개수만큼 충족될 수는 없다. 교사 학습에서 데이터 셋의 양이 문제 되는 것과 마찬가지 문제이다.
따라서, 데이터 증강을 위해, 실제 질문 데이터를 분석하여 의미가 동일한 유사 질문 문장을 생성하여 챗봇의 트레이닝 데이터로 활용하게 된다. 구체적으로, 데이터양을 늘리기 위해서 이미 가지고 있는 질문 셋과 해답 셋이 있으면 질문 셋에서 질문 문장을 자연어 처리를 이용해서 의미를 파악하고, 동일한 의도를 가지는 다른 톤의 질문들을 생성하여 하나의 질문과 하나의 해답을 가지고 여러 개의 질문과 하나의 해답을 가지는 데이터 셋을 생성한다는 것이 본 특허의 핵심 내용이다.
본 특허와 같이 데이터 증강을 해주면 다음과 같은 효과가 발생하게 된다고 한다. 먼저, 챗봇을 구성할 때 해당 도메인의 질문-대답 데이터가 매우 적다고 하더라도 챗봇의 인공지능 모듈을 충분히 러닝 시킬 수 있는 양의 데이터를 도메인에 specific 하게 생성할 수 있다. 그리고 취합된 단어 및 phrase의 유사성을 기준으로 고객사가 제공한 데이터를 같은 의미인 여러 형태의 문장의 군집으로 생성할 수 있기에 챗봇을 개발하고자 하는 고객사가 스타트업인 경우, 보유하고 있는 데이터의 양이 매우 적다는 고질적인 문제를 해결할 수 있다고 한다.
뿐만 아니라, 아주 적은 데이터 셋으로 유의미한 결과를 창출해낼 수 있으며 소량의 테스트로도 결과를 극대화할 수 있다. 즉, 전처리를 최소화시키고 고객사가 새로운 질문 각각에 라벨링(Labeling)을 해줘야 하는 필요성을 없애 챗봇 회사와 고객사 모두의 업무 부하를 줄여줄 수 있다.
이 글은 표시된 게시일을 기준으로 작성된 자료입니다. 개별 사안에 대한 검토는 상담을 통해 안내합니다.