
現在、ほとんどの企業は、顧客サービス部門のスタッフやインフラの不足により、顧客への満足度の高いサービスを提供することができません。 これを補完するために、チャットボットを導入し、顧客サービスの品質を向上させます。
チャットボットの導入に伴い、顧客対応に必要な人数を削減すると同時に、素早く24時間対応したい企業がたくさんあります。 たとえば、AT&TがCSを呼ぶと、ボットが応答するように伝えます。
しかし、これらのチャットボットは、単に数行のコードを植えたり、APIを提供することで実装できるサービスではありません。 特定の企業によるチャットボットの導入では、サービス統合だけでなく、チャットボットのAIモジュールを学ぶために必要なデータに顧客サポートデータを処理する必要があります。
この記事では、チャットボットのAIモジュールを学習するために必要な学習データを処理する方法に関する特許について説明します。
[特許取得済み]
画像をクリックすると登録特許が確認できます。
この特許はチャットボットモジュールのトレーニングデータを拡張するための方法に関連しています。
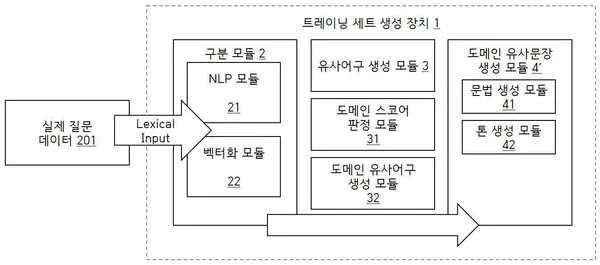
チャットボットモジュールを学習する場合、通常は3つの質問と3つの回答が必要です。 つまり、回答する質問のデータセットを持っている必要があります。 しかし、3つの質問と3つの回答は、常に満足するものではありません。 問題は、教師学習におけるデータの量です。
したがって、データ拡張のために、実際の質問データは同じ意味で同様の質問文を生成し、チャットボットのトレーニングデータとして使用されるように分析されます。 具体的には、すでに3つの質問と3つの回答があり、データの量を増加させる場合は、自然言語処理を使用して文章の意味を理解した質問セットがある場合、同じ意図で別のトーンを生成し、複数の質問と1つの回答で設定されたデータを生成することができます。
パターンにデータを追加すると、同じ効果が起こります。 まず、チャットボットを構築する際に、そのドメインに問題のあるデータがほとんどない場合でも、チャットボットのAIモジュールを十分に実行できるデータ量は、ドメイン用に特別に生成できます。 そして、クライアントが語に基づいて提供したデータとフレーズの類似性は、同じ意味の複数の文のクラスターに生成することができるので、チャットボットを開発したいクライアントがスタートアップであるならば、それは彼らが持っているデータの量が非常に低いという問題を解決することができます。
さらに、非常に少ないデータセットは、有意義な結果を生み出し、少量のテストでも結果を最大化することができます。 これにより、顧客のニーズを最小化し、各新しい質問をラベル付けし、チャットボット会社と顧客の両方のワークロードを減らすことができます。
この記事は公表時点の情報に基づいています。個別の事情については、当事務所にご相談ください。