
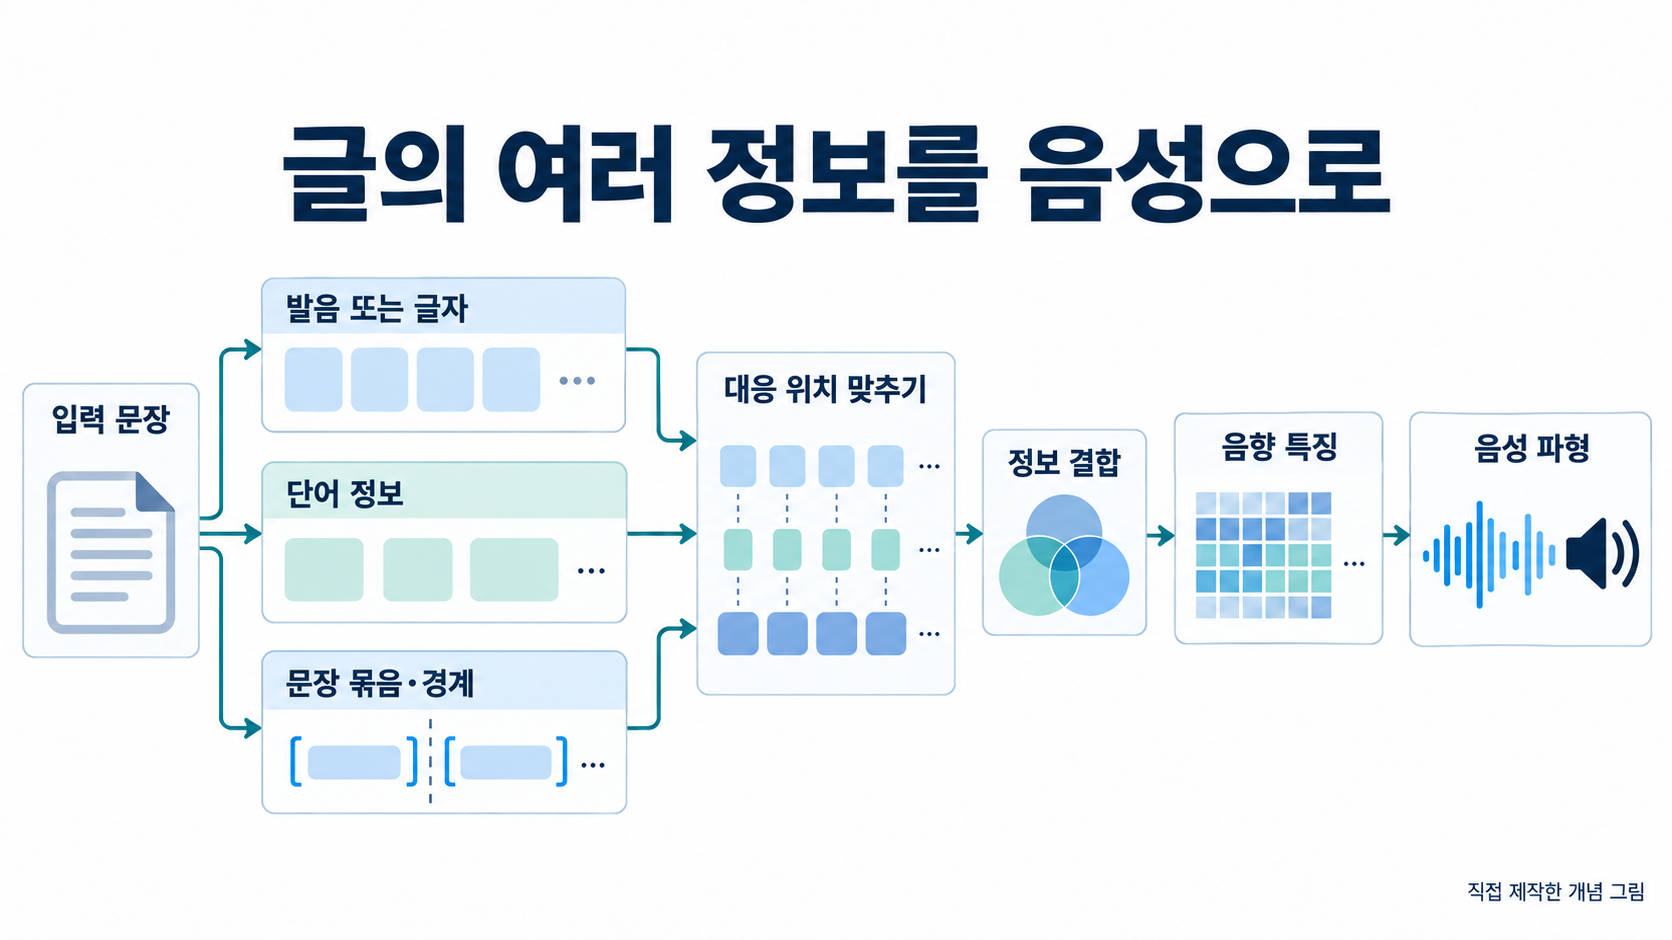
把客户通知转成语音,既要发音清晰,也要让语句衔接自然。微软的美国专利US12094447B2描述了一种利用多层次语言信息的文本转语音架构。本文以虚构的发货通知为例,说明不同输入如何对齐,并最终生成可播放的语音波形。
1. 同一句话也可以有不同的听觉效果
假设一家网店向客户朗读:“您订购的商品将于明天发货。”文字在屏幕上很容易理解,但听觉效果还取决于词语是否清楚、在哪里停顿,以及各部分怎样衔接。固定的文本并不对应唯一的朗读方式。
文本转语音,即TTS,是根据既有文字生成合成语音的技术。它不只是逐一产生声音,还要形成音高、时长、重音与停顿。这些共同构成语音的韵律,使句子具有节奏和语调。
该专利在音素或字符层面的信息之外,引入词级和句级信息。发音的基本单元由此与语言上下文及结构表示共同参与处理。各类表示从哪里取得、在什么位置结合,是理解其技术方案的重要线索。
这里讨论的是如何把已经给定的句子表达为声音,而不是选择回答内容或重新编写客户通知。内容生成与语音合成应当分别理解。
2. 音素、词语和句子分别提供什么信息
音素是区分语音的基本单位,字符层面的信息则依据输入文字的排列。专利说明的是从音素序列或字符序列出发的处理方式,并不意味着每种实现都必须同时输入这两类序列。
词级信息利用从语言数据中学到的表示,体现词语及词语之间的关系。例如,发货通知所提供的语言背景可能与其他文体不同。模型并非只把每个词看成一个没有语言信息的编号。
句级信息来自语法结构,例如一个词属于哪种短语、是否处于短语边界,以及在短语中的相对位置。这些特征把句子内部各个词组的组织关系带入语音合成过程。
上述信息都不是已经完成的声音。它们分别把发音单位、词语信息和句子结构表示成模型可以处理的数据。分清这些层次,就更容易理解后续为什么需要对齐和融合。
3. 把词语与语法结构变成计算特征
词嵌入用一组数值表示词语,使神经网络能够处理它。专利描述了利用预训练词嵌入模型取得词级信息的方法,将语言材料中学到的知识用于语音合成输入。
语法分析则把句子组织成由短语和词语构成的树状结构。系统可以从中提取短语类型、词语是否位于短语起止边界,以及词语在短语中的相对位置等特征。
在虚构通知中,可以把说明订购商品的部分和说明明天发货的部分看作便于理解朗读节奏的两个组。这只是示意性划分。真实分析器的输出取决于所用语言与具体分析方法。
关键不是在通知后面附上一段语法解释,而是把结构转成与各个词对应的可计算特征。这样,句子的组织方式才能成为语音模型可以利用的输入。
4. 让长度不同的序列在相应位置对齐
词语序列与字符或音素序列通常并不等长,因为一个词可能包含多个字符或音素。直接把这些序列并排放置,不能清楚说明哪些词级信息对应哪些发音单位。
专利描述的一种方法,是按照词语所对应的音素或字符数量,重复配置该词的信息。词级语法特征也可采用同样的对齐方式。这种上采样把信息映射到粒度更细的序列上。
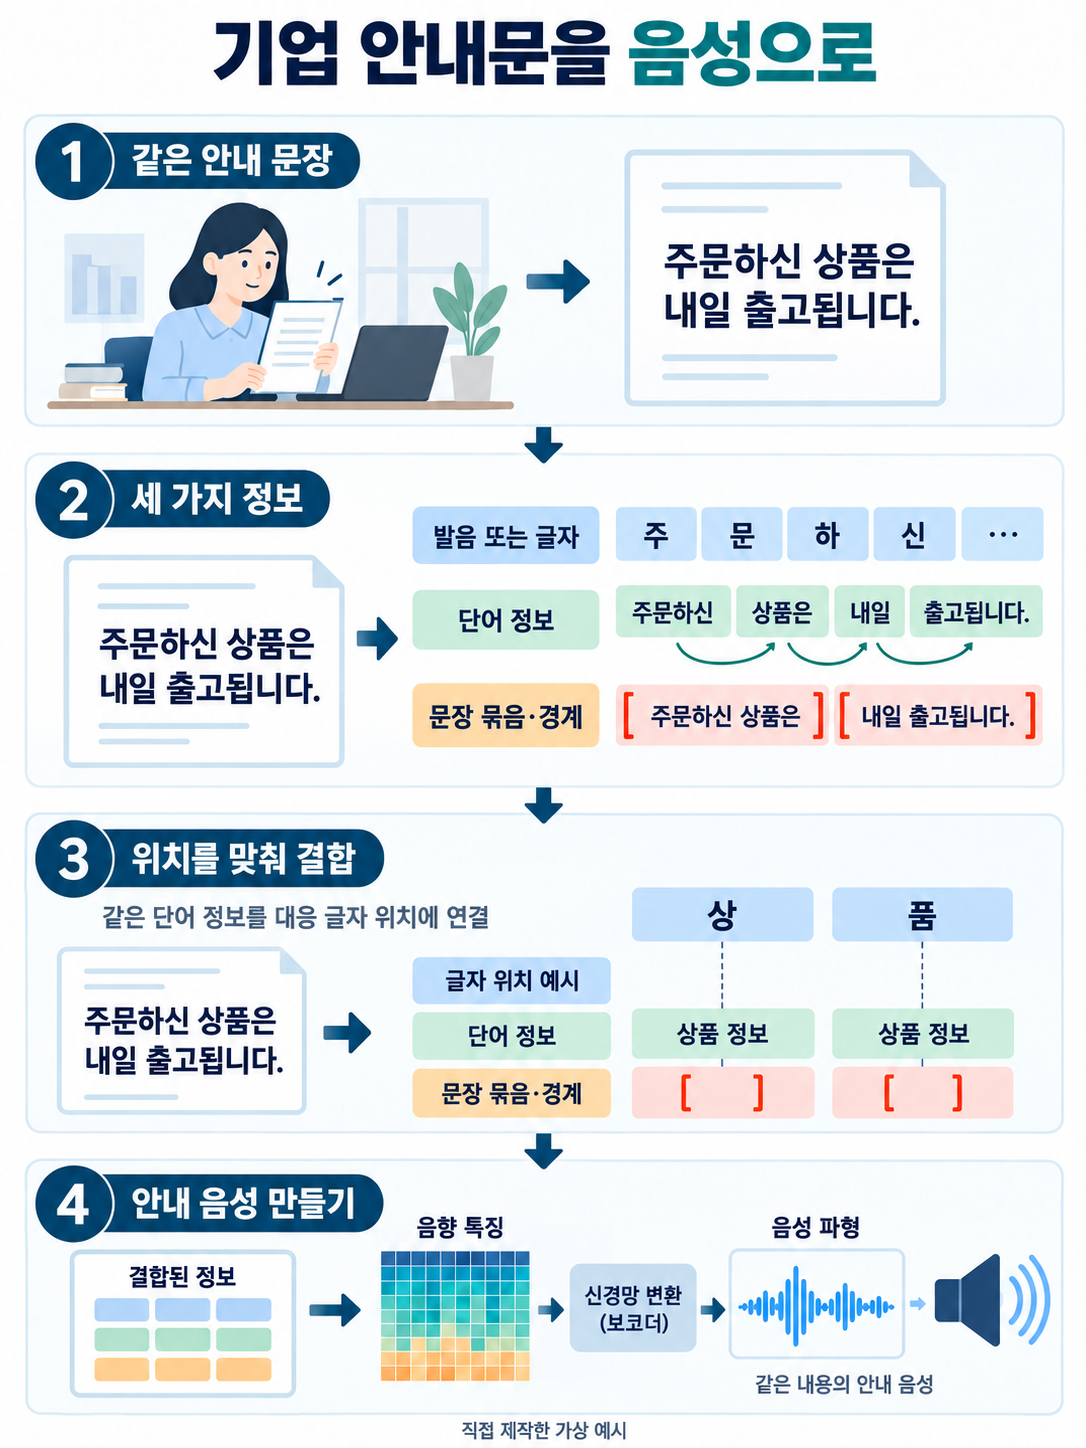
原文的韩语示例使用一个表示“商品”的词,它写成两个韩文音节块。相同的词级信息被关联到这两个位置。这不表示把该词读两遍,而是让各个位置都能参考所属词语的信息。
此处对齐的是文本表示之间的位置关系,并非延长录音时间或改变播放速度。实际语音随时间展开的过程,要在这些输入信息结合之后继续生成。
5. 从信息融合到声学特征与波形
准备好的信息进入多输入编码器。编码器把输入转换成后续神经网络便于处理的表示。在该方案中,音素或字符信息与上下文信息共同生成文本特征。
说明书给出了不同的融合位置:既可以先用不同网络处理各类输入,再拼接处理结果,也可以先组合输入,再交给神经网络。除了使用什么信息,还应关注在哪一步组合,才能区分不同架构。
文本特征通过注意力机制和解码器转成声学特征。注意力帮助关联生成声音时所需的文本信息。这与此前把词级特征对齐到字符或音素位置的处理不同:前者连接文本与声学生成,后者协调不同文本输入。
声学特征是中间表示,例如描述声音的频率相关特性,尚不是扬声器能够直接播放的最终信号。随后,声码器根据这些特征生成语音波形,完成从多层次文字信息到可听声音的转换。
6. 跟随一个虚构的发货通知
网店已经决定向客户传达“您订购的商品将于明天发货”,这句话就是合成输入。查询实际发货日期、判断通知内容是否属实,均不属于本例所说明的TTS步骤。
系统先准备音素或字符序列,再从同一句话中提取词语信息,并通过语法分析取得词组结构。这是对同一通知的不同层次表示,并不是重新生成三份通知。
随后,词级与句子结构特征被关联到相应的音素或字符位置。拥有共同的位置基础后,编码器便能在处理一个发音单位时,同时利用它所属的词语和句法结构信息。
融合后的文本特征转成声学特征,再由声码器生成波形。工作人员可以试听姓名、商品名称等表达的发音,以及语句分组是否便于理解。图示用于说明输入与生成过程,并非真实Azure界面、声音录制或产品测量结果。
7. Azure Speech与语音服务设计
微软Azure Speech提供文本转语音功能。官方文档介绍了神经网络语音、通过SDK或REST API进行合成,以及有声内容创作工具。这些能力可用于客户通知和文档朗读等场景。
语音合成标记语言SSML允许用户指定句子、停顿、发音、语速和音高等输出方式。用户对输出的控制,应与专利中词语和句子信息的内部处理区分开来。官方产品说明本身不能证明Azure采用了该专利的特定架构。
开发团队值得梳理的技术差异,在于输入层次及信息的融合位置:只输入字符或音素,还是加入已学习的词表示;语法结构怎样编码;不同长度的序列又怎样对齐。
设计文档若依次写清输入、中间表示、对齐、融合、声学特征和波形生成,会比仅描述“AI朗读自然”更具体。这能说明究竟哪个处理环节发生变化,并区分发音输入方面的改进与利用上下文信息的改进。
如果团队希望在不改变通知内容的前提下改善语音表达,可以先考察词语和句子信息以何种形式进入语音模型。把可见文字与可听结果之间的步骤说明清楚,是理解该技术并讨论专利问题的具体基础。
图中保留原始标注与形态,相关内容在正文中说明。
了解IPLEX的人工智能专利业务,咨询语音服务中的具体技术特征。
Related AI analyses: 解读NAVER图像翻译专利:让译文跟随移动的相机画面 · 模型回答与检索知识冲突时,百度的RAG方案如何处理