
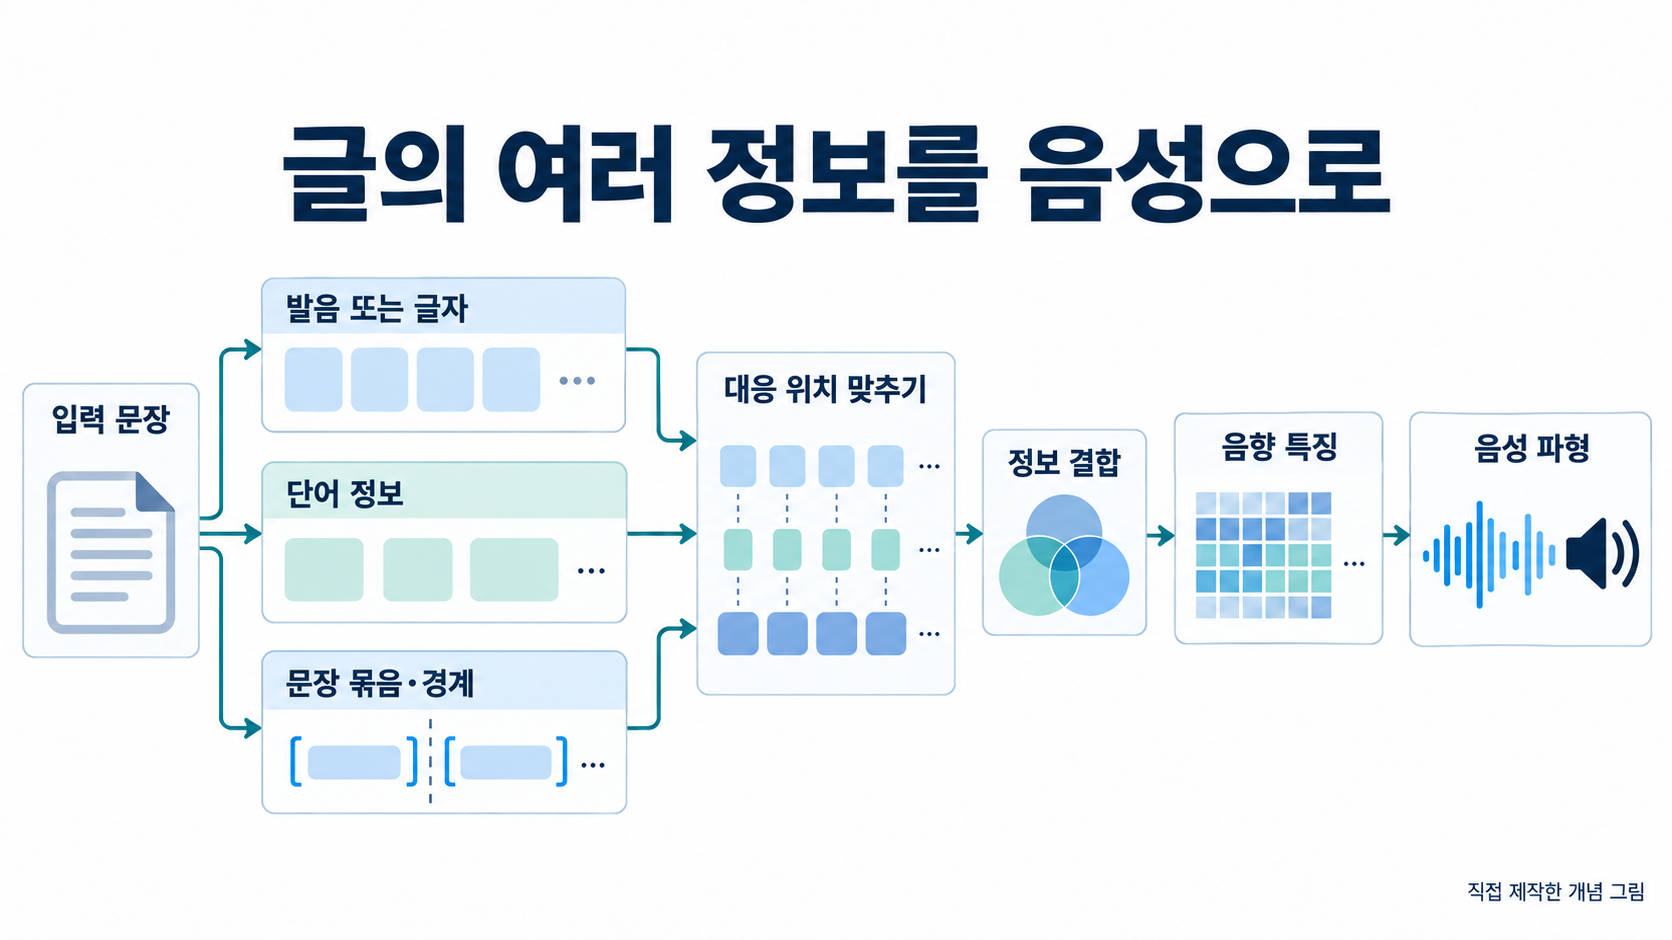
В голосовом уведомлении важны и чёткое произношение, и связное звучание фразы. Патент Microsoft US12094447B2 описывает архитектуру синтеза речи, использующую несколько уровней языковой информации. На условном примере уведомления об отправке заказа рассмотрим, как согласуются входные данные и формируется речевой сигнал.
1. Один текст может звучать по-разному
Представим, что интернет-магазин озвучивает фразу: «Ваш заказ будет отправлен завтра». На экране её смысл понятен сразу. При прослушивании важны также отчётливость слов, паузы и переходы между частями фразы. Заданный текст не определяет единственный возможный вариант произнесения.
Преобразование текста в речь, или TTS, создаёт синтезированную речь по уже написанному сообщению. Система формирует не только отдельные звуки, но и высоту тона, длительность, ударения и паузы. Эти характеристики образуют просодию — ритмическую и интонационную организацию высказывания.
В рассматриваемом патенте информация о фонемах или символах дополняется информацией об отдельных словах и о предложении. Единицы произношения обрабатываются вместе с представлениями языкового контекста и структуры. Для понимания технического решения существенны источник каждого представления и этап их объединения.
Речь идёт о синтезе уже заданного сообщения. Выбор ответа или составление нового уведомления — отдельные операции. Здесь рассматривается то, как система вычисляет звуковое выражение полученного текста.
2. Что дают фонемы, слова и предложение
Фонема служит единицей различения звуков речи, а информация на уровне символов следует последовательности написанного текста. В патенте рассматривается исходная последовательность фонем либо символов. Это не означает обязательного одновременного использования обоих типов во всех реализациях.
На уровне слов используются представления, полученные при обучении на языковых данных. Они передают информацию о словах и отношениях между ними. Уведомление об отправке заказа задаёт иной языковой контекст, чем текст другого назначения; слова рассматриваются не просто как условные номера.
Информация уровня предложения отражает грамматическую структуру. Она может указывать, к каким фразовым составляющим относится слово, находится ли оно на их границе и каково его относительное положение внутри каждой составляющей. Так организация групп слов становится частью входных данных для синтеза.
Ни один из этих видов информации ещё не является готовым звуком. Это вычислительные представления единиц произношения, слов и структуры предложения. Разделение уровней помогает понять, почему далее необходимо согласовать длины последовательностей и объединить признаки.
3. Подготовка лексических и грамматических признаков
Векторное представление слова, или эмбеддинг, задаёт слово набором чисел, пригодным для нейросетевой обработки. Патент описывает получение такой информации из предварительно обученной модели. Знания, усвоенные из языкового материала, используются как вход для синтеза речи.
Грамматический разбор позволяет представить предложение деревом, в котором выделены фразовые составляющие и слова. Из этой структуры извлекаются признаки типа составляющей, положения на её границе и относительной позиции слова внутри неё.
В условном уведомлении для объяснения чтения можно выделить часть о заказанных товарах и часть об их отправке на следующий день. Это лишь упрощённая иллюстрация. Результат настоящего синтаксического анализатора зависит от языка и выбранного способа разбора.
Грамматическая структура преобразуется в вычислительные признаки, связанные с отдельными словами. К сообщению не приписывается дополнительный текст с объяснением грамматики. Структурная информация поступает в форму, которую может использовать речевая модель.
4. Как согласуются последовательности разной длины
Последовательность слов обычно короче последовательности символов или фонем: одному слову могут соответствовать несколько элементов. Простое размещение последовательностей рядом не устанавливает, какие признаки слова относятся к каждой единице произношения.
Один из описанных способов повторяет информацию о слове по числу соответствующих ему фонем или символов. Аналогично можно согласовать грамматические признаки, извлечённые для слова. Такое повышение разрешения последовательности, обозначаемое как up-sampling, переносит информацию на более подробный уровень.
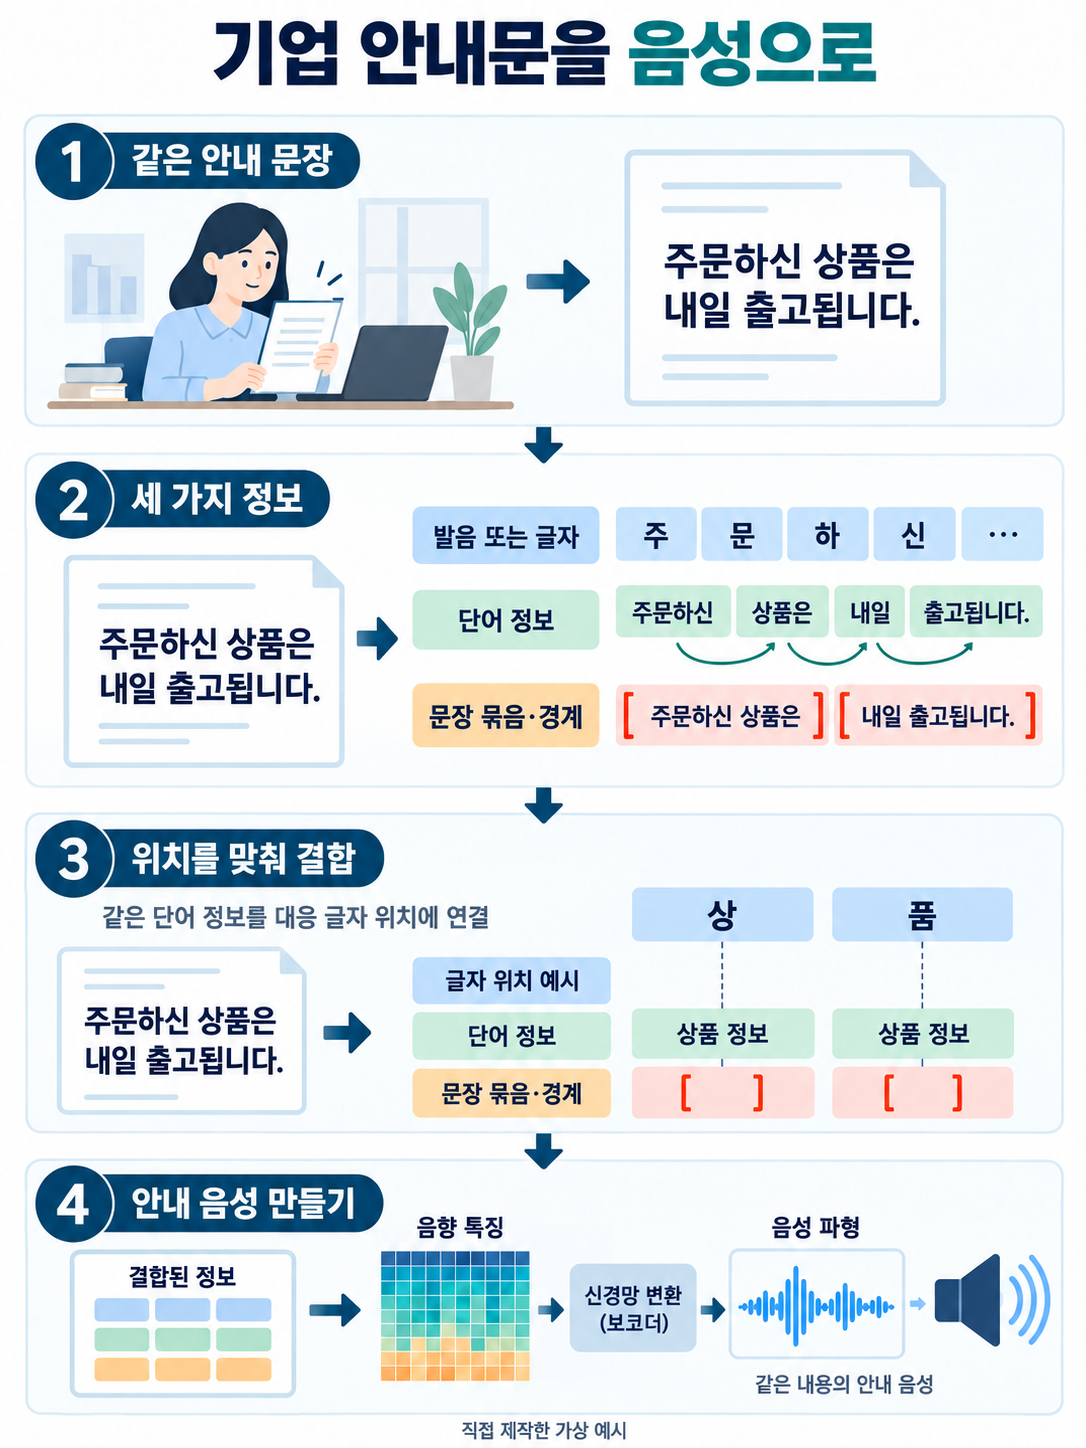
В упрощённом корейском примере из исходной статьи слово со значением «товар» записано двумя слоговыми блоками. Одна и та же информация о слове связывается с обеими позициями. Слово при этом не произносится дважды: каждая позиция получает доступ к признакам слова, которому она принадлежит.
На этом этапе согласуются текстовые представления. Длительность аудиозаписи и скорость её воспроизведения не меняются. Временная организация будущего речевого сигнала формируется на следующих этапах, после объединения информации из текста.
5. От объединённых признаков к речевому сигналу
Подготовленные данные поступают в кодировщик с несколькими входами. Кодировщик преобразует их в представления, удобные для последующих нейросетевых операций. В данном случае признаки текста формируются с использованием фонемной или символьной информации и контекста.
В описании предусмотрены разные точки объединения. Можно сначала обработать входы отдельными сетями и затем конкатенировать результаты либо объединить входные данные до обработки сетью. Поэтому архитектуры различаются не только составом информации, но и местом её соединения.
Механизм внимания и декодер связывают текстовые признаки с акустическими. Внимание помогает соотнести нужную часть текстовой информации с создаваемым звучанием. Это иная связь, чем предварительное сопоставление словесных признаков с позициями символов или фонем.
Акустические признаки представляют промежуточные характеристики звука, например его частотную структуру. Они ещё не являются конечным сигналом для воспроизведения. Вокодер использует эти признаки для получения звуковой волны, завершая путь от языковой информации к слышимой речи.
6. Условный пример уведомления об отправке
Интернет-магазин уже выбрал сообщение «Ваш заказ будет отправлен завтра». Именно эта фраза поступает на синтез. Проверка фактической даты отправки и достоверности уведомления выполняется отдельно от рассматриваемого процесса TTS.
Сначала подготавливается последовательность фонем или символов. Из того же предложения извлекаются сведения о словах, а грамматический разбор определяет их группировку. Это несколько представлений одного уведомления, а не три заново составленных сообщения.
Затем признаки слов и структуры предложения связываются с соответствующими позициями фонем или символов. Общая позиционная основа позволяет кодировщику обрабатывать небольшую единицу произношения вместе с информацией о её слове и грамматическом окружении.
Объединённые текстовые признаки преобразуются в акустические, после чего вокодер создаёт сигнал. Оператор может прослушать произношение имён и названий товаров и оценить понятность фразировки. Иллюстрация объясняет обработку, но не показывает реальный интерфейс Azure, аудиозапись или результаты измерения продукта.
7. Azure Speech и проектирование речевых сервисов
Сервис Microsoft Azure Speech предоставляет возможности преобразования текста в речь. Официальные материалы описывают нейронные голоса, синтез через SDK или REST API и средства создания аудиоконтента. Такие функции применимы к уведомлениям клиентов и озвучиванию документов.
Язык разметки синтеза речи SSML позволяет пользователю задавать структуру предложений, паузы, произношение, темп и высоту тона. Это управление выходным звучанием следует отличать от внутренней обработки слов и предложений в патенте. Продуктовая документация сама по себе не подтверждает использование Azure конкретной запатентованной архитектуры.
Для разработчиков существенны уровни входных данных и точки их объединения. Следует описать, получает ли модель символы или фонемы, добавляются ли обученные представления слов, как кодируется грамматика и каким образом согласуются последовательности разной длины.
Техническая документация будет содержательнее, если последовательно показать вход, промежуточное представление, согласование позиций, объединение, акустические признаки и формирование сигнала. Одной фразы «ИИ читает естественно» недостаточно для обозначения изменения обработки. Такой порядок помогает отличить улучшение произносительных данных от использования контекста.
Команда, которая хочет улучшить звучание, сохранив содержание уведомления, может начать с того, как информация о словах и предложении передаётся речевой модели. Конкретное описание промежуточных этапов между видимым текстом и слышимым результатом даёт основу для понимания технологии и рассмотрения связанных с ней патентных вопросов.
Сохранены исходные обозначения и формы; содержание раскрыто в тексте.
Связанная практика: патенты в области ИИ
Ознакомьтесь с практикой IPLEX в области патентования ИИ и обсудите технические особенности вашего речевого сервиса.
Исходная публикация в Tistory · Патентная публикация: US12094447B2
Related AI analyses: Патент Naver на перевод изображений: как совместить перевод с движущимся кадром · Как Baidu обрабатывает противоречия между ответом модели и найденными знаниями