
長い報告書の終わりまで読んだとき、冒頭の条件をどれだけ正確に思い出せるでしょうか。AIでも入力が長くなるほど、過去の情報を保持するコストと、必要な情報を取り出す精度の両立が難しくなります。Titansは、入力を読みながら独立したニューラルメモリを更新し、その記憶をアテンションと組み合わせる手法です。
構成の要点は、現在の内容を詳しく参照するアテンションと、過去の情報を重みに圧縮する学習型メモリの役割を分け、両者を接続することにあります。何を記憶するかに加え、記憶をどのように更新し、忘れ、利用するかが設計上の焦点となります。
1. 論文の基本情報と本稿の対象
対象論文は「Titans: Learning to Memorize at Test Time」です。著者はGoogle ResearchのAli Behrouz、Peilin Zhong、Vahab Mirrokniの3氏で、論文識別子はarXiv:2501.00663、arXiv DOIは10.48550/arXiv.2501.00663です。
本稿では、2024年12月31日に投稿された全27ページのarXiv v1を読み解きます。その後NeurIPS 2025に掲載されていますが、以下の構成、図番号、実験数値はすべてv1に基づきます。後の会議版に追加された実験結果とは区別しています。
v1はCC BY 4.0で公開されています。掲載図表の原著作者は上記3氏であり、各キャプションに原論文の図表番号を記載しています。
2. 長い入力を受け付けることと、長く記憶すること
通常のフルアテンションはトークン間の関係を細かく計算できますが、入力が長くなるほど比較量が大きくなります。一方、過去を限られた状態に圧縮する再帰型モデルは長い系列を効率よく処理できるものの、圧縮の過程で後から必要になる情報が弱まる可能性があります。入力ウィンドウを広げただけで、有効に記憶できる範囲も広がるとは限りません。
原文をすべて机に広げれば詳しく比較できますが、多くのスペースが必要です。要約ノートだけを残せば机は片付きますが、細かな条件を失いかねません。Titansは、現在読んでいる部分と、読み進めながら書き換えるノートを併用する構成に相当します。ただし、そのノートは人が読む文章ではなく、ニューラルネットワークの重みです。
3. メモリが学習するとは何を意味するか
入力からキーと値を生成し、メモリにキーを与えたときに対応する値を復元できるよう学習させます。損失は復元値と目標値の二乗誤差であり、原論文の式12では‖M(k)−v‖²と表されます。この誤差を減らすようにメモリの重みを更新することで、過去の入力に含まれる対応関係を重みに反映します。
推論中にも更新されるのは、このニューラルメモリです。キーと値を生成する変換や構成全体を学習する外側の過程と、メモリを調整する内側の過程は区別されます。入力のたびに巨大なモデル全体を一から学習し直すわけではありません。記憶を読み出す際にはクエリをメモリに入力する順伝播を用い、読み出し自体では重みを更新しません。
記憶を更新する信号は、著者らが「驚き」と呼ぶ損失の勾配です。これに直近の更新方向を引き継ぐモメンタムを加え、驚きの大きい出来事に続く関連情報も反映しやすくします。さらに、入力に応じた忘却係数で従前の重みをどれだけ残すかを調整します。新しい内容を加えるだけでなく、古い状態の影響も減らす仕組みです。
ここでいう驚きは最適化のための信号です。重要な事実、正しい情報、必ず保存すべき記録を認定する指標ではありません。予測誤差が大きいことと、業務上重要であることは別の評価です。
4. MAC:過去の記憶を現在の文脈に組み込む
最初の結合方式はMAC(Memory as a Context)です。長い入力を一定の区間に分け、現在の区間をクエリとして長期メモリから関連する表現を読み出します。持続的メモリ、読み出した長期記憶、現在の区間を順に連結してアテンションへ渡すことで、現在の内容と過去の表現を同じ場で参照できるようにします。
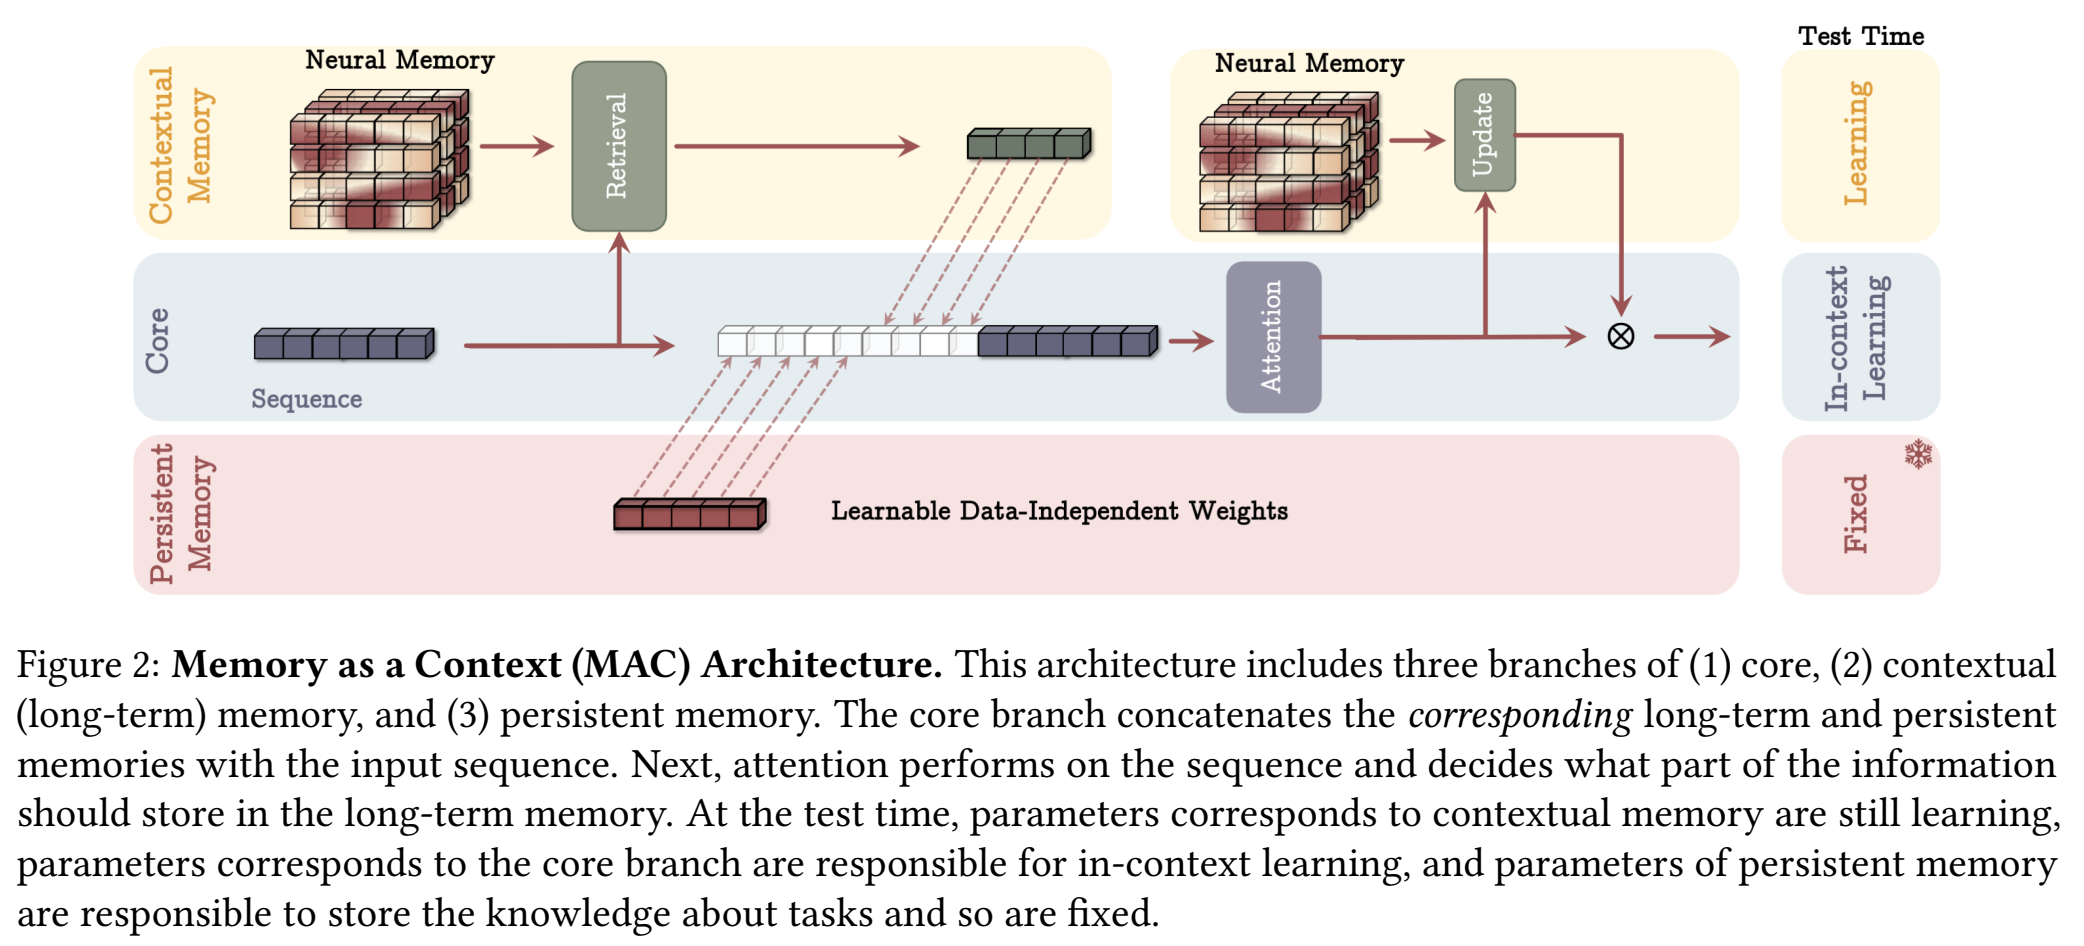
処理の流れは、過去の記憶を読み出し、現在の区間と結合し、アテンションを計算し、その結果で長期メモリを更新する、という順序です。原論文ではアテンションの出力をメモリの更新に使い、最終出力にもメモリを組み合わせます。ノートを開いてから新しい文書を読み、その結果を基にノートを書き換える手順に近いと捉えられます。
3種類の記憶は役割が異なります。アテンションは現在の区間内の細かな関係を扱い、長期メモリは入力に応じて更新されます。持続的メモリは学習によって得られる入力非依存のパラメータで、テスト時には固定されます。ここでの「持続的」は、利用者の会話を無期限に保存するサービス機能を指すものではありません。
5. MAGとMAL:接続方法による違い
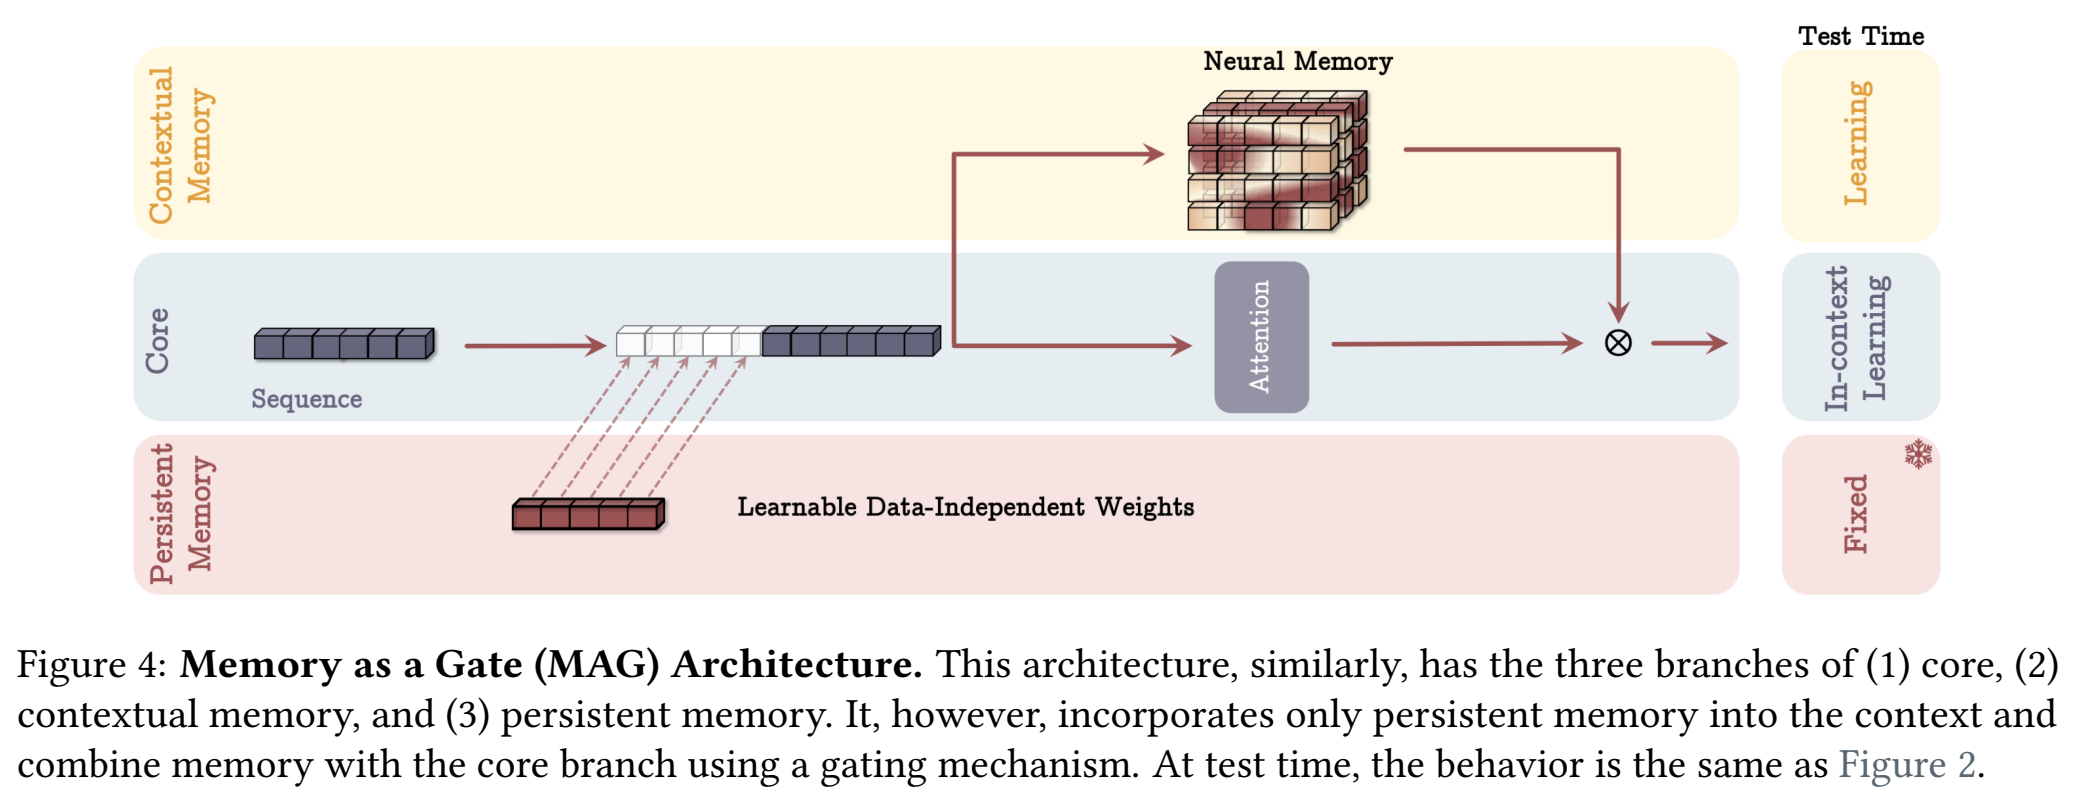
MAGはメモリとスライディングウィンドウ・アテンションを並列に置き、両者の出力をゲートで結合します。最近の区間を詳しく見る経路と、遠い過去を圧縮して保持する経路を併用する構成です。読み出した記憶を現在の区間に前置するMACとは、情報が合流する位置が異なります。
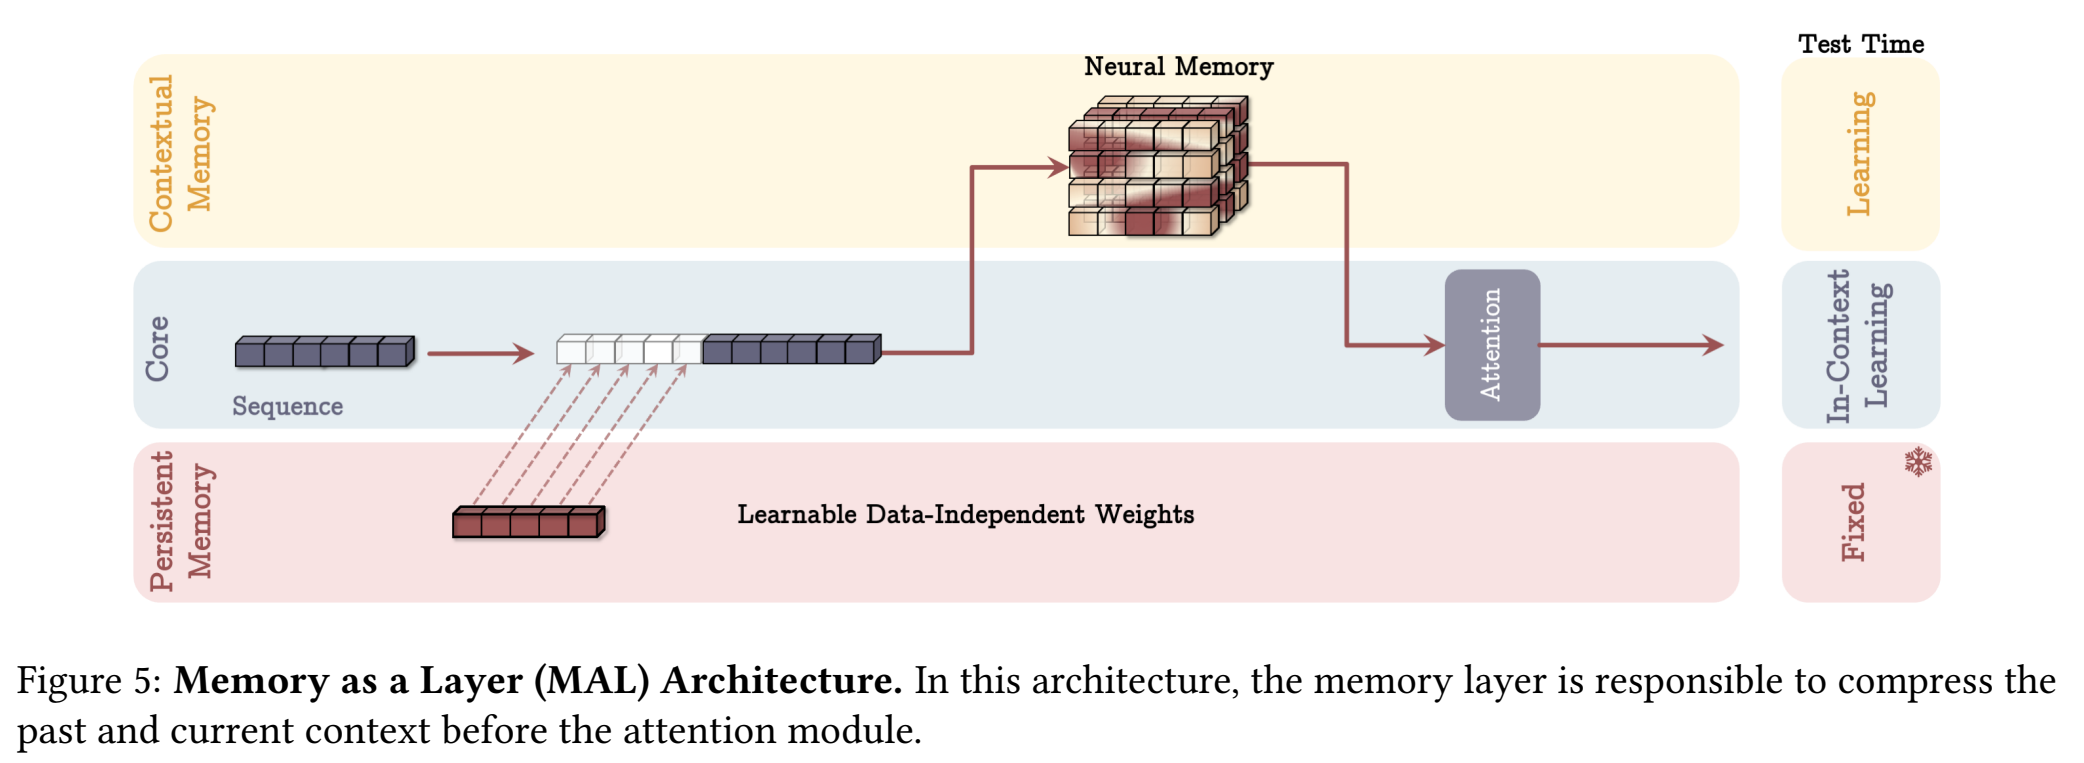
MAL(Memory as a Layer)は、メモリの後にアテンションを直列に配置します。先に圧縮した表現を次の層が処理する構成です。著者らは、各層の能力が処理全体の制約となり、アテンションとメモリの相補的な働きを十分に利用しにくいと説明しています。接続の簡潔さと情報伝達上の制約を併せて見る必要があります。
論文中のLMMは、アテンションと組み合わせずに長期メモリモジュールだけを使用したモデルです。LMMと3種類の結合型を分けて比較することで、メモリそのものの効果と接続方法の効果を区別できます。
6. モデル規模と実験条件
v1の主な言語モデル実験では、170M、340M、400M、760Mパラメータの規模を設定しています。最初の3規模はFineWeb-Eduの150億トークン、760Mモデルは300億トークンで学習しています。主要な比較表であるTable 1には340M、400M、760Mの結果が掲載されています。数値は、同じパラメータ数と学習トークン数の区分内で比較する必要があります。
学習時の系列長は4,096トークンで、Llama 2トークナイザの32K語彙を使用しています。基本条件はAdamW、学習率0.0004、コサイン型の学習率スケジュール、50万トークンのバッチ、重み減衰0.1です。比較対象にはTransformer++、Mamba系、DeltaNet系、TTT、アテンションを組み込んだモデルなどが含まれます。
7. 言語モデルの結果:平均値と個別指標
760M・300億トークンの条件では、Table 1のAvg列はTransformer++が48.69、Gated DeltaNetが49.69、Sambaが51.08、Gated DeltaNet-H2が51.49です。Titansの結果はLMMが51.56、MACが52.51、MAGが52.50、MALが50.97でした。この条件ではMACとMAGの平均値は近い一方、MALは一部の比較モデルを下回ります。3方式が常にすべて優れると読むことはできません。
同じ条件のWiki. perplexityは、MACが19.93、MAGが18.61、MALが19.07、Gated DeltaNet-H2が19.88です。パープレキシティは低いほどよい指標であり、Avgがわずかに高いMACがこの指標でも最良とは限りません。平均正解率と、言語予測に関する不確実性の指標を分けて確認することで、構成ごとの特徴が見えてきます。
400M・150億トークンでもAvgはMACが48.65、MAGが48.60と近い値です。ただし、これは表に掲載された評価課題の結果であり、モデルの全能力を代表する点数ではありません。商用の大規模言語モデル全般に優越するという結論に広げる根拠にもなりません。
8. 長い文脈から必要な情報を取り出す能力
RULERのS-NIAHは、長い妨害文の中から特定の情報を取り出す課題です。原論文のTable 2では、PK、N、Wの3課題を2K、4K、8K、16Kの長さで評価しています。長文を入力できるかだけでなく、その中の情報を実際に回収できるかを調べる実験です。
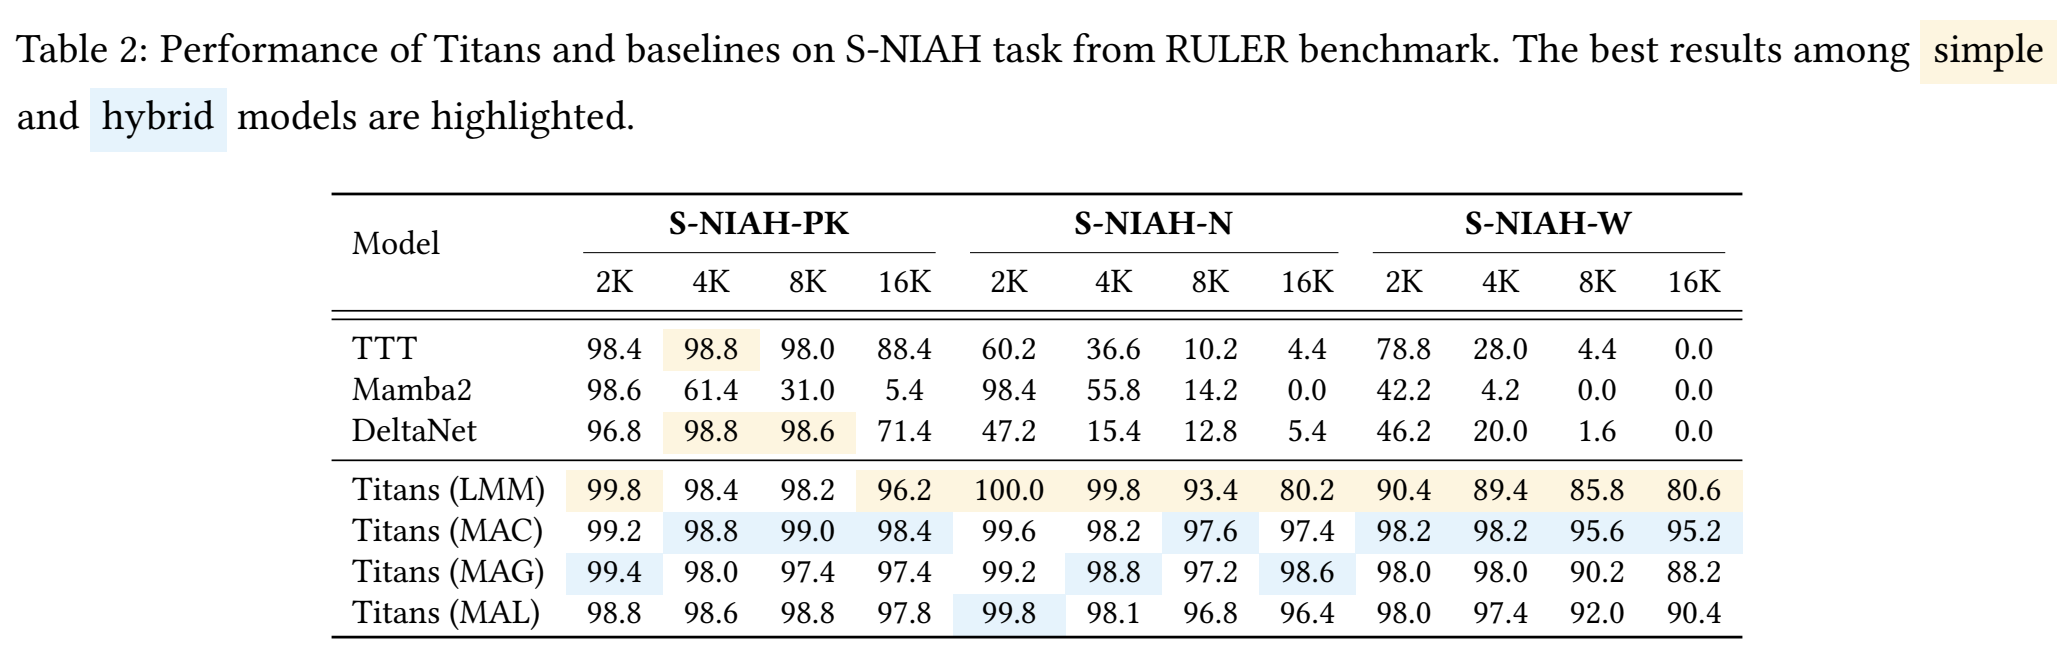
16KにおけるMACのPK、N、Wの得点は、それぞれ98.4、97.4、95.2でした。LMMは96.2、80.2、80.6、TTTは88.4、4.4、0.0です。MACは3課題で高い値を示すものの、NではMAGの98.6がMACの97.4を上回ります。特定の構成がすべての欄で最高値を得たわけではありません。
別のBABILong実験では、長い文書に分散した事実を結び付ける能力を評価しています。著者らはその結果を基に、200万トークンを超える文脈への拡張を報告しています。ただし、few-shotとファインチューニングの設定、モデル規模、RAGの利用条件が異なります。同条件でGPT-4の一般的な性能を上回った、あるいはあらゆる長文書業務で成功するという意味ではありません。
9. メモリの深さ、計算コスト、適用範囲
メモリは単一の行列だけでなく、複数層のMLPでも構成できます。著者らは深さを1~4層に変え、深いメモリほど良好なパープレキシティを示す一方、学習スループットは低下する傾向を報告しています。これはPileの一部データを使ったメモリモジュール単体の評価であり、Titansの結合型全体の計算コストとそのまま同一視することはできません。
更新を1トークンずつ逐次実行すると、ハードウェアの能力を十分に利用しにくくなります。論文では、チャンク単位の勾配計算を行列演算として構成し、モメンタム計算の並列性も利用します。すべての非線形更新を無条件に一度の並列演算で処理できるという主張ではありません。実測のスループットについては、メモリモジュールがMamba2やGated DeltaNetよりやや遅いとの説明もあります。
この方式は過去の対応関係を圧縮して利用する技術です。原文を正確に保存して出典を返すデータベースとは目的が異なり、記憶の更新だけで事実確認や安全な削除まで保証されるわけではありません。v1の言語モデル実験は最大760M規模であるため、より大きなモデルや実務への適用では、その範囲を区別して考える必要があります。
10. 弁理士の視点:構成と実証された効果
技術的課題は、限られた計算資源と記憶資源で遠い過去の情報を利用することです。その手段は、キーと値の対応を学ぶニューラルメモリ、直近の更新を引き継ぐモメンタム、従前の状態を残す程度を調整する忘却、そしてアテンションとの結合です。単に記憶機能を追加したと説明するよりも、どの情報をどの経路で読み出し、更新するかを捉える方が構成を正確に表せます。
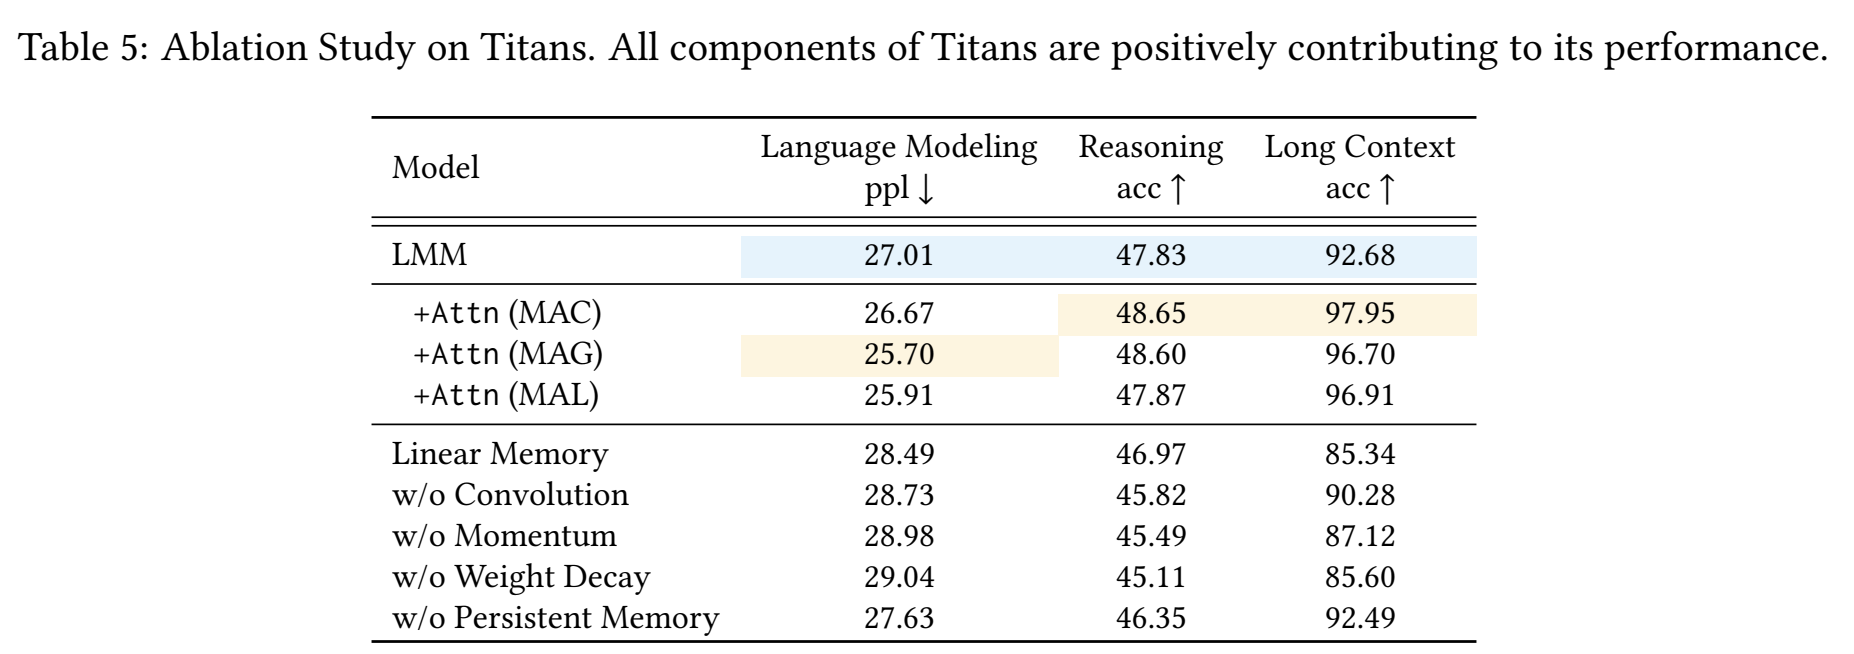
Table 5で基準となるLMMのLong Context得点は92.68です。モメンタムを除くと87.12、重み減衰を除くと85.60、深いメモリを線形メモリに置き換えると85.34でした。これは当該実験で各構成が寄与したことを示す結果です。同表のLanguage Modelingのパープレキシティを、Table 1のWiki.列と同じ指標として扱ってはなりません。
同じ表で、アテンションを組み合わせた場合のLong Context得点はMACが97.95、MAGが96.70、MALが96.91です。技術を検討する際には、メモリの有無に加え、過去の記憶を直接文脈として渡すのか、並列経路の出力を結合するのか、圧縮後にアテンションで処理するのかという接続関係が重要になります。これは論文に示された構成と実験上の効果についての技術的な考察です。
11. まとめ
Titansの要点は、長い入力をすべて展開して参照する代わりに、読み進める間に更新されるニューラルメモリと、細かな関係を捉えるアテンションを組み合わせることです。驚きに基づく更新、直近の更新方向の継承、忘却、3種類の接続方式が一つの記憶システムを構成します。v1の実験は、これらが情報回収や言語モデル評価に寄与し得ることを示しています。
一方、よく記憶できることは、原文をすべて正確に保存することと同義ではありません。モデル規模、学習量、文脈に関する課題、計算コストを併せて読むことで、結果の意味が明確になります。TitansはAIの記憶を単なる保存容量ではなく、何を更新し、どの経路で利用するかという設計上の問題として捉える研究です。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
本稿の数値と構造の説明は、全27ページのarXiv v1に基づきます。後続の学会版や商用製品の性能・実装と同一であるとみなすものではありません。
分析対象:Titans、arXiv v1(2024年12月31日)
アイピーレックスのAI技術・特許に関する検討業務をご覧ください。