
读到一份厚报告的最后一页时,我们还能多准确地记起开头的条件?AI同样面临这一难题:输入越长,保留历史信息的成本与准确提取所需内容之间的矛盾越突出。Titans提出在读取输入的同时更新独立的神经记忆模块,再将记忆与注意力机制结合。
这一架构将两种职责分开处理:注意力用于细看当前内容,可学习记忆则将过去的信息压缩到权重中,再让二者协同工作。关键不仅在于记住什么,还在于如何更新、遗忘和使用这些记忆。
1. 论文信息与本文分析范围
本文讨论的论文为《Titans: Learning to Memorize at Test Time》,作者是Google Research的Ali Behrouz、Peilin Zhong和Vahab Mirrokni。论文编号为arXiv:2501.00663,arXiv DOI为10.48550/arXiv.2501.00663。
此次阅读的是2024年12月31日提交、共27页的arXiv v1。该研究后来发表于NeurIPS 2025,但下文的结构说明、图号和实验数值均以v1为准,不将后续会议版本新增的实验混入初稿结果。
分析所依据的v1采用CC BY 4.0许可。文中图表的原作者为上述三位研究人员,各图注均标明原论文中的编号。
2. 能接收长输入,不等于能长期记住信息
常规完全注意力可以细致计算词元之间的关系,但输入越长,需要比较的关系就越多。循环模型则将历史压缩为有限的状态,能够较高效地处理长序列,却可能在压缩过程中削弱稍后才需要的信息。因此,扩大输入窗口本身并不意味着有效记忆范围也随之扩大。
把原文全部摊在桌面上,便于逐项对照,却需要更大空间;只保留摘要笔记,可以减轻负担,却可能丢失细节条件。Titans相当于同时使用当前正在阅读的内容和不断修订的笔记。不过,这里的笔记不是供人阅读的文字,而是神经网络的权重。
3. 让记忆学习,具体更新的是什么
研究人员从输入生成键和值,训练记忆模块,使其接收一个键时能够恢复对应的值。损失是恢复值与目标值之间的平方误差,在原论文公式12中写作‖M(k)−v‖²。沿着减小误差的方向更新记忆权重,就能将历史输入中的关联写入权重。
推理时继续更新的是这一神经记忆模块。学习键值变换及整体架构的外层过程,与调整记忆的内层过程需要区分。这并不意味着每接收一次输入,就把整个大型模型从头重新训练一遍。读取记忆时,将查询送入记忆模块执行前向传播;读取操作本身不更新权重。
更新记忆的信号是损失梯度,作者将其称为“惊讶度”。在此基础上加入动量,保留近期的更新方向,使模型也能吸收紧随高惊讶事件出现的相关信息。另一个依赖输入的遗忘系数控制旧权重的保留程度。因此,该模块既写入新内容,也减弱旧状态的影响。
这里的惊讶度是一种优化信号,并不能认证某条信息重要、真实或必须保存。预测误差大与业务价值高,是两种不同的判断。
4. MAC:把历史记忆引入当前上下文
第一种结合方式是MAC,即Memory as a Context。模型先把长输入划分为固定长度的片段,将当前片段作为查询,从长期记忆中读取相关表示,再依次拼接持久记忆、读取到的长期记忆和当前片段,交给注意力模块。这样,注意力就能在同一上下文中处理当前内容与历史表示。
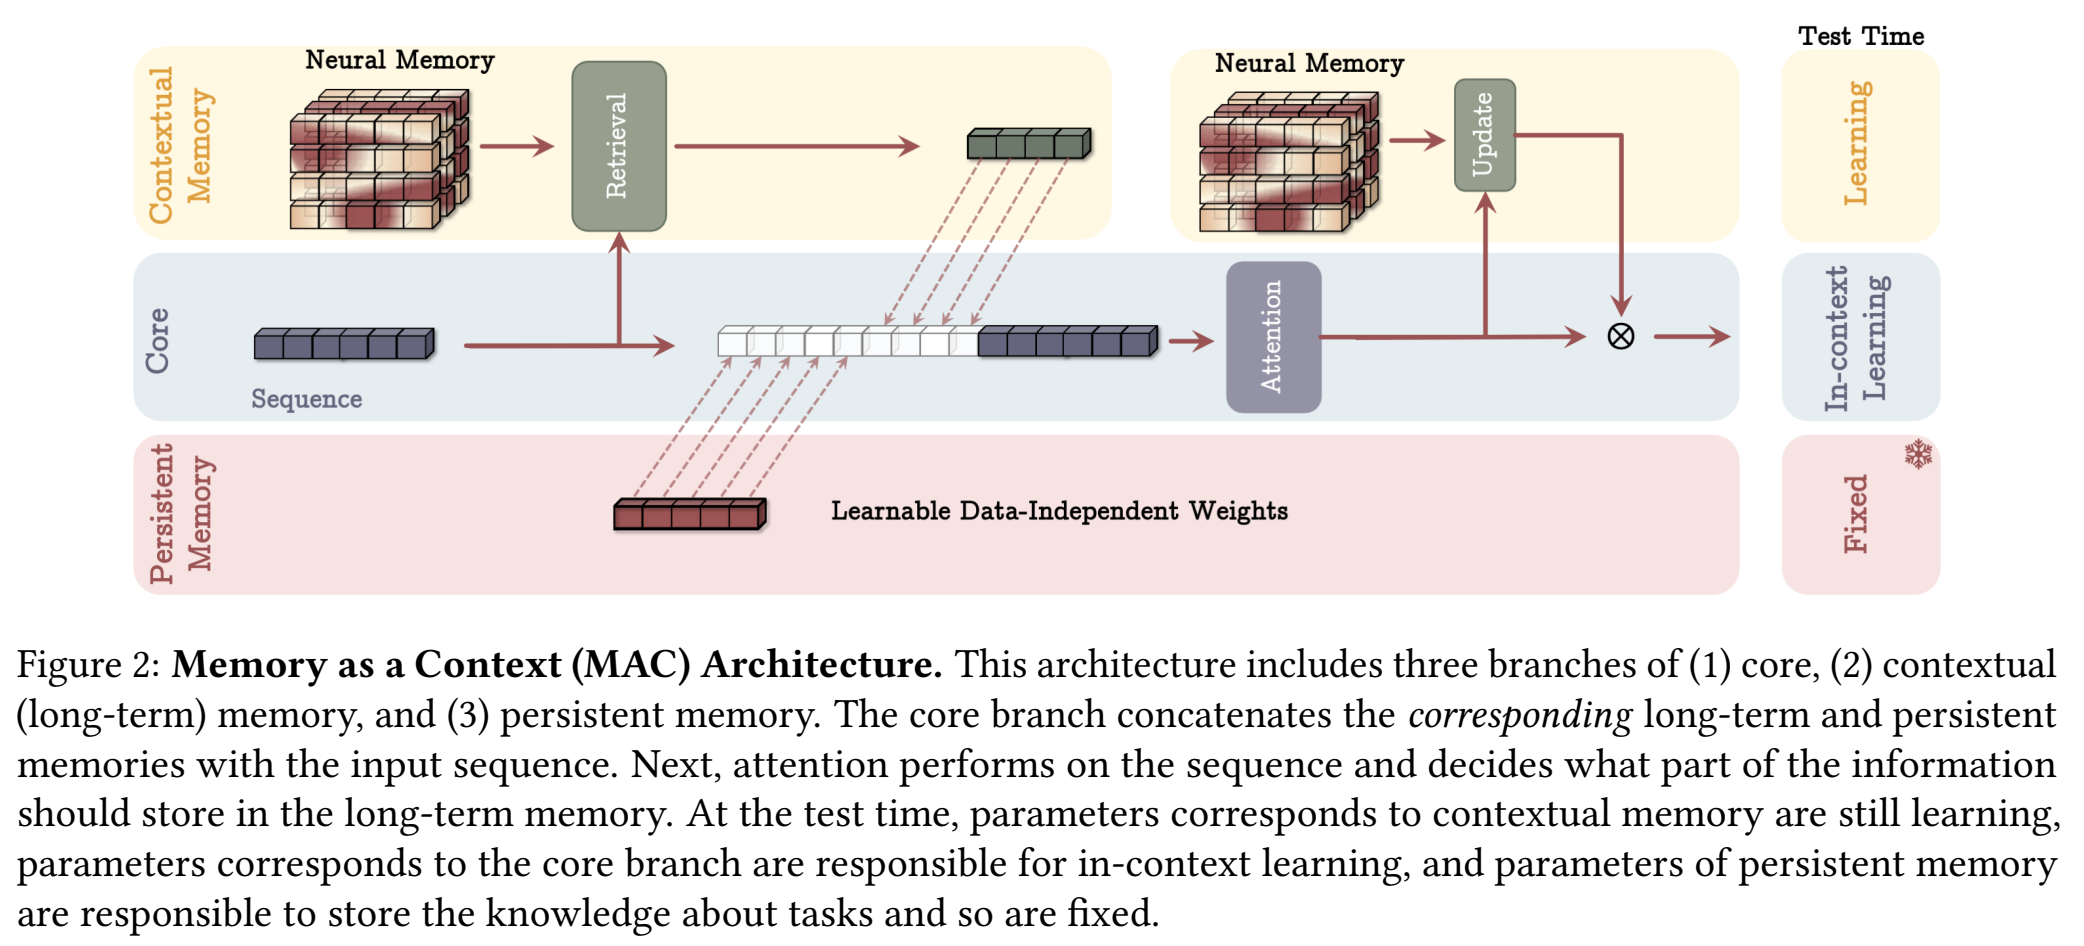
其处理顺序可以理解为:读取历史记忆、与当前片段结合、计算注意力、更新长期记忆。原论文使用注意力输出来更新记忆,并在最终输出中再次结合记忆。从工作流程看,这类似于先翻开笔记,再阅读新文档,最后依据阅读结果修订笔记。
三类记忆承担不同职责。注意力处理当前片段内部的细致关系,长期记忆随输入持续更新;持久记忆则是训练得到、与输入无关的参数,在测试时保持固定。这里的“持久”不表示某项服务会无限期保存用户对话。
5. MAG与MAL:连接方式决定信息如何汇合
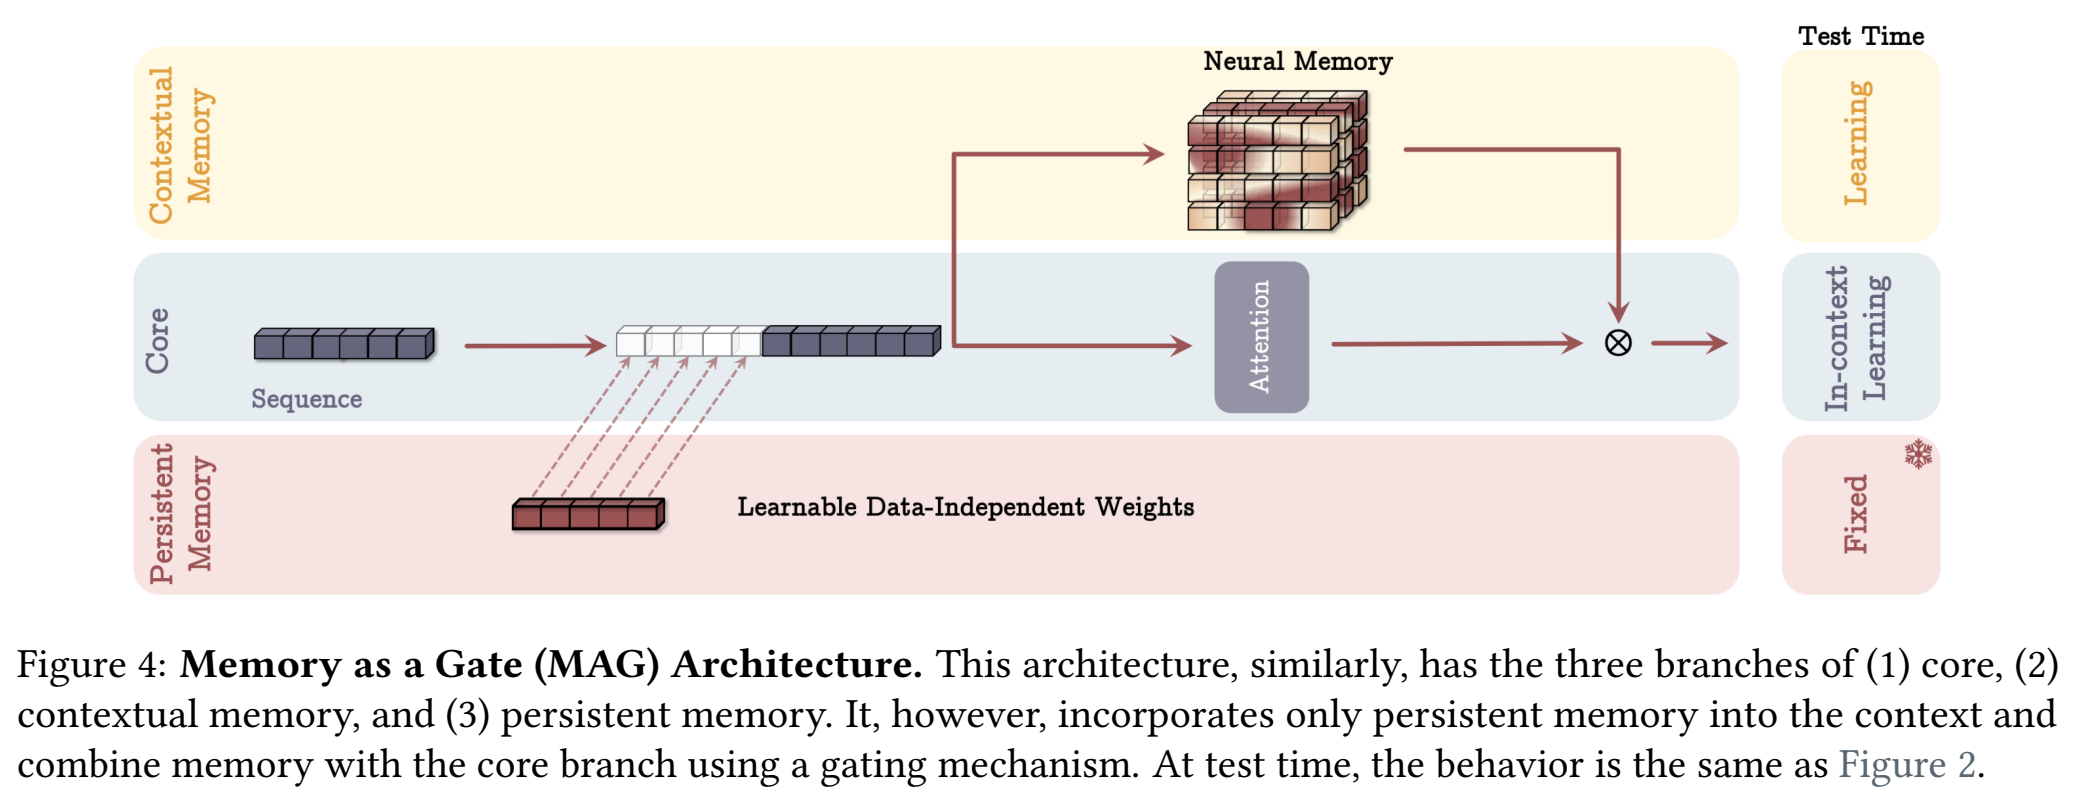
MAG将记忆与滑动窗口注意力并列配置,通过门控机制融合两路输出。一条路径细看最近的片段,另一条路径利用压缩后的较远历史。与MAC把读取到的记忆放在当前片段之前不同,MAG让信息在输出端汇合。
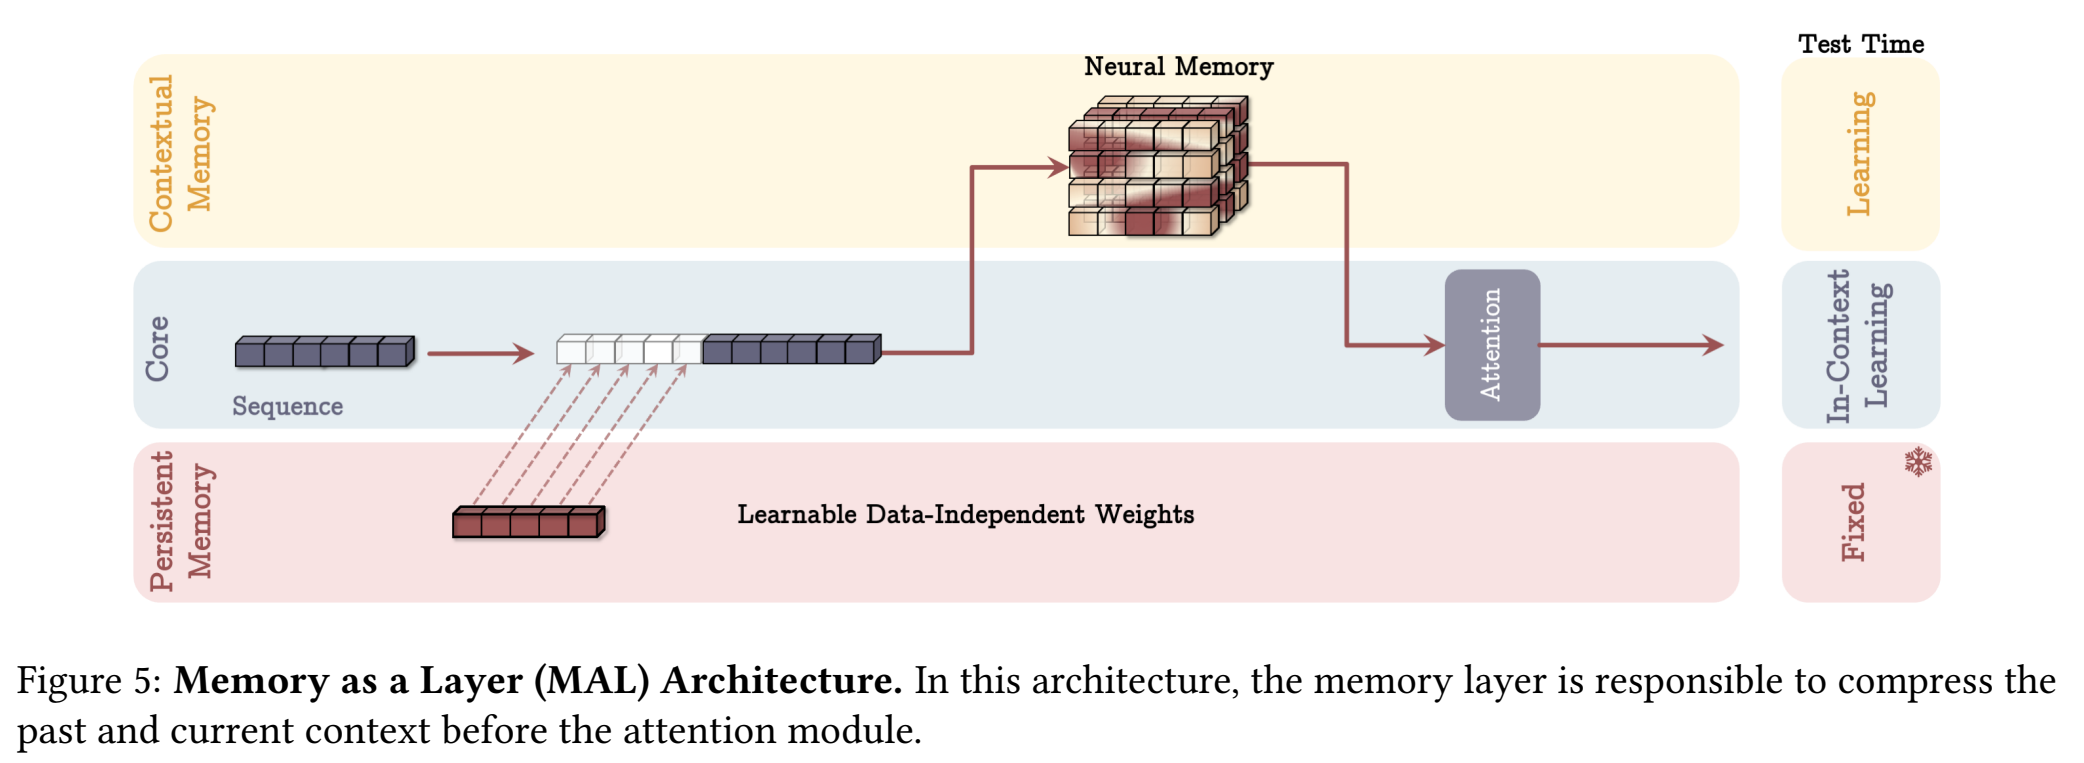
MAL,即Memory as a Layer,将记忆模块放在注意力之前,采用串行连接。记忆先生成压缩表示,再交给下一层处理。作者指出,这种结构会受各层自身能力的制约,难以充分发挥注意力与神经记忆处理方式的互补作用。因此,需要同时考虑连接简洁的优点与信息传递的限制。
论文中的LMM是单独使用长期记忆模块、不与注意力结合的模型。将LMM与三种混合架构分别比较,才能区分记忆本身的作用和连接方式的作用。
6. 实验的模型规模和训练条件
v1的主要语言模型实验设置了170M、340M、400M和760M参数规模。前三种规模使用FineWeb-Edu的150亿词元训练,760M模型使用300亿词元训练。主要对比表Table 1列出了340M、400M和760M的结果。比较数值时,应在参数数量和训练词元数量相同的分组内进行。
训练序列长度为4,096词元,使用Llama 2分词器及32K词表。基本设置包括AdamW、0.0004学习率、余弦学习率调度、50万词元的批次和0.1权重衰减。对比模型包括Transformer++、Mamba系列、DeltaNet系列、TTT,以及结合了注意力的模型。
7. 语言模型结果:分别看平均值与单项指标
在760M参数、300亿训练词元的条件下,Table 1的Avg列中,Transformer++为48.69,Gated DeltaNet为49.69,Samba为51.08,Gated DeltaNet-H2为51.49。Titans的LMM为51.56,MAC为52.51,MAG为52.50,MAL为50.97。MAC和MAG的平均值接近,但MAL低于部分对比模型,不能据此说三种变体始终全面领先。
同一条件下,Wiki.困惑度分别为MAC 19.93、MAG 18.61、MAL 19.07,Gated DeltaNet-H2则为19.88。困惑度越低越好,因此Avg略高的MAC并非在该指标上也最好。将平均准确率与反映语言预测不确定性的指标分开考察,才能看清不同架构的特点。
在400M参数、150亿训练词元的条件下,MAC和MAG的Avg分别为48.65和48.60,也十分接近。但这些数值只反映表中评测任务的结果,不能代表模型的全部能力,更不能扩大解释为对所有商用大语言模型的优势。
8. 从长上下文中提取所需信息
RULER的S-NIAH要求模型从大量干扰文本中找出指定信息。原论文Table 2在2K、4K、8K和16K长度下,评测了PK、N、W三项子任务。它考察的不只是模型能否接收长文档,还包括能否真正取回其中的信息。
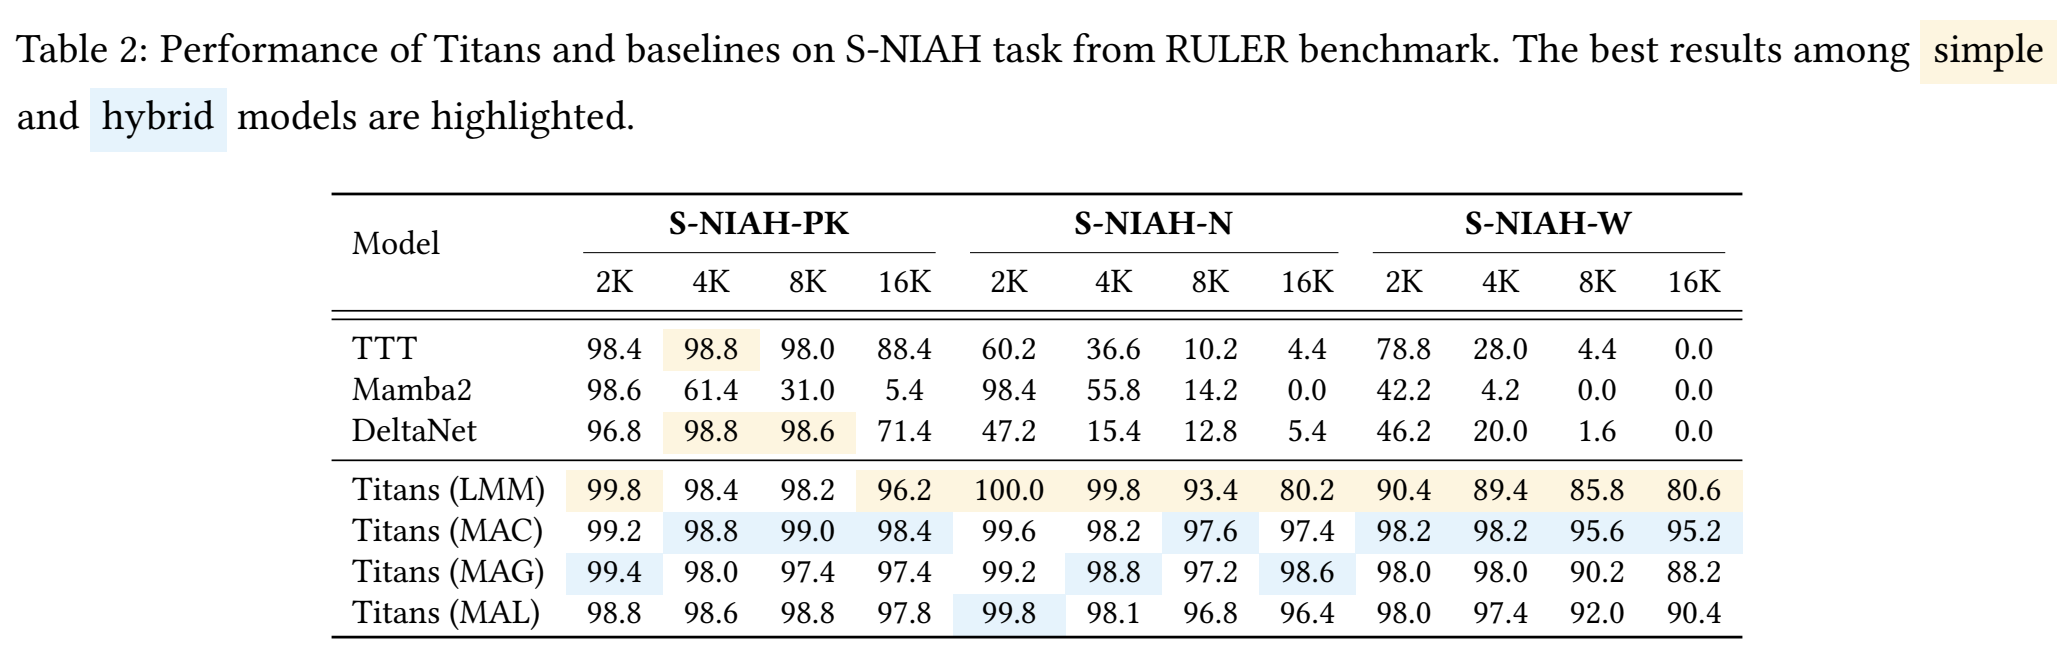
在16K长度下,MAC的PK、N、W得分分别为98.4、97.4、95.2;LMM为96.2、80.2、80.6;TTT为88.4、4.4、0.0。MAC在三项任务中均表现较高,但在N任务上,MAG的98.6仍高于MAC的97.4,并非一种架构占据了每一项的最高值。
另一组BABILong实验考察连接分散在长文档中的事实的能力。作者据此报告了向超过200万词元上下文扩展的结果。但实验涉及少样本学习与微调等不同设置,也存在模型规模和RAG使用条件的差异,不能将其解释为同等条件下全面优于GPT-4,或保证所有长文档业务都能成功。
9. 记忆深度、计算成本与适用边界
记忆不仅可以是一张矩阵,也可以由多层MLP构成。作者将记忆深度设置为1至4层,观察到更深的记忆通常具有更好的困惑度,但训练吞吐量会下降。这项实验使用Pile的部分数据评估记忆模块本身,不能直接把其成本等同于完整Titans混合架构的成本。
如果逐词元串行执行更新,就难以充分利用硬件。论文将分块梯度计算组织为矩阵运算,并利用动量计算的并行性。这不意味着所有非线性更新都能无条件地用一次并行运算完成。关于实际吞吐量,作者也说明记忆模块略慢于Mamba2和Gated DeltaNet。
该方法将历史关联压缩后加以利用,与精确保留原文、返回来源的数据库承担不同任务。更新记忆本身并不保证事实正确或安全删除。将v1中最大760M规模的语言模型实验推广至更大模型或实际业务时,应清楚区分这些适用范围。
10. 从专利实务角度看技术构成与实验证据
这项技术要解决的问题,是在计算和记忆资源有限的条件下利用久远的历史信息。相应手段包括学习键值关联的神经记忆、延续近期更新方向的动量、控制旧状态保留程度的遗忘机制,以及与注意力的结合。与笼统地称其为“增加记忆功能”相比,说明信息经由哪条路径被读取和更新,更有助于准确描述技术构成。
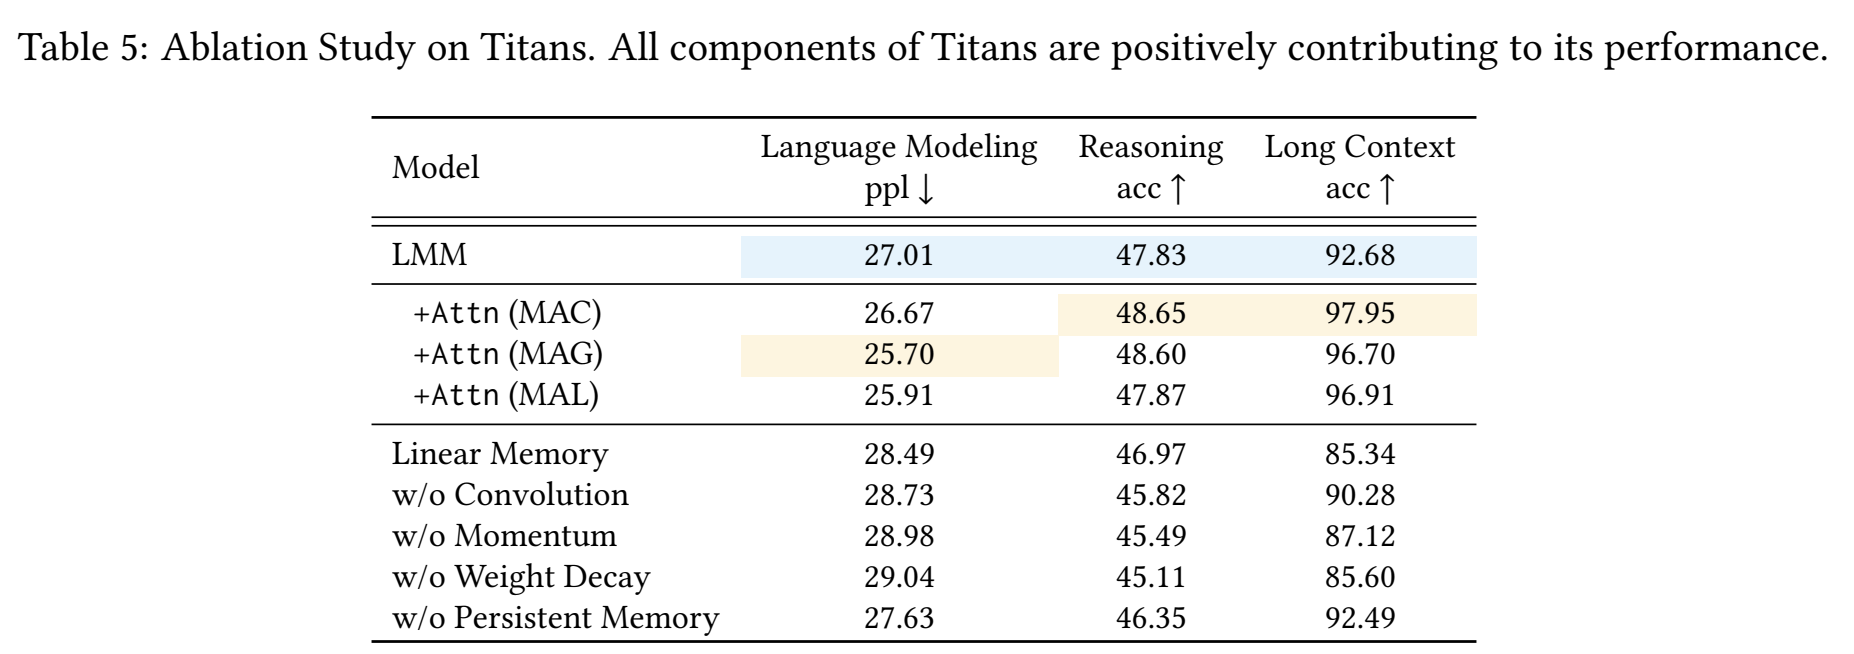
在Table 5中,基准LMM的Long Context得分为92.68;去掉动量后为87.12,去掉权重衰减后为85.60,将深层记忆替换为线性记忆后为85.34。这些结果支持各构成在该实验中有所贡献。需要注意,同表Language Modeling栏的困惑度不能自行视为与Table 1的Wiki.栏相同的指标。
同表中,结合注意力后的Long Context得分分别为MAC 97.95、MAG 96.70、MAL 96.91。从技术分析角度看,除了是否具有记忆模块,还要考察历史记忆是直接成为注意力的上下文、与并行路径的输出融合,还是先压缩后再由注意力处理。这里讨论的是论文披露的连接关系及相应实验效果。
11. 结语
Titans的核心在于,将读取过程中不断更新的神经记忆,与处理细致关系的注意力共同使用,而不是一味展开全部长输入。基于惊讶度的更新、近期更新方向的延续、遗忘以及三种连接方式,共同构成其记忆系统。v1实验表明,这些设计有助于信息提取和语言模型评测。
不过,记忆效果良好不等于精确保留全部原文。结合模型规模、训练量、上下文任务和计算成本,才能准确理解结果。Titans促使我们把AI记忆视为“更新什么、通过何种路径使用”的设计问题,而不只是增加存储容量。
图中保留原始标注与形态,相关内容在正文中说明。
本文的数值和结构说明以27页的arXiv v1为依据,不将其与后续会议版本或商业产品的性能、实现方式等同。
分析版本:Titans,arXiv v1(2024年12月31日)
了解IPLEX的人工智能技术与专利分析服务。