
Disponer de una ventana de contexto extensa no garantiza que un sistema de IA conserve y utilice correctamente toda la información previa. Titans aborda ese problema actualizando una memoria neuronal específica mientras procesa nuevas entradas, junto con la atención al contexto actual.
Este análisis se basa en la primera versión de arXiv de «Titans: Learning to Memorize at Test Time». Examina qué parámetros cambian, cómo interactúan memoria y atención y qué permiten concluir los experimentos, conservando los diagramas y tablas originales.
Documento y versión analizados
Los autores son Ali Behrouz, Peilin Zhong y Vahab Mirrokni, de Google Research. El identificador es arXiv:2501.00663 y el DOI, 10.48550/arXiv.2501.00663. La versión v1 analizada se presentó el 31 de diciembre de 2024 y tiene 27 páginas.
Existe una publicación posterior en NeurIPS 2025. Aquí se diferencia ese registro posterior del texto v1: las descripciones de la arquitectura, figuras y cifras siguientes corresponden a v1, sin combinarlas tácitamente con versiones posteriores.
La v1 se publicó con licencia CC BY 4.0. Los tres investigadores son los autores originales de sus diagramas y tablas; los pies identifican el número de figura o tabla del documento de origen.
Una ventana mayor no resuelve por sí sola la memoria
La atención completa modela relaciones directas entre tokens, pero su coste computacional y de memoria aumenta considerablemente con la longitud del contexto. Los modelos recurrentes comprimen el pasado en un estado de tamaño fijo, ganando escalabilidad a costa de posibles pérdidas. Admitir una secuencia larga y aprovechar sus hechos anteriores son capacidades distintas.
Puede pensarse en una mesa para el trabajo actual y unas notas para la información previa. En Titans, esas «notas» son asociaciones codificadas en los pesos de una red, no una transcripción legible ni un archivo documental convencional. La atención de corto plazo y la memoria neuronal de largo plazo cumplen funciones diferentes.
Aprender asociaciones durante la inferencia
La memoria asocia una clave k con un valor v. La ecuación 12 utiliza el error cuadrático ‖M(k) − v‖². En el bucle interno cambian los pesos de la memoria M; las proyecciones que generan claves y valores y los demás parámetros se aprenden en el entrenamiento externo. No se vuelve a entrenar íntegramente un gran modelo de lenguaje por cada fragmento recibido.
El gradiente de esa función de pérdida actúa como señal de «sorpresa». Una asociación que la memoria representa mal puede provocar una actualización mayor. La sorpresa es aquí una magnitud de optimización, no una certificación de veracidad ni de importancia para el usuario.
El momento conserva el efecto de sorpresas recientes, mientras un coeficiente de olvido dependiente de la entrada regula cuánto se mantiene de la memoria anterior. Se combinan el gradiente actual, la huella de actualizaciones previas y el decaimiento adaptativo, en lugar de acumular indefinidamente cada dato.
La recuperación es una operación distinta: una consulta atraviesa la memoria mediante una pasada hacia delante sin actualizar los pesos. Separar la escritura de la lectura permite entender qué sigue aprendiendo durante la inferencia.
MAC: la memoria como parte del contexto
Memory as a Context (MAC) divide la entrada en segmentos. El segmento actual consulta la memoria de largo plazo; la información recuperada se concatena con los tokens de memoria persistente y el segmento actual antes de aplicar atención. La figura 2 representa estas ramas.
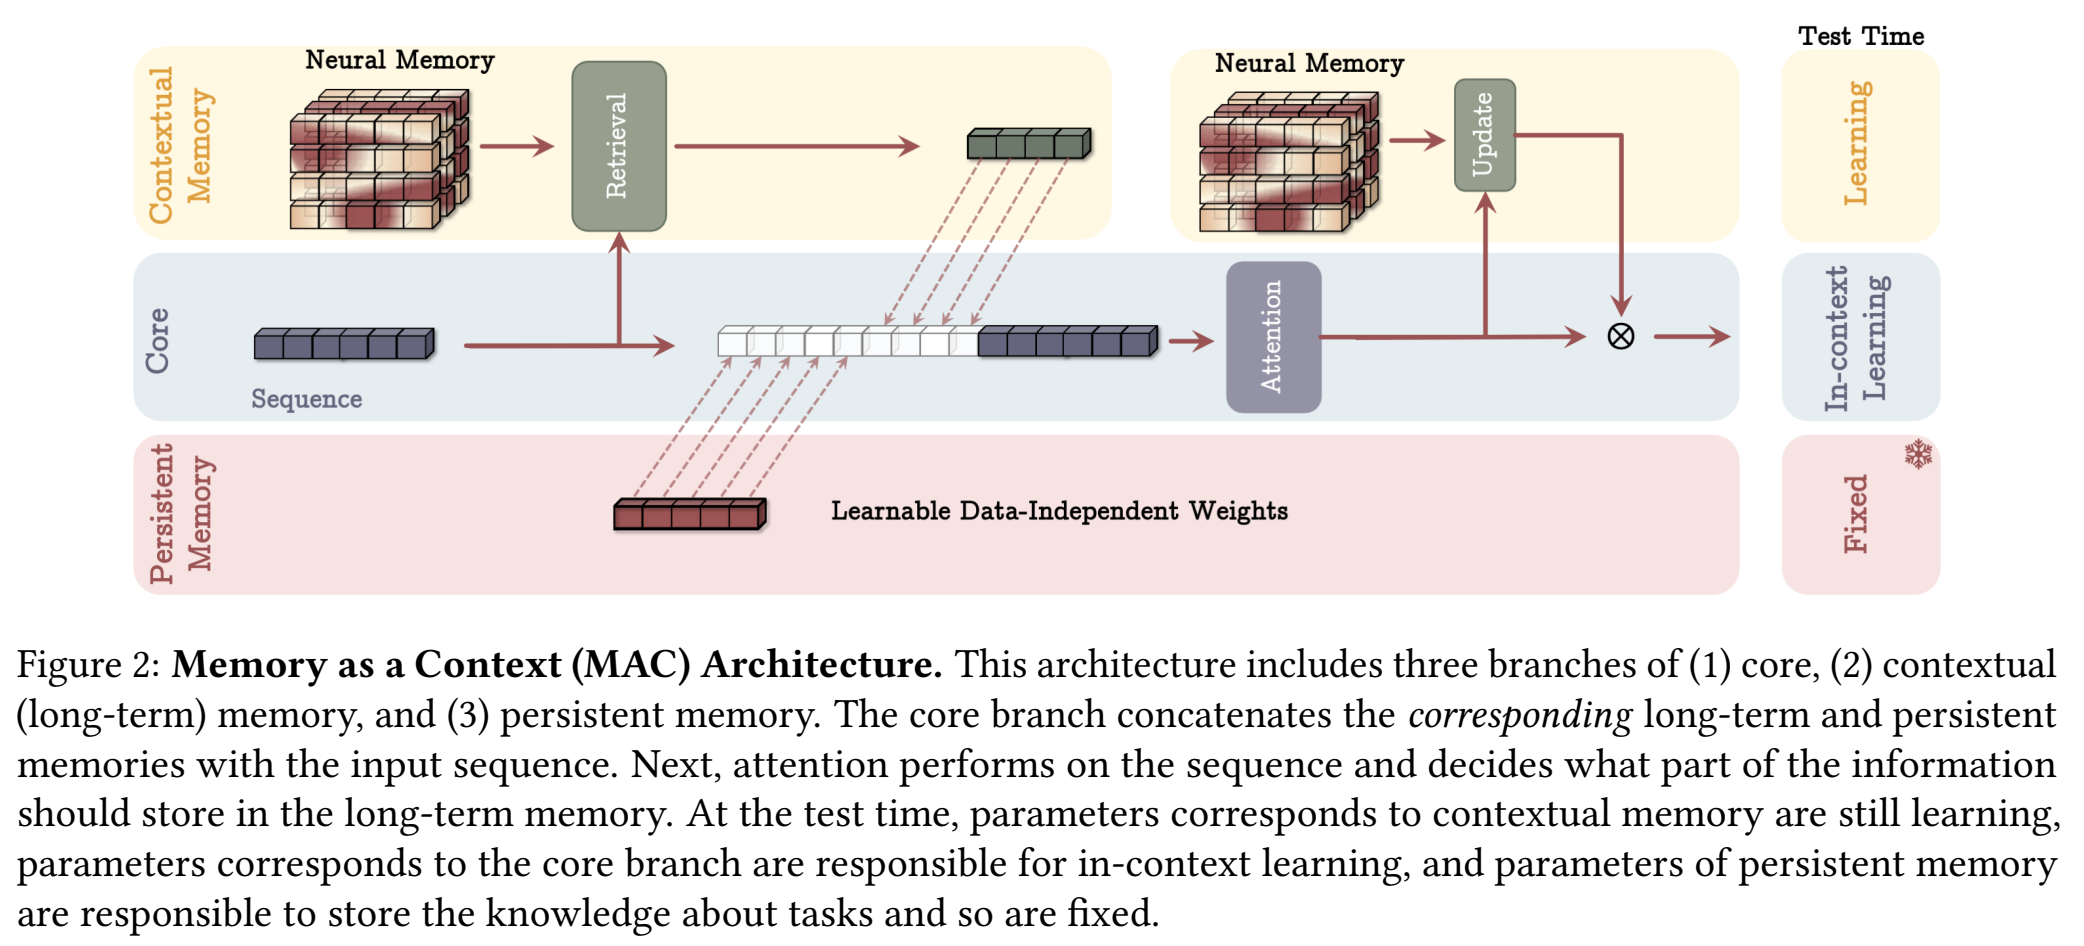
Después, la salida de atención actualiza la memoria para el segmento siguiente y se combina con la salida de memoria para obtener el resultado final. El orden es recuperación, combinación, atención y actualización: una relación más precisa que añadir una memoria genérica a un Transformer.
La memoria persistente tiene aquí un significado específico. Son parámetros aprendidos e independientes de la entrada que representan conocimiento de la tarea y permanecen fijos durante la inferencia. No equivale a un servicio que archive permanentemente las conversaciones de cada usuario.
MAG, MAL y el módulo sin atención
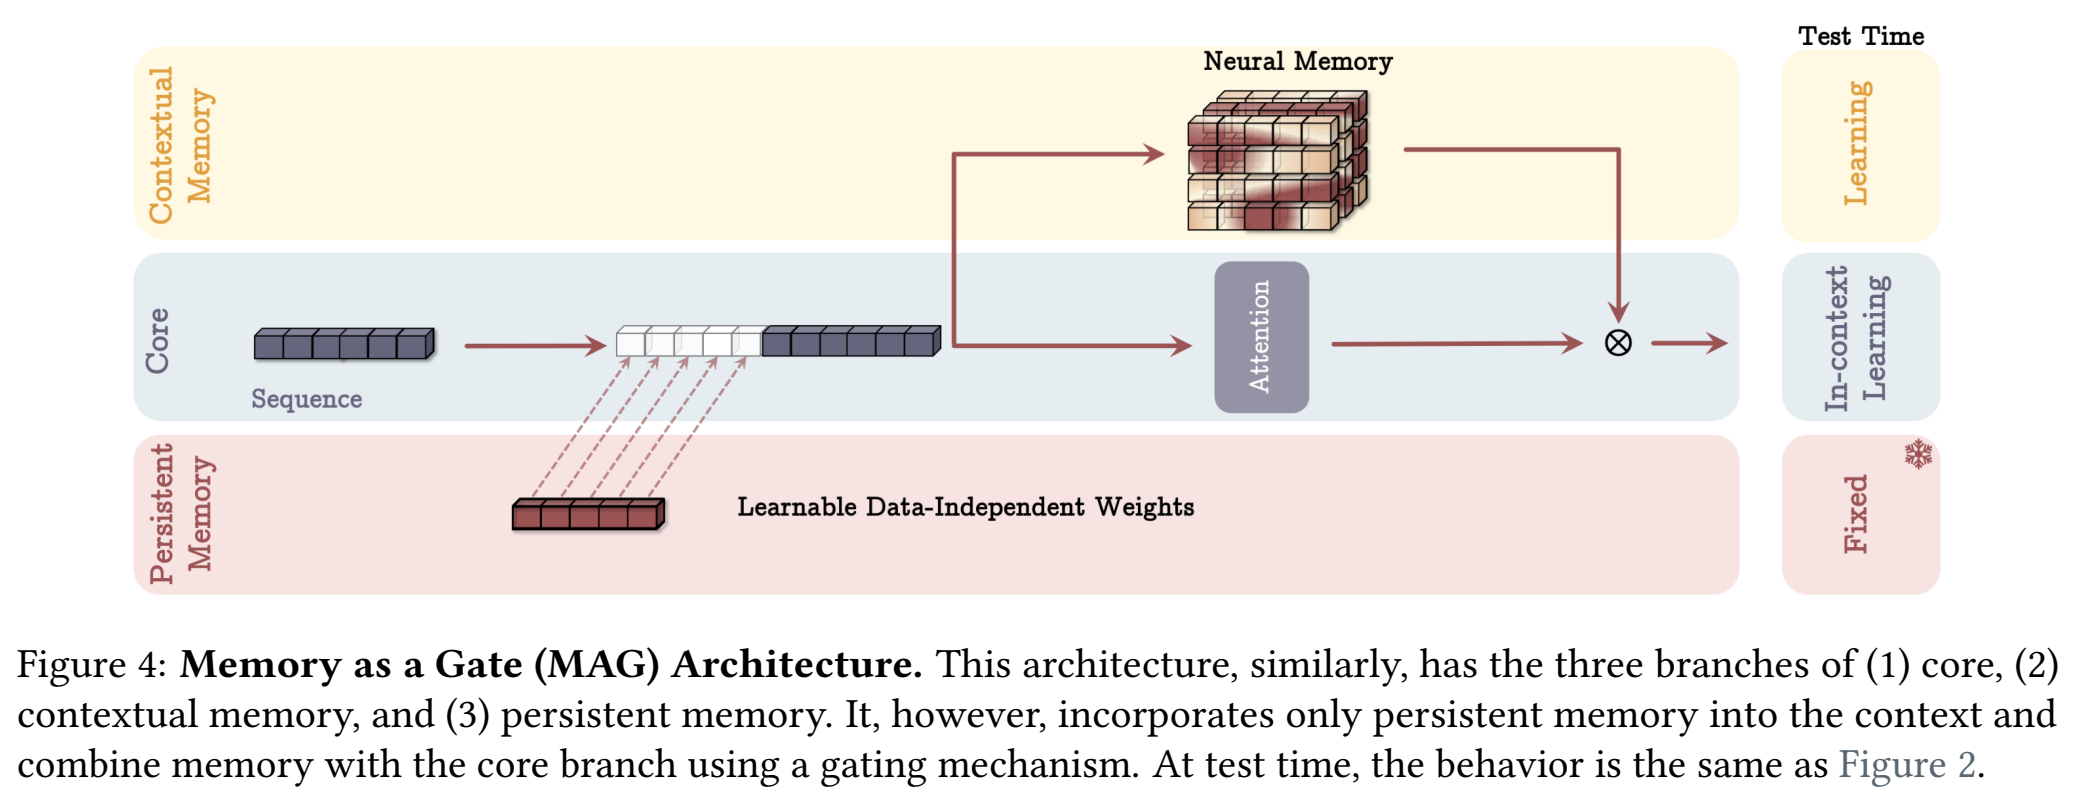
Memory as a Gate (MAG) procesa la entrada mediante una rama de memoria neuronal y otra de atención con ventana deslizante, y combina sus salidas con un mecanismo de compuerta. Ambas pueden aportar información complementaria: la atención trabaja sobre la ventana actual y la memoria conserva contexto previo. La figura 4 muestra esta estructura.
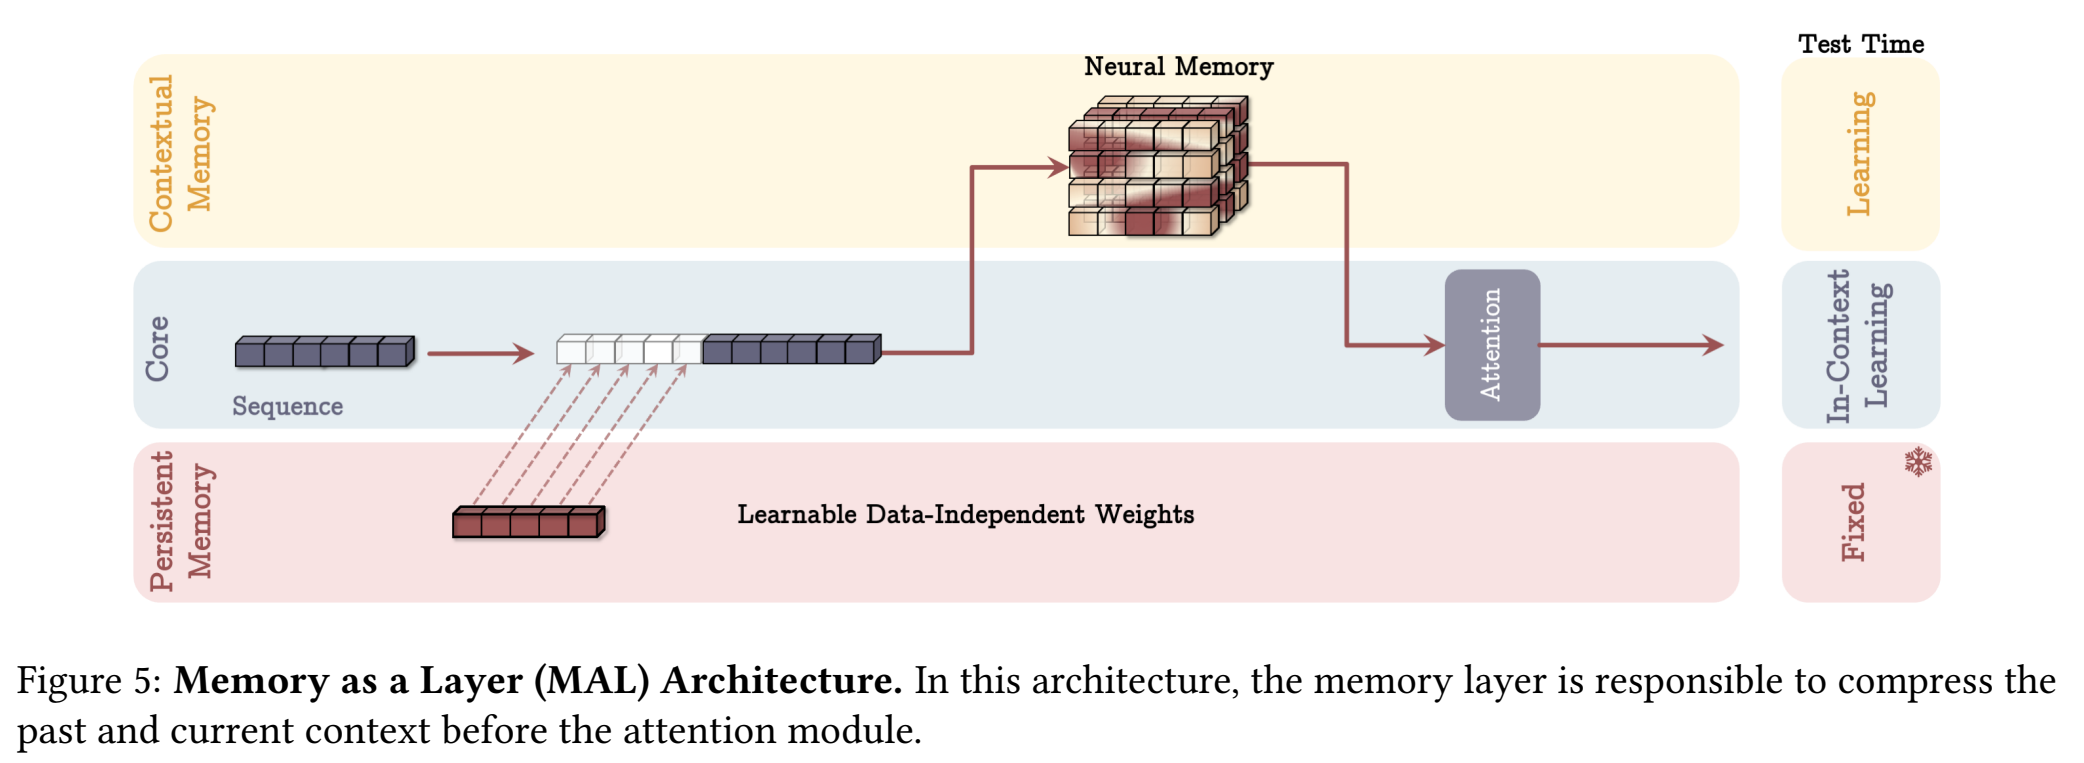
Memory as a Layer (MAL) coloca, en cambio, la memoria antes de la atención en una secuencia de capas. Primero procesa y comprime la información y luego la entrega a la atención. La figura 5 ilustra esta disposición, cuya representación intermedia puede limitar el procesamiento complementario que permiten otras variantes.
El artículo también evalúa el módulo de memoria de largo plazo por sí solo, denominado LMM, sin atención. Esta comparación permite distinguir la contribución de la regla de actualización de memoria del beneficio de combinarla con atención.
Escala y condiciones de entrenamiento
El diseño experimental incluye modelos de 170M, 340M, 400M y 760M parámetros. Los tres primeros se entrenaron con 15.000 millones de tokens de FineWeb-Edu y los de 760M con 30.000 millones. La tabla 1 recoge las escalas 340M, 400M y 760M. Toda comparación debe conservar tanto el tamaño del modelo como el volumen de entrenamiento.
Se usaron secuencias de 4.096 tokens, el tokenizador de Llama 2 y un vocabulario de 32K. El entrenamiento empleó AdamW, una tasa inicial de 0,0004 con planificación cosenoidal, lotes de 500.000 tokens y decaimiento de pesos de 0,1. Los comparadores incluyen Transformer++, la familia Mamba, DeltaNet, TTT y modelos híbridos recurrentes con atención.
Cómo interpretar los resultados de lenguaje
Con 760M parámetros y 30B tokens, la tabla 1 presenta puntuaciones medias de 48,69 para Transformer++, 49,69 para Gated DeltaNet, 51,08 para Samba y 51,49 para Gated DeltaNet-H2. LMM obtiene 51,56; MAC, 52,51; MAG, 52,50; y MAL, 50,97. No cabe concluir que todas las variantes de Titans superan a todos los comparadores.
La perplejidad Wiki es 19,93 para MAC, 18,61 para MAG y 19,07 para MAL, frente a 19,88 de Gated DeltaNet-H2; en esta métrica, menos es mejor. La media ligeramente superior de MAC no significa que sea el mejor en todas las medidas de modelado del lenguaje.
Con 400M parámetros y 15B tokens, las medias de MAC y MAG son 48,65 y 48,60. Son resultados de las pruebas y condiciones indicadas, no una medida universal de inteligencia ni una demostración de superioridad frente a modelos comerciales de gran escala.
Recuperación en contextos largos
Las pruebas de una sola aguja de RULER incluyen S-NIAH-PK, S-NIAH-N y S-NIAH-W con longitudes de 2K, 4K, 8K y 16K. Evalúan la recuperación de información entre texto distractor, no solo la aceptación de entradas largas. La tabla 2 conserva los resultados originales.
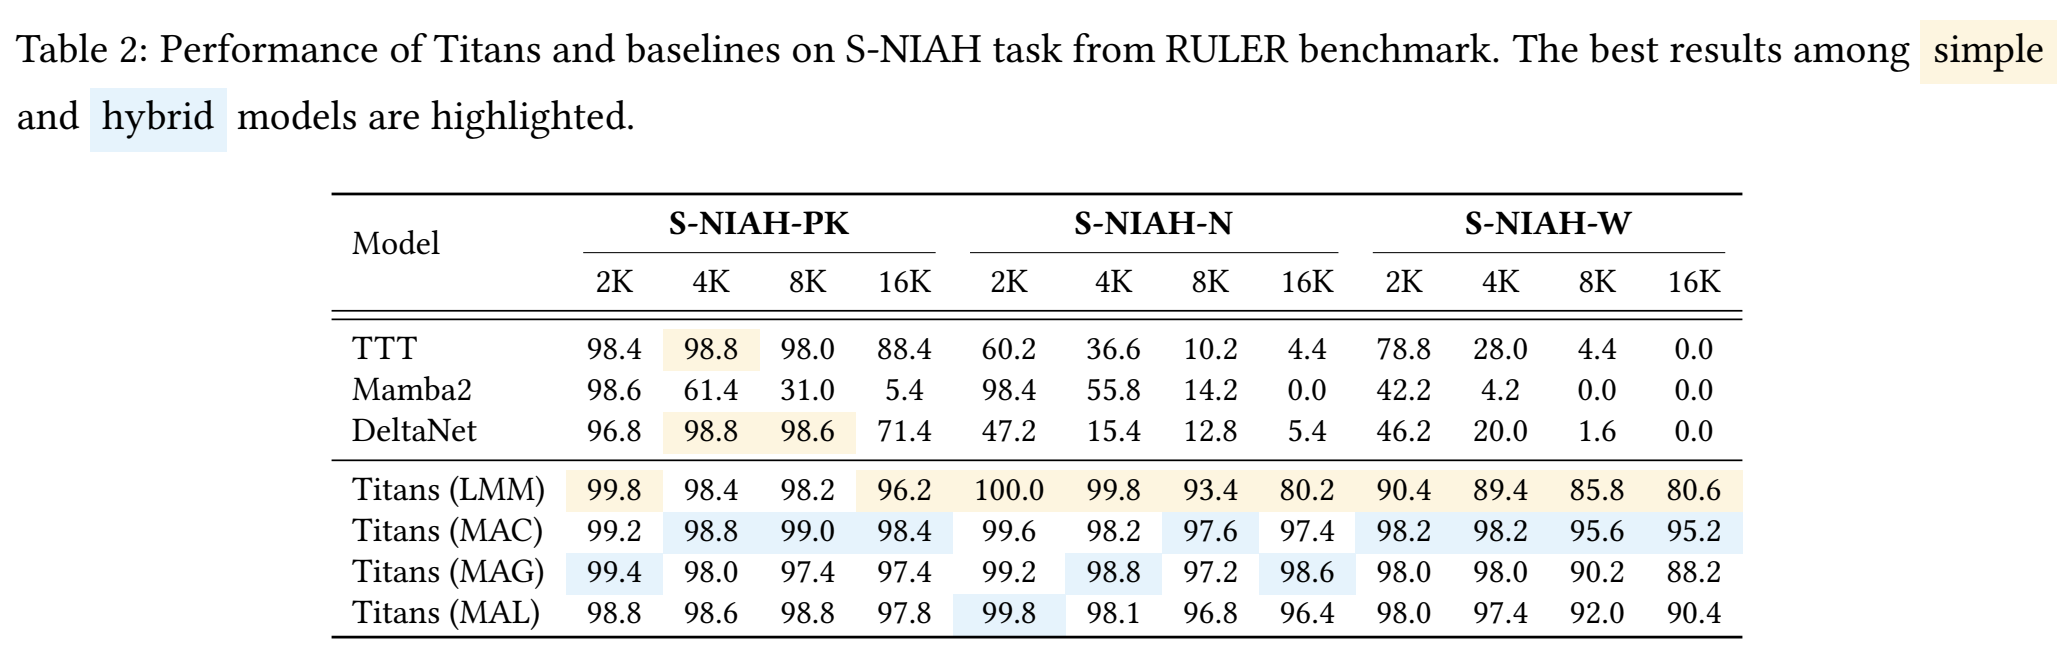
A 16K, MAC logra 98,4, 97,4 y 95,2 en las tres tareas; LMM, 96,2, 80,2 y 80,6; y TTT, 88,4, 4,4 y 0,0. En S-NIAH-N, MAG alcanza 98,6, por encima de 97,4 de MAC. MAC no encabeza todas las celdas.
BABILong exige razonar sobre hechos dispersos en documentos mucho más extensos, y el artículo informa de procesamiento por encima de dos millones de tokens. Cambian los escenarios con pocos ejemplos y con ajuste fino, los tamaños y los comparadores con RAG. Las comparaciones que incluyen GPT-4 no deben presentarse como condiciones uniformes ni como una garantía para cualquier documento empresarial.
Profundidad, velocidad y límites prácticos
El estudio compara memorias MLP de una a cuatro capas y memoria lineal. Una mayor profundidad mejoró la perplejidad en los experimentos, pero redujo la velocidad de procesamiento. Estas pruebas se realizaron sobre el módulo de memoria y un subconjunto de Pile; no equivalen al coste completo de todas las arquitecturas Titans.
La implementación agrupa gradientes por bloques, utiliza multiplicaciones matriciales y paraleliza el cálculo del momento. Eso no significa que cualquier actualización no lineal se reduzca a una única operación paralela sin restricciones. El propio artículo indica que el módulo de memoria era algo más lento que Mamba2 y Gated DeltaNet.
Las asociaciones comprimidas no constituyen una base de datos literal con trazabilidad de cada fuente. Actualizar u olvidar pesos no garantiza exactitud factual, recuperación exacta de citas ni borrado verificable. La v1 debe valorarse dentro de su escala experimental, cuyo modelo de mayor tamaño indicado tiene 760M parámetros.
Lectura de las ablaciones desde la revisión técnica y de patentes
Para valorar el mecanismo conviene identificar cómo se relacionan memoria clave–valor, momento, olvido adaptativo y atención. Decir que «la IA recuerda» no concreta la solución técnica ni la interacción de sus elementos.
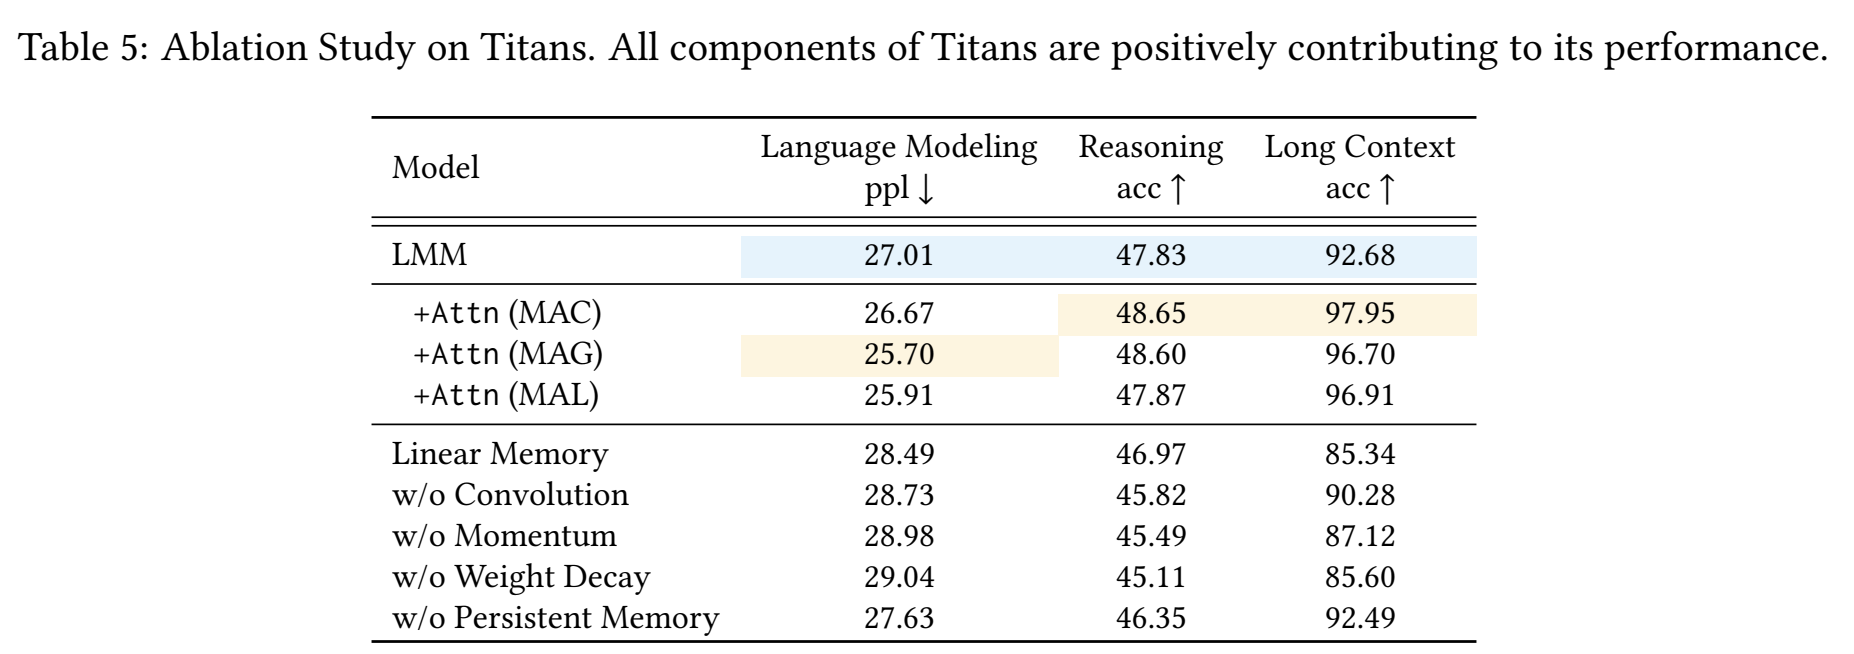
La tabla 5 atribuye a LMM una puntuación de contexto largo de 92,68. Sin momento baja a 87,12; sin decaimiento de pesos, a 85,60; y con memoria lineal, a 85,34. Las ablaciones permiten apreciar la aportación de cada componente. Su perplejidad de modelado del lenguaje no debe identificarse automáticamente con la perplejidad Wiki de la tabla 1.
En esa tabla, los resultados de contexto largo son 97,95 para MAC, 96,70 para MAG y 96,91 para MAL. Ayudan a comparar decisiones arquitectónicas, pero no acreditan por sí solos la validez de una reivindicación ni que un producto comercial incorpore el mismo sistema.
La aportación de la arquitectura
Titans conecta tres decisiones: conservar información previa, atender a la entrada actual y actualizar u olvidar a medida que avanza el procesamiento. Su aportación reside en la interacción concreta de esos mecanismos, más que en la denominación «memoria a largo plazo».
Una memoria útil no es necesariamente una copia exacta del documento original. La evaluación debe mantener visibles la escala, las condiciones de prueba y los compromisos de coste, distinguiendo el mecanismo propuesto de las promesas sobre sistemas en producción.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
Los resultados numéricos y la arquitectura aquí descritos corresponden a las 27 páginas de arXiv v1. No se equiparan con una versión posterior ni demuestran el rendimiento o la implementación de un producto comercial.
Versión analizada: Titans, arXiv v1 (31 de diciembre de 2024)
Licencia de las figuras: CC BY 4.0
Publicación posterior en congreso: NeurIPS 2025
Conozca el trabajo de IPLEX en análisis de tecnología de IA y patentes.
Conozca la experiencia de Yongduck Kim en IA