
対象論文と技術的課題
本稿は弁理士・金容徳による論文解説です。対象はSonglin Yang、Yikang Shen、Kaiyue Wen、Shawn Tan、Mayank Mishra、Liliang Ren、Rameswar Panda、Yoon Kimによる「PaTH Attention: Position Encoding via Accumulating Householder Transformations」で、所属はMIT、MIT–IBM Watson AI Lab、Stanford、Microsoftです。NeurIPS 2025論文の初公開は2025年5月22日。本稿では2026年2月3日付arXiv 2505.16381v2(CC0 1.0)を参照します。単に過去のトークンを思い出すだけでなく、変数への代入等、順次起こる状態変化をどう追うかが中心課題です。
固定的な位置回転から入力依存の経路へ
RoPEのQueryとKeyも内容に依存します。本論文で問題とするのは、位置の回転規則が相対距離で決まり、途中の入力内容を反映しない点です。PaTHはk_jᵀ(H_{j+1}…H_i)q_iのように、中間トークンが生成する変換をQueryとKeyの間に挿入します。行列積は一般に可換でないため、同じ距離でも状態変化の順序が異なれば別の経路として扱えます。softmaxとValueの重み付き和は維持され、過去全体を一つの固定長状態へ圧縮する線形Attentionではありません。
Householder型変換と忘却ゲート
各段階はH = I − βwwᵀです。小さな線形射影と幅3の短い畳み込みからL2正規化したwを生成し、βはsigmoidの2倍により0~2の範囲で制御します。β = 2ではHouseholder反射ですが、一般の場合は収縮も含むため、常にノルム保存と説明するのは正確ではありません。PaTH-FoXは、この経路に沿う方向変換に、過去の寄与を弱める忘却ゲートを組み合わせます。方向の変化と振幅の減衰は異なる役割を担います。
合成課題――数値と実験条件を併せて読む
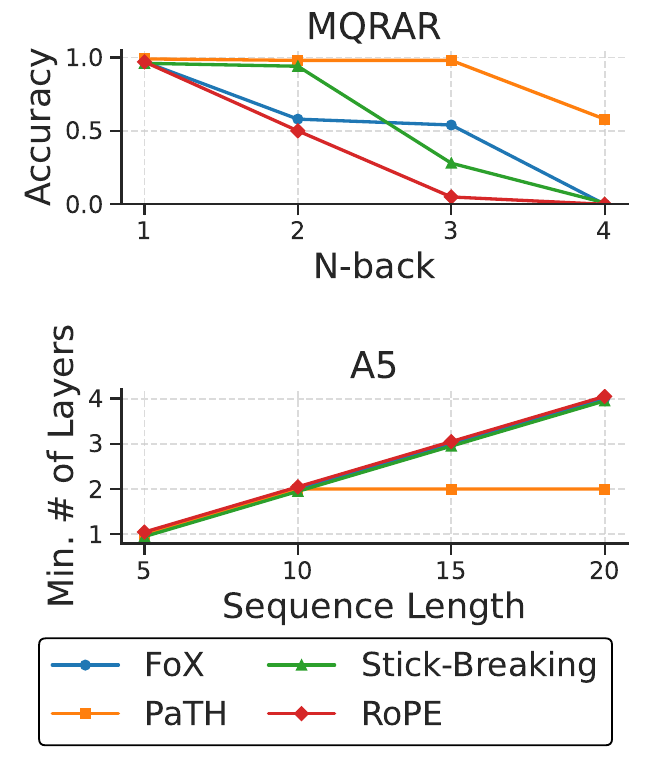
flip-flop課題の1層・2ヘッド・64次元の設定では、分布内誤り率がRoPEの6.9%からPaTHの0%へ、98%を無視する分布外設定では40.3%から0.0001%へ低下しました。制御された合成課題の結果であり、実サービスの無誤りを保証しません。図2のMQRAR-Nは2層、次元256、2ヘッド、32組のKey–Value、長さ768で、PaTHもN = 4では精度が下がります。A5置換課題は精度90%に達する最小層数の比較です。表現力の理論は構成可能性を示すもので、すべての課題で容易に学習できるという意味ではありません。
言語モデル――同条件での比較と規模
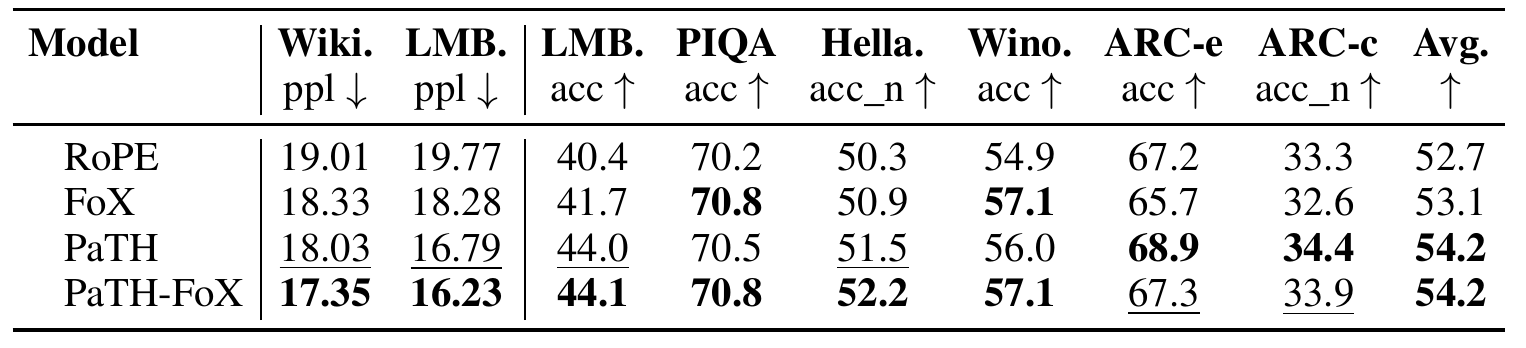
主要実験は760MモデルをFineWeb-Eduの50Bトークンで学習し、Mistral tokenizer、長さ4096、H100を8基、約2~3日という設定です。表2のWikiText perplexityはRoPE 19.01、PaTH 18.03、PaTH-FoX 17.35、LAMBADAは19.77、16.79、16.23でした。6課題の平均精度は52.7、54.2、54.2で、FoXは53.1です。PaTHのRoPEに対する差は1.5ポイントであり、すべての比較で優位というわけではありません。PIQAとWinoGrandeではFoXがPaTHを上回りました。
長文――perplexityと検索精度は別の指標
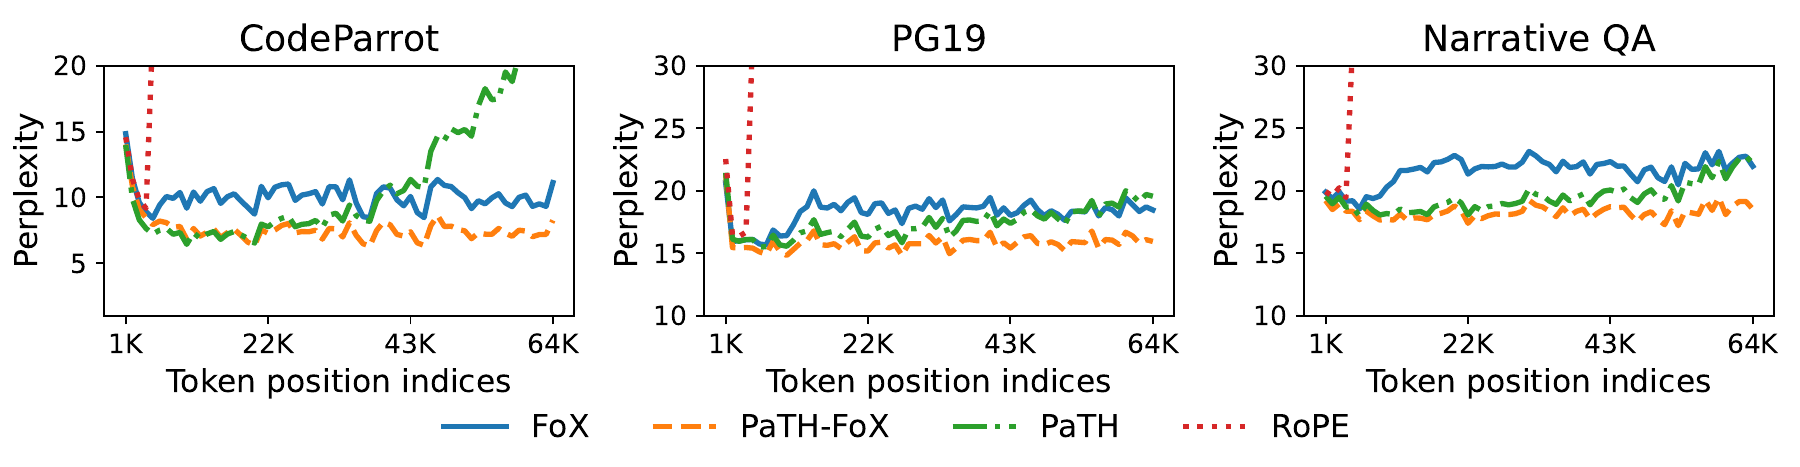
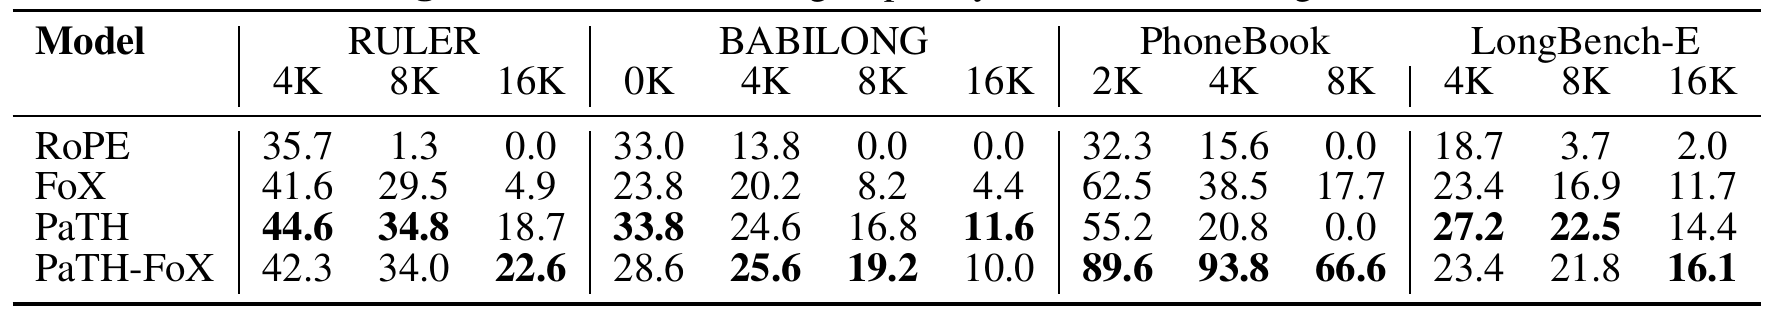
図3ではPaTH-FoXとFoXが対象コーパスで64Kまで安定し、PaTH単独は約32Kを超えると、とくにコードで悪化します。表3は検索・状態追跡を直接評価します。RULERの8KはRoPE 1.3、FoX 29.5、PaTH 34.8、PaTH-FoX 34.0で、16Kでは後二者が18.7、22.6です。PhoneBookのPaTH対PaTH-FoXは4Kで20.8対93.8、8Kで0対66.6と大きく異なります。LongBench-Eの短い二つの区間ではPaTHが優位でした。BABILONGは物語中の推論と状態追跡を扱います。長文のperplexityが良いことと、情報を確実に取り出せることは同義ではありません。
既存モデルの変換――手順と出発点が重要
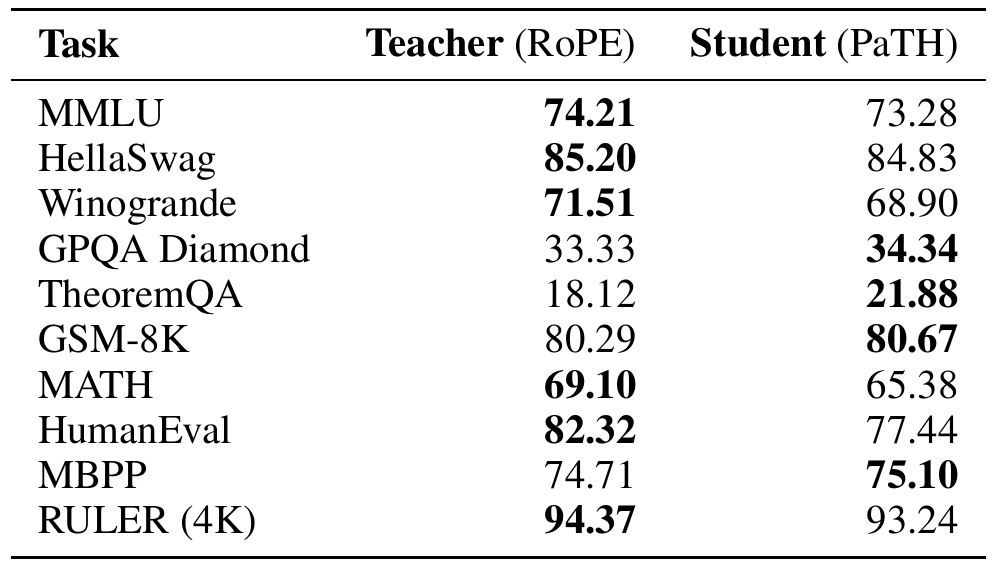
変換ではまず100MトークンでAttention出力のMSEを最小化し、続いて3Bトークンで出力分布のKL divergenceを用います。高品質な数学・コード学習前のSmolLM2-1.7B checkpointに対し、その後text/code/mathを1:1:1で21Bトークン追加学習します。HumanEvalはRoPE 23.1に対しPaTH 25.6、MBPP+は47.1に対し51.3でした。一方、表5のQwen2.5-7B-Instructは同じ追加数学・コード学習なしの変換です。GSM8Kは80.29から80.67へ上がりますが、MATHは69.10から65.38、HumanEvalは82.32から77.44へ低下します。変換すれば必ず改善するとはいえません。
並列化しても残る計算・キャッシュのコスト
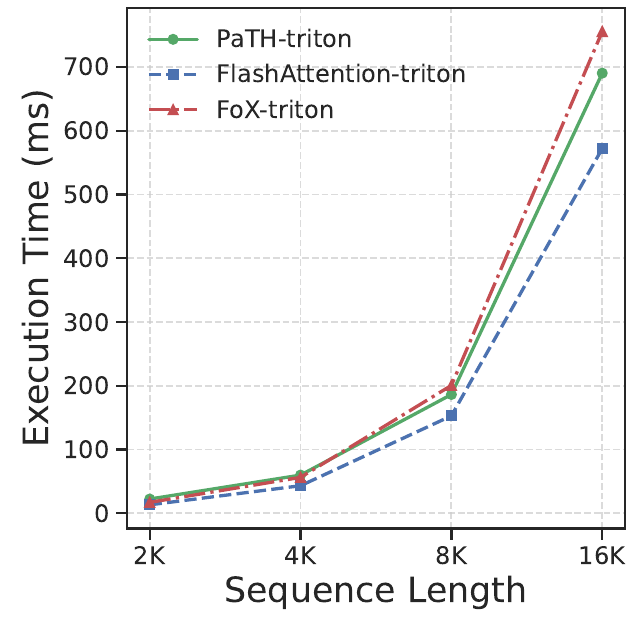
変換積の低ランク表現を利用し、Q/Kのブロック前処理、scan、online softmaxをFlashAttention型アルゴリズムに組み込みます。Attention行列全体を実体化しないことでメモリアクセスを抑えますが、系列長に対する計算量は二次のままです。生成時にもK/Vキャッシュを保持し、新しい変換を過去のKeyへ適用します。図1はH100を1基、batch 32、32ヘッド、ヘッド次元64とするTriton実装の比較で、PaTHはRoPE/FlashAttentionより遅くFoXより速い結果でした。普遍的な高速化やキャッシュの不要化を示してはいません。
限界と特許実務からの読み方
βが2に近い場合、BF16では数値不安定性が生じ得るため、clip等の制御が必要です。速度評価はヘッド次元64であり、大きなヘッドでは計算・メモリ負担が増え得ます。また単一のHouseholder型変換の族がRoPEの回転全体を含むわけではありません。入力依存の経路変換、状態追跡、実行可能な並列アルゴリズムを結び付け、特定条件で効果を示した点が技術的な中心です。その違いが直ちに特許性や侵害を意味するわけではありません。PaTH単独とPaTH-FoX、改善と悪化、精度とコストを併せて評価する必要があります。