
Статья и техническая задача
Патентный поверенный Yongdeok Kim анализирует работу PaTH Attention: Position Encoding via Accumulating Householder Transformations. Авторы — Songlin Yang, Yikang Shen, Kaiyue Wen, Shawn Tan, Mayank Mishra, Liliang Ren, Rameswar Panda и Yoon Kim; организации — MIT, MIT–IBM Watson AI Lab, Stanford и Microsoft. Работа NeurIPS 2025 впервые опубликована 22 мая 2025 года; здесь рассматривается arXiv 2505.16381v2 от 3 февраля 2026 года с лицензией CC0 1.0. Основной вопрос — как внимание может отслеживать последовательные изменения состояния, например присваивания переменной, а не только вспоминать прежний токен.
От фиксированного вращения к пути, зависящему от данных
Запросы и ключи RoPE уже зависят от содержания. Рассматриваемое ограничение относится к правилу позиционного вращения: оно определяется расстоянием, а не промежуточным входом. PaTH вводит преобразования промежуточных токенов в оценку k_jᵀ(H_{j+1}…H_i)q_i. Упорядоченное произведение различает пути одинаковой длины с разными изменениями состояния; умножение матриц в общем случае некоммутативно. Softmax и взвешивание значений сохраняются. Это не линейное внимание, сжимающее всю историю в одно состояние фиксированного размера.
Преобразования Хаусхолдера и вентиль забывания
Каждый шаг задается H = I − βwwᵀ. Небольшая линейная проекция и короткая свертка ширины 3 формируют L2-нормированный w; β определяется удвоенной сигмоидой в диапазоне от 0 до 2. При β = 2 это отражение Хаусхолдера, но общий вариант включает и сжатие, поэтому сохранение нормы не гарантируется всегда. PaTH-FoX добавляет вентиль забывания, ослабляющий ранние вклады. Изменение направления вдоль пути и затухание амплитуды выполняют разные функции.
Синтетические задачи: результаты вместе с условиями
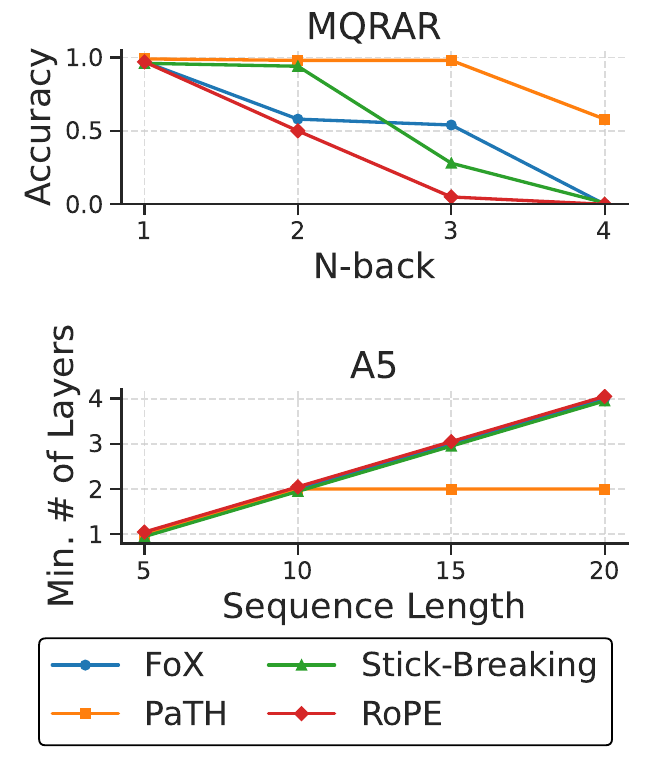
В задаче flip-flop при одном слое, двух головах и размерности 64 ошибка внутри распределения составила 6,9 % для RoPE и 0 % для PaTH. Вне распределения, при 98 % игнорируемых команд, значения были 40,3 % и 0,0001 %. Это контролируемые синтетические тесты, а не гарантия безошибочных приложений. MQRAR-N на рисунке 2 использовал два слоя, размерность 256, две головы, 32 пары ключ–значение и длину 768: при N меньше 4 PaTH был силен, но при N = 4 точность снижалась. Для перестановок A5 измеряли минимальное число слоев, достигающее 90 %. Теоретическая выразительность не гарантирует обучаемость любой задачи.
Языковые модели: масштаб и сопоставимые условия
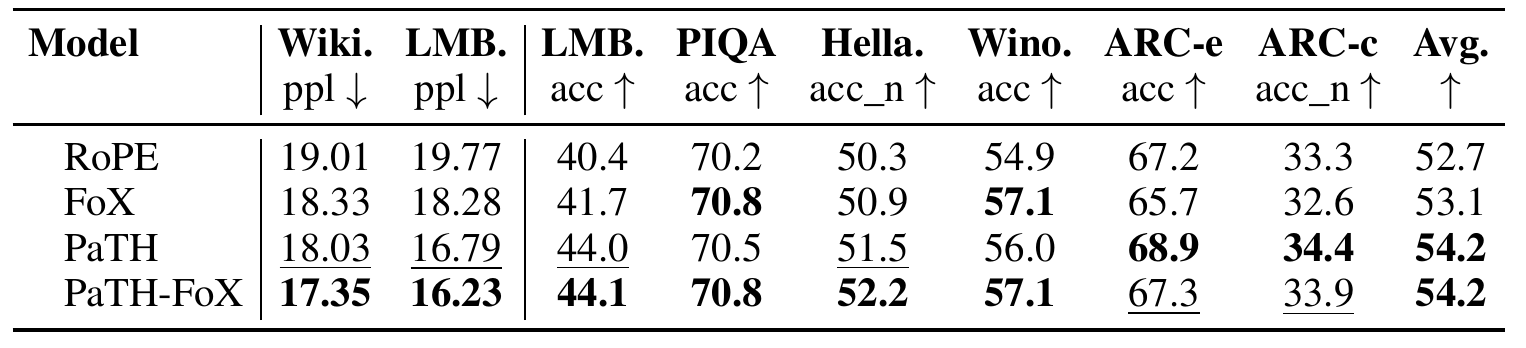
Основной эксперимент обучал модели на 760 млн параметров и 50 млрд токенов FineWeb-Edu с токенизатором Mistral и длиной 4096, на восьми H100 примерно два–три дня. В таблице 2 перплексия WikiText равна 19,01 для RoPE, 18,03 для PaTH и 17,35 для PaTH-FoX; LAMBADA — 19,77, 16,79 и 16,23. Средняя точность шести задач составила 52,7, 54,2 и 54,2 при 53,1 у FoX. Прирост PaTH к RoPE — 1,5 процентного пункта, а не всеобщая победа: FoX лучше PaTH в PIQA и WinoGrande.
Длинный контекст: перплексия и поиск — разные проверки
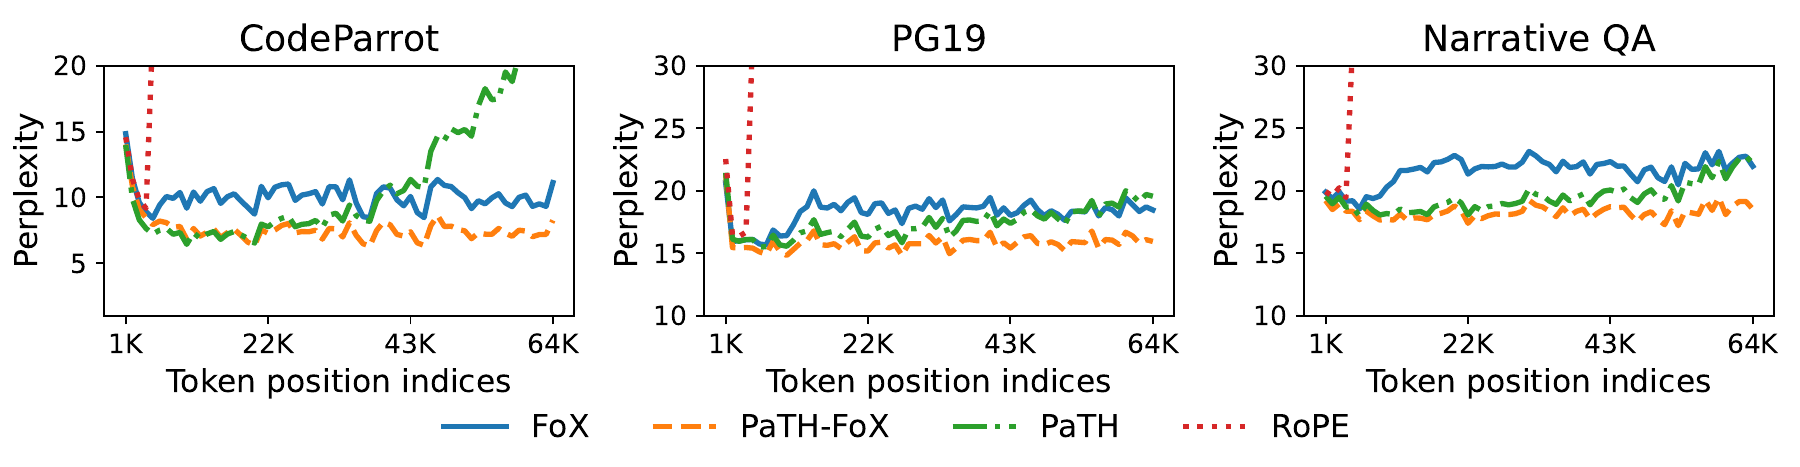
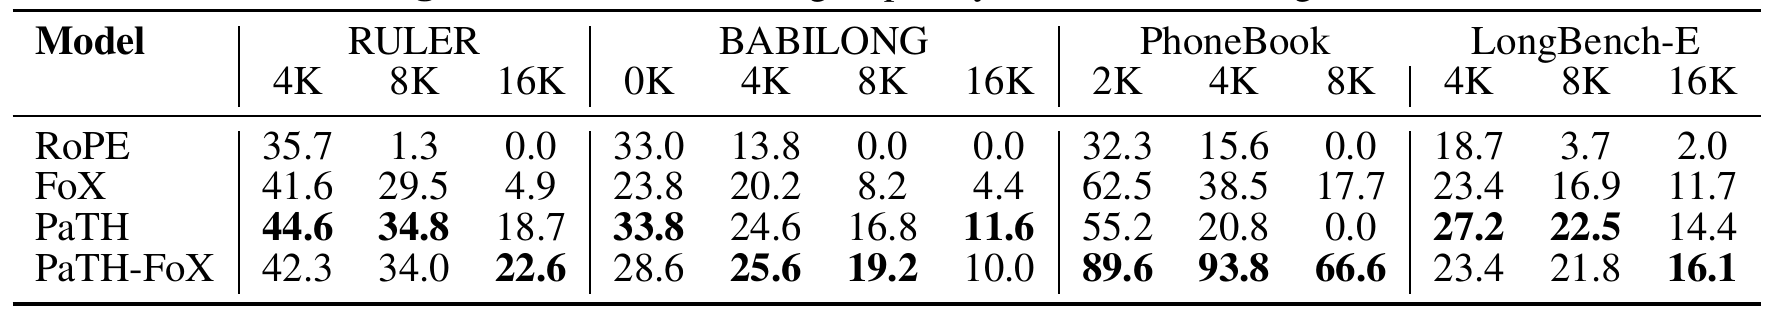
На рисунке 3 PaTH-FoX и FoX сохраняют стабильность до 64K токенов на проверенных корпусах; PaTH отдельно — примерно до 32K, после чего ухудшается, особенно на коде. Таблица 3 прямо проверяет поиск и состояния: RULER при 8K дает 1,3 для RoPE, 29,5 для FoX, 34,8 для PaTH и 34,0 для PaTH-FoX; при 16K последние два — 18,7 и 22,6. В PhoneBook PaTH и PaTH-FoX дают 20,8 против 93,8 при 4K и 0 против 66,6 при 8K. PaTH лидирует на двух коротких интервалах LongBench-E. BABILONG добавляет рассуждения в повествовании. Хорошая перплексия длинного текста не доказывает надежного извлечения сведений.
Преобразование обученной модели: важны рецепт и исходная точка
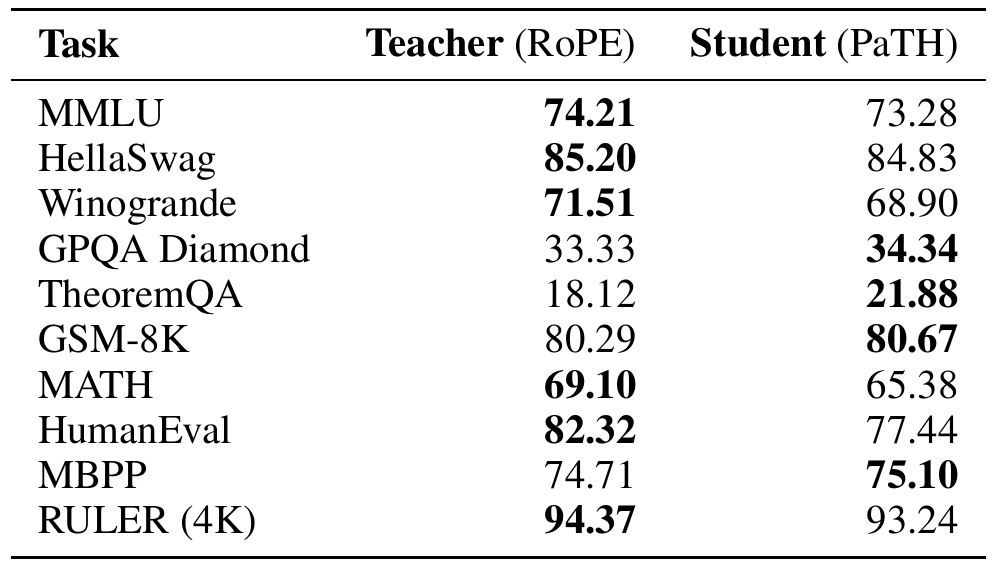
Сначала преобразование использует MSE-дистилляцию выходов внимания на 100 млн токенов, затем KL-дивергенцию выходных распределений на 3 млрд. Контрольная точка SmolLM2-1.7B до этапа качественных математических и кодовых данных дополнительно обучается на 21 млрд токенов текста/кода/математики в пропорции 1:1:1. PaTH получает 25,6 против 23,1 RoPE в HumanEval и 51,3 против 47,1 в MBPP+. В таблице 5 Qwen2.5-7B-Instruct преобразуется без такого дополнительного этапа: GSM8K растет с 80,29 до 80,67, но MATH падает с 69,10 до 65,38, HumanEval — с 82,32 до 77,44. Улучшение не гарантировано.
Параллельное выполнение и сохраняющиеся затраты
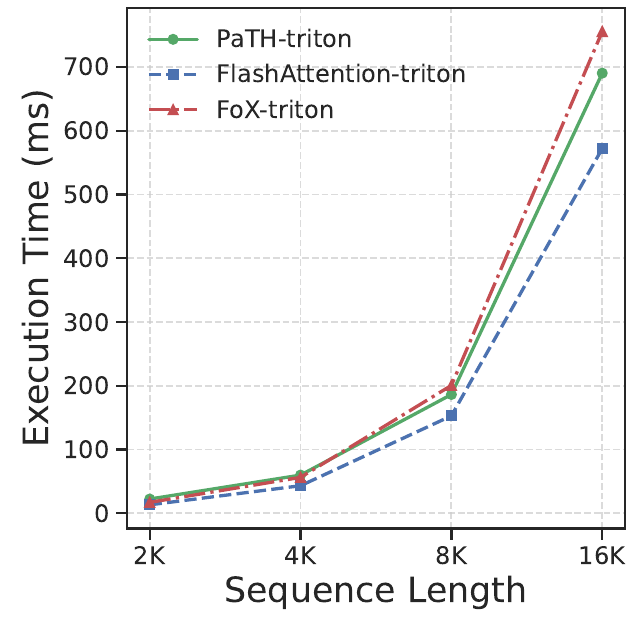
Компактное низкоранговое представление произведения позволяет выполнять блочную подготовку Q/K, сканирование и online softmax по схеме FlashAttention. Отказ от хранения полной матрицы внимания уменьшает обмен с памятью, но сложность по длине последовательности остается квадратичной. При декодировании сохраняется кеш ключей и значений, а новое преобразование применяется к прошлым ключам. На рисунке 1 сравниваются Triton-реализации на одной H100, batch 32, 32 головах и размерности головы 64: PaTH медленнее RoPE/FlashAttention, но быстрее FoX. Это не доказывает универсального ускорения или ненужности кеша.
Ограничения и взгляд патентного специалиста
При β около 2 вычисления BF16 могут терять устойчивость и требовать ограничения параметра. Скоростной тест использует размерность головы 64; более крупные головы могут повысить вычислительные затраты и расход памяти. Одно семейство преобразований типа Хаусхолдера не включает все вращения RoPE. Суть вклада — сочетание зависящего от входа пути, отслеживания состояний и исполнимого параллельного алгоритма с эффектами в определенных условиях. Эти отличия сами по себе не доказывают патентоспособность или нарушение прав. Следует совместно оценивать PaTH и PaTH-FoX, улучшения и ухудшения, точность и стоимость.
Связанная практика: патенты в области ИИ
Статья PaTH Attention, версия 2