
论文及其技术问题
本文为专利代理师金容德的技术评论,解析Songlin Yang、Yikang Shen、Kaiyue Wen、Shawn Tan、Mayank Mishra、Liliang Ren、Rameswar Panda、Yoon Kim的论文“PaTH Attention: Position Encoding via Accumulating Householder Transformations”,作者所属机构包括MIT、MIT–IBM Watson AI Lab、Stanford和Microsoft。该NeurIPS 2025论文首次发表于2025年5月22日,本文采用2026年2月3日的arXiv 2505.16381v2,许可为CC0 1.0。核心问题是在回忆先前词元之外,注意力机制如何跟踪变量连续赋值等状态变化。
从固定位置旋转到输入依赖路径
RoPE的查询和键本来就依赖内容;这里的局限是位置旋转规则取决于相对位置,而非中间输入。PaTH把中间词元生成的变换加入查询—键评分:k_jᵀ(H_{j+1}…H_i)q_i。矩阵乘法通常不满足交换律,因此距离相同、状态变化顺序不同的路径也能被区分。模型保留softmax注意力及对值向量的加权,并不是将全部历史压入单一固定大小状态的线性注意力。
Householder型步骤与遗忘门
每步采用H = I − βwwᵀ。小型线性投影与宽度为3的短卷积生成经L2归一化的w,β由两倍sigmoid控制在0到2之间。β = 2时是Householder反射,但一般设置还包含收缩,不能笼统称为始终保持范数。PaTH-FoX将沿路径的方向变换与衰减较早贡献的遗忘门结合,分别处理路径依赖方向与幅度衰减。
合成状态跟踪:同时看分数与条件
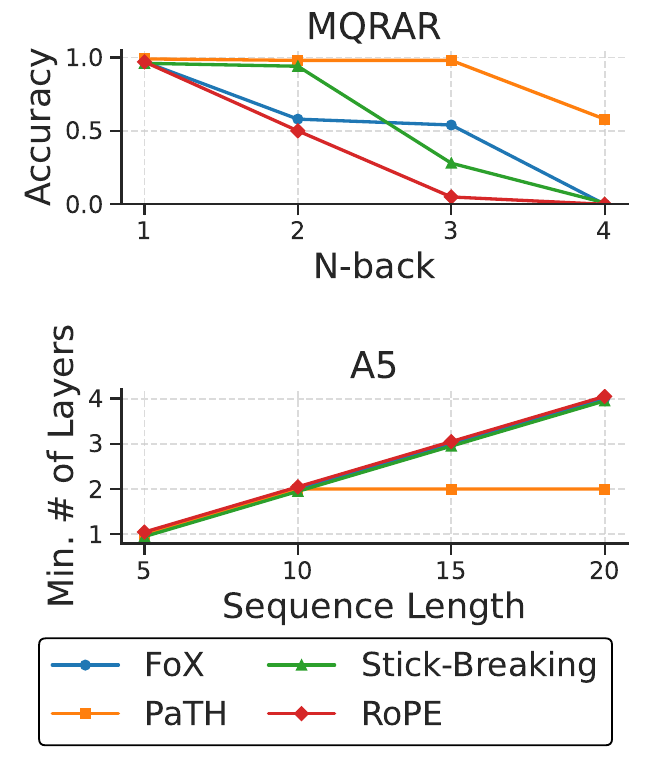
flip-flop任务采用1层、2个头、64维设置,分布内错误率从RoPE的6.9%降至PaTH的0%;在98%忽略指令的分布外条件下,分别为40.3%与0.0001%。这是受控合成任务结果,不是实际应用零错误承诺。图2的MQRAR-N使用2层、256维、2个头、32组键值对及长度768;PaTH在N小于4时较强,但N = 4也下降。A5置换任务比较达到90%准确率所需的最小层数。理论表达能力说明可表示性,不等于任何任务都能自动学会。
语言模型:同条件比较与规模限制
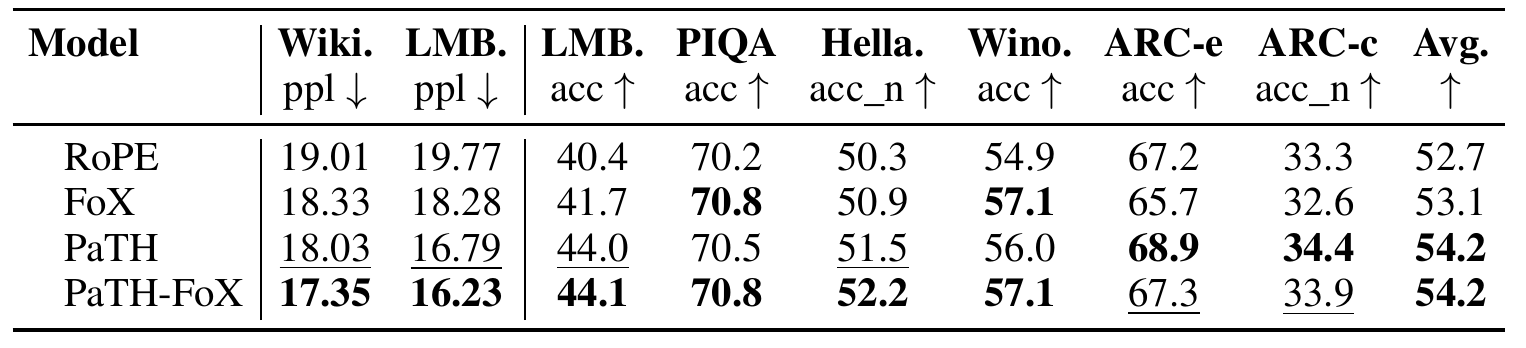
主要语言模型实验使用760M参数、50B FineWeb-Edu词元、Mistral分词器及4096长度,在8块H100上训练约2~3天。表2的WikiText困惑度为RoPE 19.01、PaTH 18.03、PaTH-FoX 17.35;LAMBADA分别为19.77、16.79、16.23。六项任务平均准确率为52.7、54.2、54.2,FoX为53.1。PaTH相对RoPE提高1.5个百分点,不代表全面胜出:FoX在PIQA和WinoGrande上优于PaTH。
长上下文:困惑度不等于检索能力
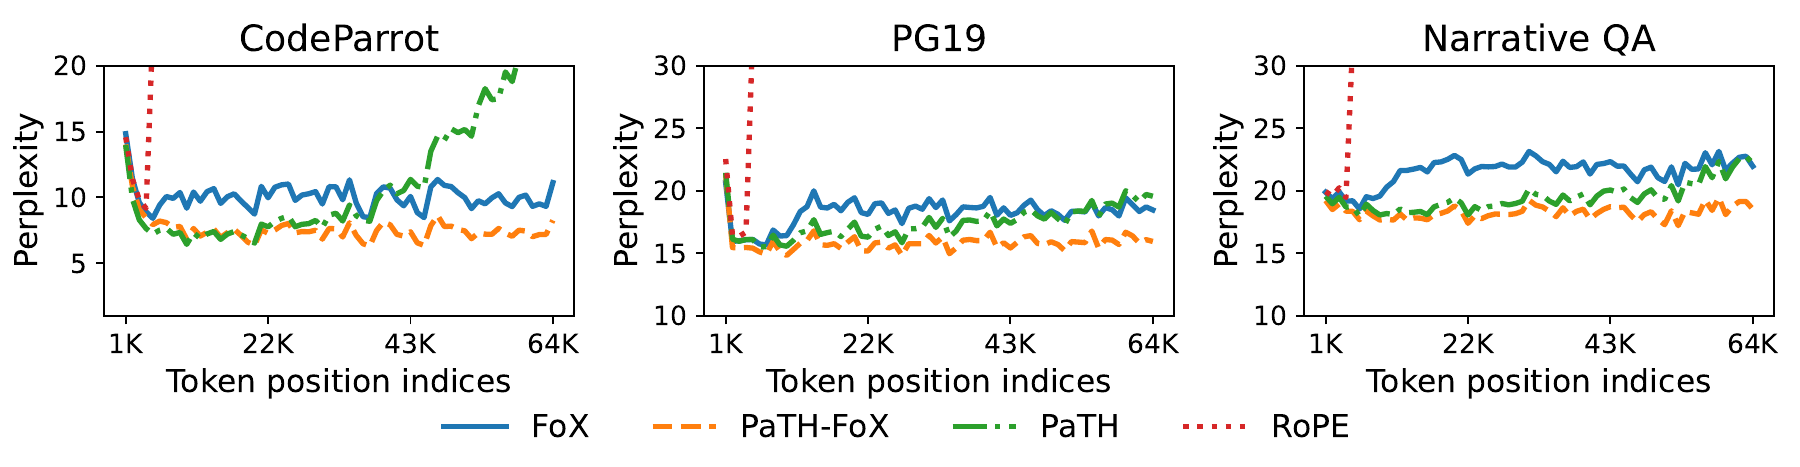
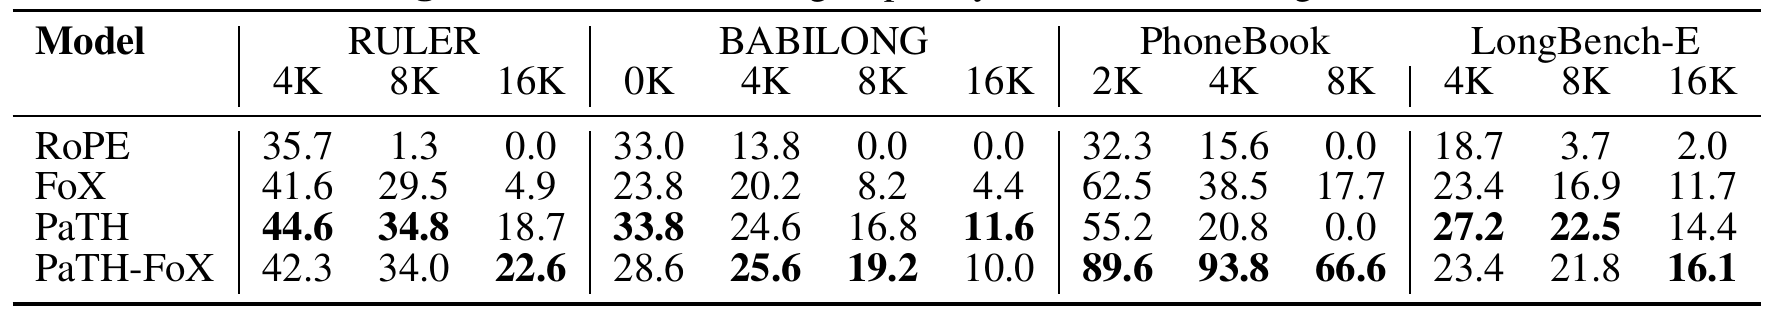
图3显示PaTH-FoX与FoX在所测语料上可稳定到64K词元,PaTH单独使用约到32K,随后恶化,代码场景尤为明显。表3直接测试检索及状态跟踪。8K RULER分数为RoPE 1.3、FoX 29.5、PaTH 34.8、PaTH-FoX 34.0;16K时后两者为18.7与22.6。PhoneBook中PaTH与PaTH-FoX在4K为20.8对93.8,8K为0对66.6。PaTH在LongBench-E两个较短区间领先。BABILONG还测试叙事推理和状态跟踪。长文困惑度较好,不能直接推定检索可靠。
转换预训练模型:训练方案与起点很重要
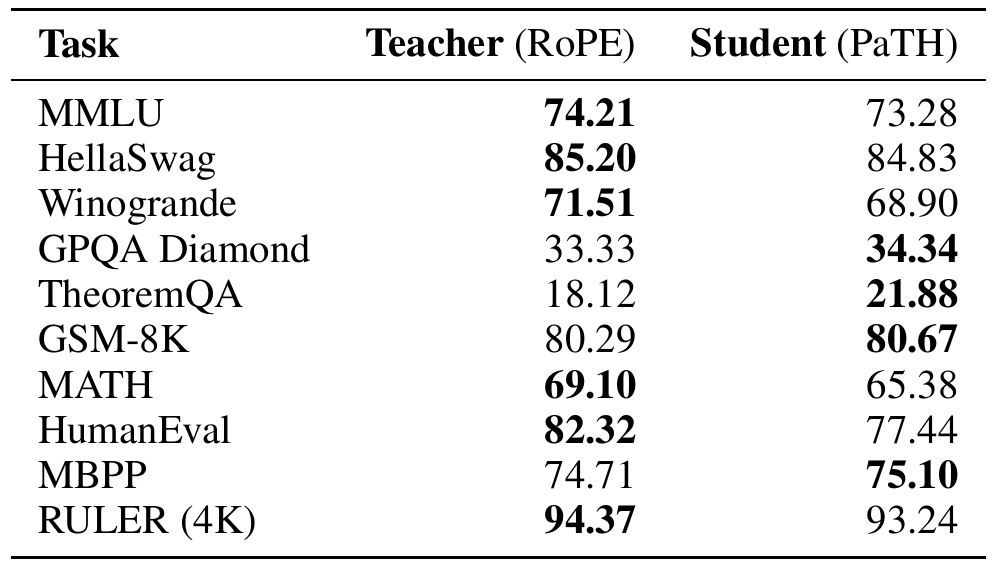
转换先用100M词元对注意力输出进行MSE蒸馏,再用3B词元对输出分布进行KL散度训练。对尚未进入高质量数学、代码阶段的SmolLM2-1.7B检查点,再以文本/代码/数学1:1:1混合继续训练21B词元。HumanEval上PaTH为25.6、RoPE为23.1,MBPP+为51.3对47.1。收益与继续训练有关。表5的Qwen2.5-7B-Instruct则没有该额外数学、代码训练阶段:GSM8K从80.29升至80.67,但MATH从69.10降至65.38,HumanEval从82.32降至77.44。转换不保证升级。
并行执行与仍然存在的成本
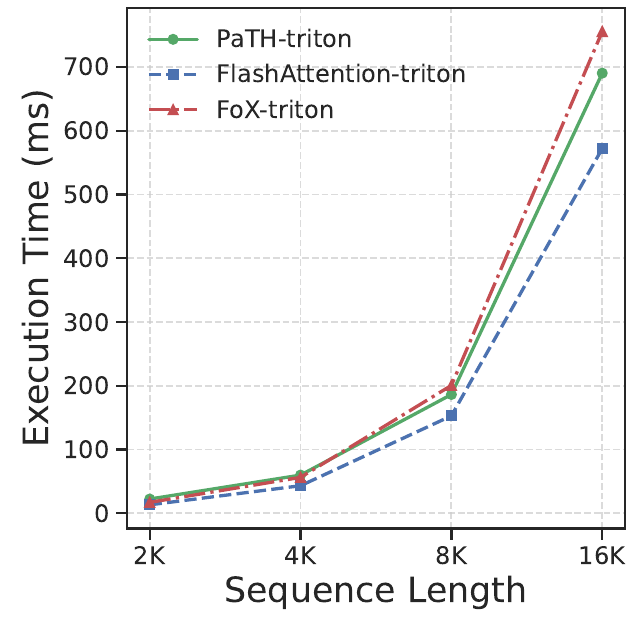
变换乘积的紧凑低秩表示支持分块Q/K预处理、扫描和在线softmax,形成FlashAttention式算法。不显式生成完整注意力矩阵可减少内存流量,但计算量随序列长度仍按平方增长。解码仍保存K/V缓存,并将新变换应用到过去的键。图1在单块H100、batch 32、32个头、头维度64的Triton实现上比较:PaTH慢于RoPE/FlashAttention,快于FoX。这不能证明普遍速度优势,也不意味着取消缓存。
局限与专利分析视角
β接近2时,BF16可能出现数值不稳定,需要裁剪等控制。速度测试采用64维头,更大的头可能增加计算和内存成本;单个Householder型变换族也不包含完整RoPE旋转族。技术贡献在于将输入条件化路径变换、状态跟踪与可执行的并行算法结合,并在限定条件下展示效果。这些差异本身不能直接得出专利性或侵权结论。应同时考察PaTH和PaTH-FoX、改善与退步、数值精度与成本。