
El artículo y el problema técnico
El agente de patentes Yongdeok Kim comenta PaTH Attention: Position Encoding via Accumulating Householder Transformations, de Songlin Yang, Yikang Shen, Kaiyue Wen, Shawn Tan, Mayank Mishra, Liliang Ren, Rameswar Panda y Yoon Kim, con afiliaciones a MIT, MIT–IBM Watson AI Lab, Stanford y Microsoft. El trabajo de NeurIPS 2025 se publicó inicialmente el 22 de mayo de 2025; se analiza arXiv 2505.16381v2, de 3 de febrero de 2026, bajo CC0 1.0. La cuestión es cómo seguir cambios de estado, como asignaciones sucesivas a una variable, además de recordar un token anterior.
De la rotación posicional fija al recorrido dependiente de los datos
RoPE ya utiliza consultas y claves dependientes del contenido. La limitación examinada afecta a su regla de rotación posicional, determinada por la distancia relativa y no por los datos intermedios. PaTH introduce sus transformaciones en la puntuación: k_jᵀ(H_{j+1}…H_i)q_i. El producto ordenado distingue recorridos de igual longitud con cambios de estado diferentes; las matrices, en general, no conmutan. Se conservan softmax y la ponderación de valores. No se convierte toda la historia en un único estado fijo propio de ciertos modelos de atención lineal.
Transformaciones de Householder y puerta de olvido
Cada paso adopta H = I − βwwᵀ. Una pequeña proyección lineal y una convolución corta de anchura 3 generan w, normalizado en L2; β se controla con el doble de una sigmoide entre 0 y 2. Con β = 2 se obtiene una reflexión de Householder, pero el caso general también admite contracción: no conserva siempre la norma. PaTH-FoX añade una puerta de olvido que atenúa contribuciones anteriores. La transformación direccional del recorrido y la reducción de amplitud cumplen funciones diferentes.
Seguimiento sintético: resultados bajo condiciones concretas
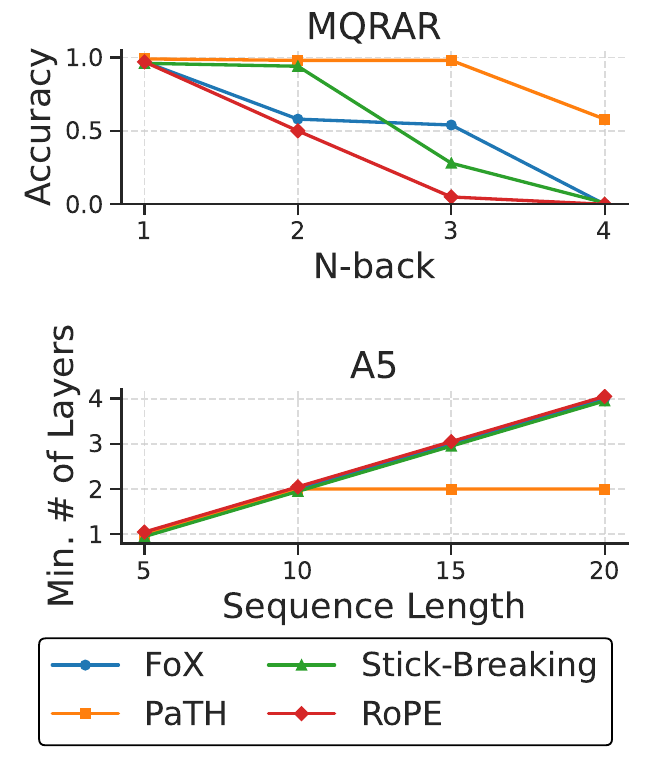
En flip-flop, con una capa, dos cabezas y dimensión 64, el error dentro de distribución pasó del 6,9 % de RoPE al 0 % de PaTH; con un 98 % de instrucciones ignorables fuera de distribución, fue del 40,3 % frente al 0,0001 %. Son pruebas sintéticas, no garantías de ausencia de errores reales. MQRAR-N, en la figura 2, empleó dos capas, dimensión 256, dos cabezas, 32 pares clave–valor y longitud 768: PaTH rindió bien con N inferior a 4, pero cayó en N = 4. A5 comparó las capas mínimas para alcanzar el 90 % de precisión. La expresividad teórica no equivale a aprendizaje asegurado.
Modelos de lenguaje: escala y comparación controlada
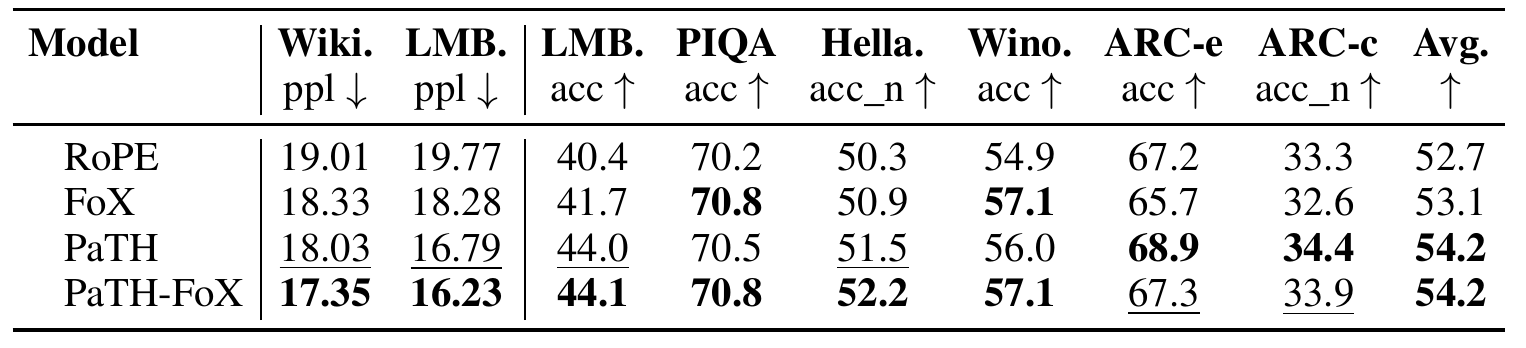
El estudio principal entrenó modelos de 760 millones de parámetros con 50.000 millones de tokens de FineWeb-Edu, tokenizador Mistral y longitud 4096, en ocho H100 durante unos dos o tres días. La tabla 2 muestra perplejidad WikiText de 19,01 para RoPE, 18,03 para PaTH y 17,35 para PaTH-FoX; en LAMBADA, 19,77, 16,79 y 16,23. La precisión media de seis tareas fue 52,7, 54,2 y 54,2, frente a 53,1 de FoX. La mejora de PaTH es de 1,5 puntos porcentuales; FoX lo superó en PIQA y WinoGrande.
Contextos largos: perplejidad y recuperación no son lo mismo
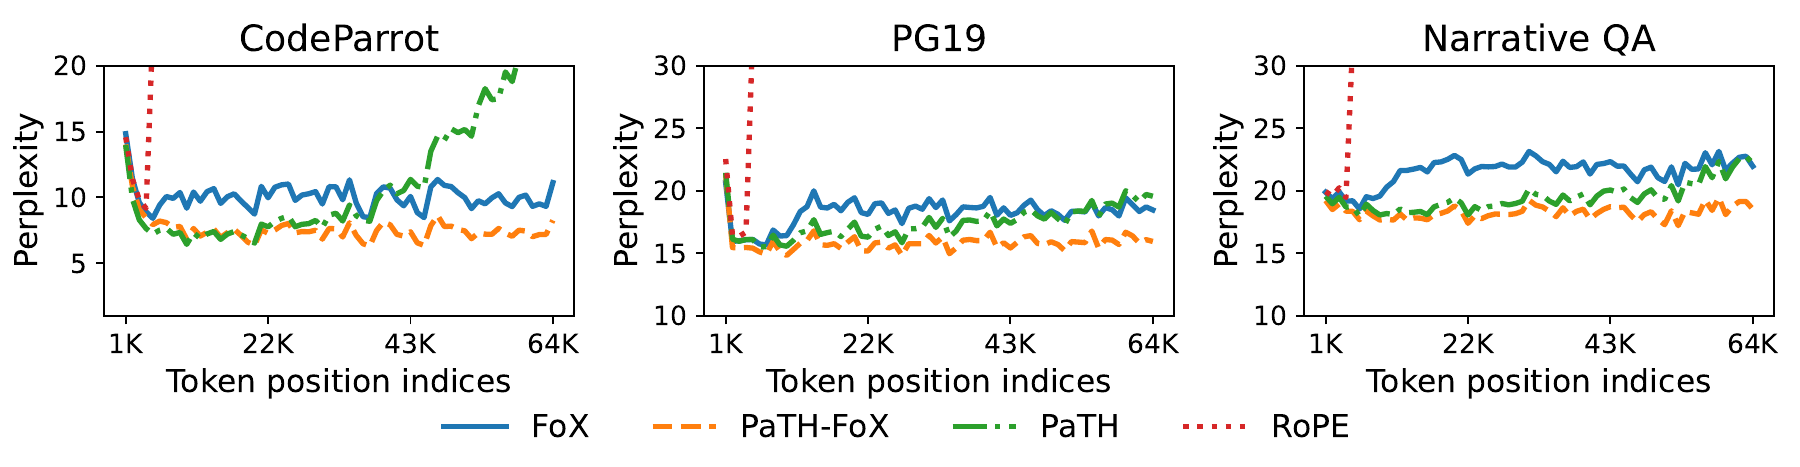
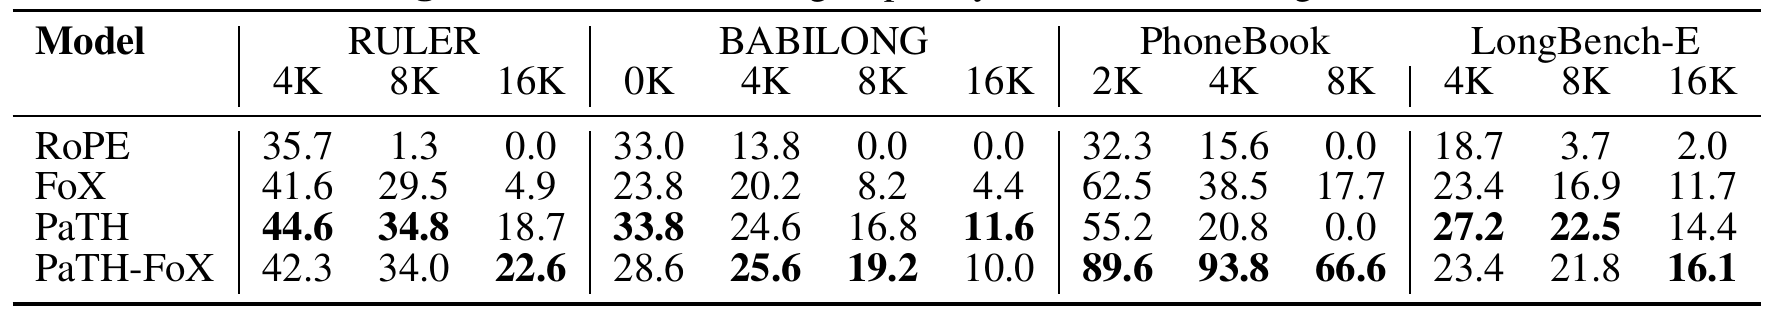
La figura 3 muestra estabilidad de PaTH-FoX y FoX hasta 64K tokens en los corpus probados; PaTH solo se mantiene razonablemente hasta unos 32K y empeora después, sobre todo en código. La tabla 3 evalúa recuperación y estados: RULER a 8K obtiene 1,3 con RoPE, 29,5 con FoX, 34,8 con PaTH y 34,0 con PaTH-FoX; a 16K, los dos últimos dan 18,7 y 22,6. En PhoneBook, PaTH frente a PaTH-FoX logra 20,8 frente a 93,8 a 4K y 0 frente a 66,6 a 8K. PaTH lidera los dos intervalos cortos de LongBench-E. BABILONG añade razonamiento narrativo. Una buena perplejidad no garantiza recuperación fiable.
Conversión de un modelo: importan el método y el punto de partida
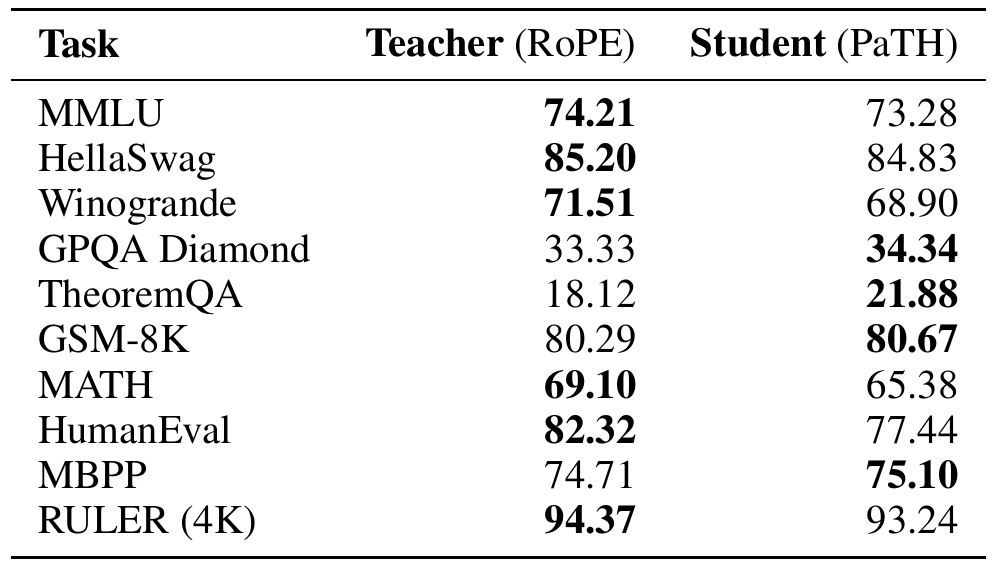
La conversión comienza con destilación de salidas de atención mediante MSE en 100 millones de tokens y continúa con divergencia KL de las distribuciones de salida en 3.000 millones. Un checkpoint de SmolLM2-1.7B anterior a su fase intensiva de matemáticas y código recibe después 21.000 millones de tokens de texto/código/matemáticas en proporción 1:1:1. PaTH logra 25,6 frente a 23,1 de RoPE en HumanEval y 51,3 frente a 47,1 en MBPP+. La tabla 5 convierte Qwen2.5-7B-Instruct sin esa fase adicional: GSM8K sube de 80,29 a 80,67, pero MATH baja de 69,10 a 65,38 y HumanEval de 82,32 a 77,44. No es una mejora garantizada.
Ejecución paralela y costes persistentes
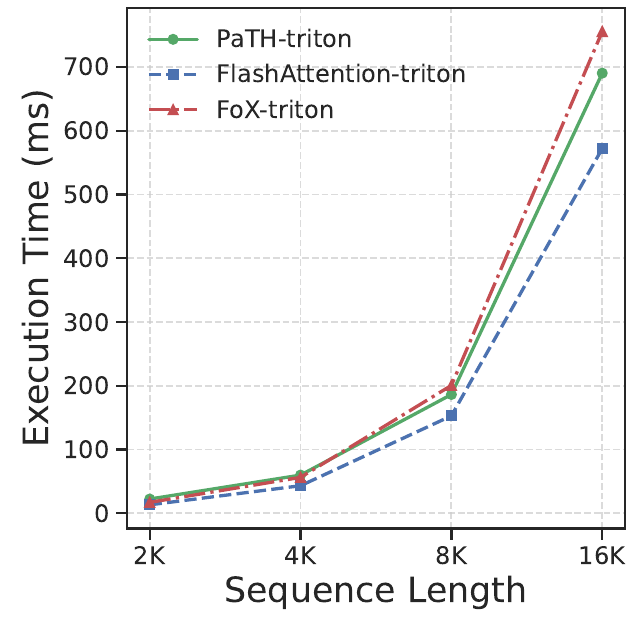
Una representación compacta de bajo rango del producto permite preprocesar Q/K por bloques, realizar barridos y calcular softmax en línea al estilo FlashAttention. No materializar toda la matriz reduce tráfico de memoria, pero el coste sigue siendo cuadrático con la longitud. La decodificación mantiene la caché de claves y valores y aplica la nueva transformación a claves anteriores. La figura 1 compara implementaciones Triton en una H100, lote 32, 32 cabezas y dimensión 64: PaTH es más lento que RoPE/FlashAttention y más rápido que FoX bajo esas condiciones. No demuestra superioridad universal ni desaparición de la caché.
Límites y lectura desde la práctica de patentes
La aritmética BF16 puede resultar inestable cuando β se aproxima a 2 y requerir controles como recorte. La prueba de velocidad usa dimensión de cabeza 64; cabezas mayores pueden elevar cómputo y memoria. Una única familia de transformaciones tipo Householder tampoco contiene toda la familia de rotaciones de RoPE. La aportación combina recorridos condicionados por la entrada, seguimiento de estados y un algoritmo paralelo ejecutable, con efectos medidos en condiciones concretas. Esa diferencia técnica no demuestra por sí sola patentabilidad ni infracción. Deben valorarse juntos PaTH y PaTH-FoX, mejoras y pérdidas, precisión y costes.
Servicio relacionado: patentes de IA
Artículo PaTH Attention, versión 2