
ECCV(コンピュータビジョンに関する欧州会議)2020:Transformerによるエンドツーエンドのオブジェクト検出の分析。
 画像をクリックすると、テキスト全体が表示されます。
この記事はFacebook AIチームによって公開されました。 従来の物体検出アルゴリズムおよび競争の建築物より簡単。多くの人々の注目を浴びました。 これはDETR(検出トランス)と呼ばれます。 DETRの特徴は、自然言語処理でよく用いられるトランスを使用するディカムマイ機能と2)を使用する1です。 です。
この記事で解決する問題は?
既存のオブジェクト検出メソッドは複雑すぎるため、さまざまなライブラリを使用します。 そのため、既存の方法を使うのはかなり難しかったです。
たとえば、既存のオブジェクト検出方法を使用してオブジェクトを検出するには、境界ボックスの形状と、境界ボックスが重複したときにどのように処理されたかを考慮に入れる必要があります。 より効率的なので、全体的に考えてみましょう。
です。 既存のオブジェクトの検出方法を使用するのはかなりトリッキーだった問題を解決するために、より単純なアーキテクチャが必要でした。そして、これはこの論文で解決しました。
DETR全体。
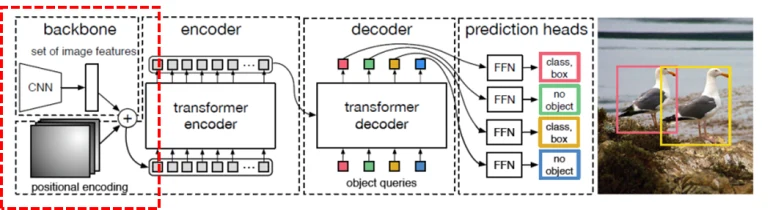
1) バックボーンネットワーク(CNN)は、画像の機能を抽出するために使用され、2) 位置エンコーディングは、画像内の相対的な位置情報を取得するために使用されます。
* * *
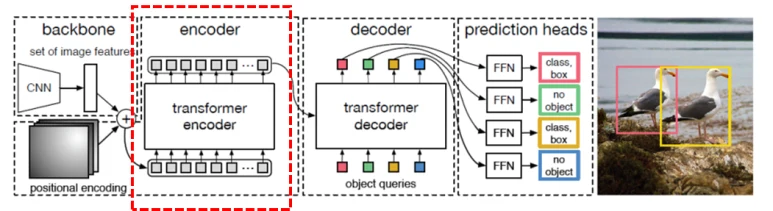
バックボーンネットワークから抽出された機能と、位置情報エンコードから得られる相対位置情報は、エンコーダに入力されます。 ここでは、各ピクセル情報は順次データに対応します。 したがって、シーケンシャルデータを処理するための適切なトランスは、エンコーダとして使用されます。
* * *
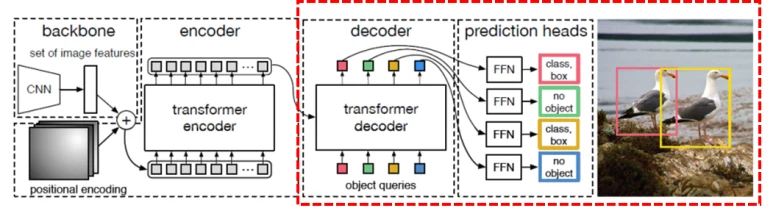
一方、エンコーダとオブジェクトクエリの出力(学習した場所の埋め込みの固定数)はデコーダーに入力され、デコーダーの出力は最終出力を生成するフィードフォワードネットワーク(FFN)に渡されます。 最終的な結果値は: 1) 特定のオブジェクトが存在する場合、そのオブジェクトのクラスと、そのオブジェクトがどこに存在するかに関連するバウンディングボックスに関する情報を含みます。そして 2) 特定のオブジェクトが存在しない場合、オブジェクトはクラスとして表されるものではなく、それが存在しないことを意味します。
* * *
最終的な結果と実際の値のマッチングが成功したことを確実にするために、バイナリマッチング損失関数を使用します。やってみよう。 これにより、マッチング損失関数を用いて、重複のない各インスタンスを検出できます。
その結果、画像入力時に画像から機能を抽出し、実際のオブジェクトの検出結果が得られるように変換する全構造です。
これは、バイパルトマンマッチングです。
過去には、NMS(非最大サスペンション)を使用して、セット予測の問題が間接的に解決されました。 具体的には、設定された予測の問題は、ランダムな場所を見つけ、それらを1つに圧縮することによって解決され、画像全体に存在するオブジェクトインスタンスの数を指定することなく。
しかし、報告書によると、 予測の問題をそれに置きます。 ダイレクトニューヨークタイムズ.
具体的には、固定でセット予測の問題が解決しました。「Nイメージだけはオブジェクトインスタンスを持つことができます。」
です。 出力寸法をNにし、実際の地上の真理と比較すると、設定予測の問題が解決されるように、1対1にマッチするディカムマイティを実行します。.
例えば、N を 6 にピンすると、イメージ全体で最大 6 個のオブジェクトインスタンスが存在する場合、インスタンスが重複しないため、学習プロセスのバイナリマッチを実行します。 この場合、インスタンスは重複しないように誘発されます。
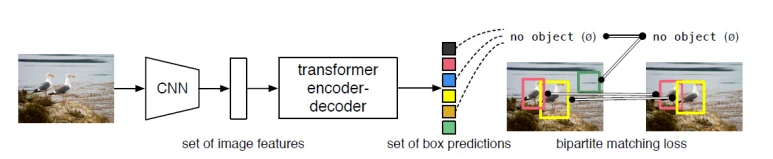
学習プロセス中に撮影した画像を用いて、オブジェクト検出を行う2つの鳥の予測が次のと仮定してみましょう。
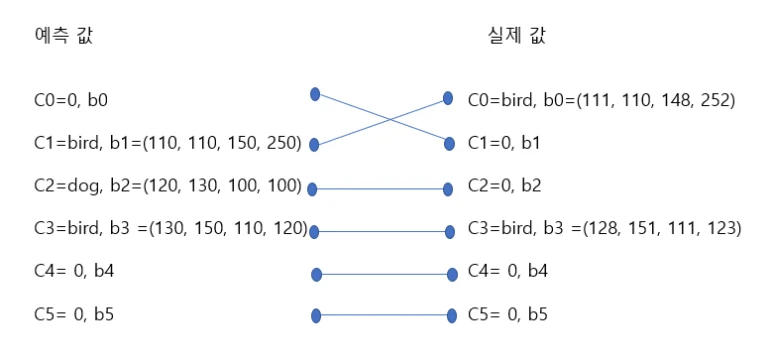
C = クラス
b = 境界ボックス情報(x座標、y座標、幅、高さ)
N=6 では、予測値が C0 から C5 になります。
ここでは、予測値 C2 には、一致する損失値を設定し、クラスが同じでバウンディングボックス情報が似ているときに損失値が低いように構成する誤った結果が含まれています。 試合全体が終了したら、全損失値が最も低い方向でこの試合を実行します。
クラスとバウンディングボックス情報に基づいてマッチングを実行します。 (予測値 C1 は実際の値 C0 にマッチし、予測値 C3 は実際の値 C3) にマッチし、クラスなしの残りの予測値が他の現実値にランダムにマッチします。
学習プロセスでは、クラスのバウンディングボックス情報を削減します。 次に、予測値に誤った予測値(予測値C2)がある場合、実際の値(予測値C2)にデータがないため、オブジェクトを区別できないように一致します。
このように学習が成功すれば、場所とオブジェクトの数だけを予測できます。 問題は述語の問題によって解決されます。 バイナリーマッチが実行されている場合は、各出力位置が予測結果(例えば、C1とC3)で変更される場合でも、バイナリーマッチに問題はありません。そのため、注文は変更され、2つのバウンディングボックスのみが鳥を検出して、インスタンスの冗長性が自然に回避できるようにします。.
トランスを使用する理由
トランスは、シーケンシャルデータがリストされているときにデータを埋め込むのをよりよく訓練するために使用されるアーキテクチャの1つです。
トランスフォーマー 1) 注意して画像全体の文脈情報を理解し、画像内の各インスタンスの相互作用の理解を容易にするために使用されます。
具体的には、各ピクセルが各ピクセルが各ピクセルに注意点を割り当てることで、そのインスタンスが分離され、各インスタンスに対してコンテキストが理解されます。
また、 トランスは、大きな境界ボックスからピクセルの関連付けを容易にするために使用されます。
自然言語処理であっても、文章の深さが悪化した場合、最初の単語と最後の単語の間の関連付けを識別するのは容易ではないかもしれません。 トランスは、この場合に簡単に関係を識別することができます。 画像の自然言語処理と同様に、大きな境界ボックスからピクセルの関連付けを容易に理解しにくい問題があります。
エンコーダとは?
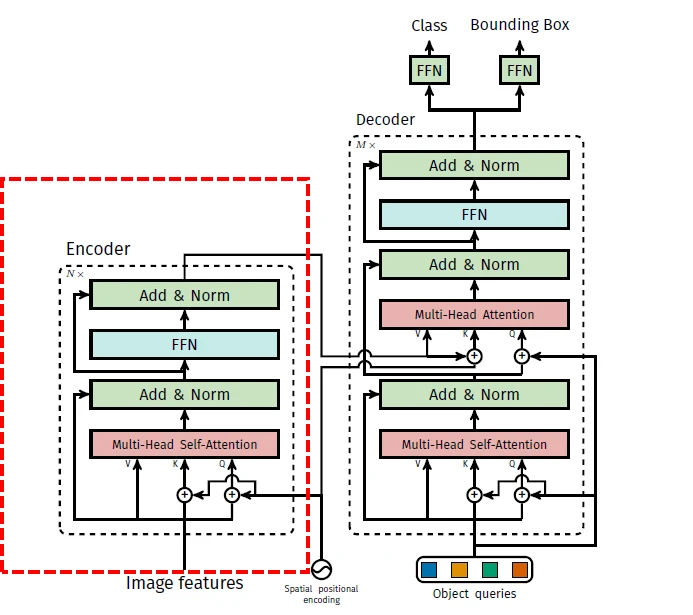
エンコーダは、画像の機能情報を含む各ピクセルの位置データを取り、エンコードを実行します。私はそれをします。 具体的には、エンコーダがd*HWサイズの連続機能マップを受け取ります。
(d=image 機能、HW = 各ピクセル位置情報)
また、位置情報を適切にエンコードし、2Dに存在する実際の画像データの位置情報を適切に処理するために入力することができます。
一方、イメージの特徴情報がエンコーダーに入力されると、各ピクセルのインタラクションと関連付け情報が自己の注意をしながら学習されます。 符号化された情報は解読部で使用されます。
すべてのエンコーディングが実行された後、個別インスタンスが以下のように適切に区切られるように、セルフアテンションマップを視覚化できます。言い換えれば、 仕様 どの部分が関連しているかからどのピクセル(赤い点)が適切に分離されているかを確認できます。
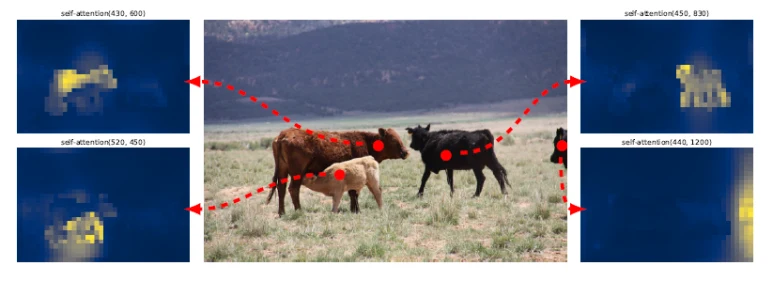
セルフアテンションマップ。 牛4本はきちんと分けられます。
デコーダの機能?
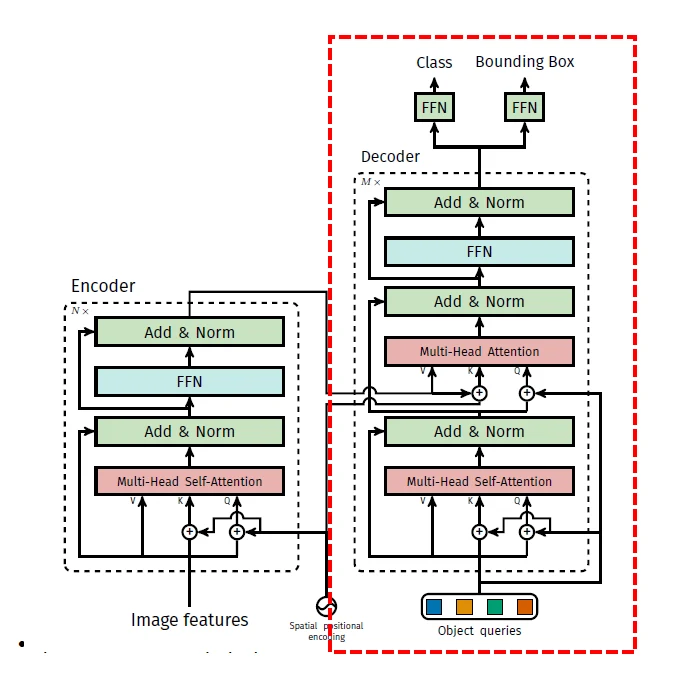
デコーダーは N オブジェクトのクエリを初期入力として受け取り、エンコーダからエンコードされた情報を受信し、画像全体の文脈を把握することができます。.. . エンコーダからエンコードされた情報を受信すると、位置情報も入力され、2Dに存在する実際の画像データの場所情報は適切にエンコード・処理することができます。
デコーダーは、各オブジェクトのクエリで、クラスとバウンディングボックスの情報を単一のインスタンスに出力することができます。 つまり、アーキテクチャは、N の異なるユニークなインスタンスを区別するために構成されます。
結果として、 encoder がグローバルな注意でインスタンスを分離する場合、デコーダーは各インスタンスのクラスと境界線を抽出します。
下図は、デコーダー部のNオブジェクトのそれぞれの注意マップを示しています。 各インスタンスの最後には、注意値が非常に形成されている(青とオレンジで押し込まれる)ことがわかります。.. . この場合、下線はバウンディングボックスに収まることです。
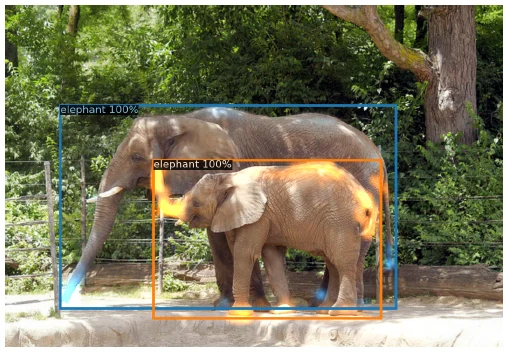
DETRは、大きなオブジェクトのパフォーマンスを発揮しますが、小さなオブジェクトのパフォーマンスが低いです。 DETRの問題点は、学習に時間がかかることです。 そのためには、DETRの学習時間を削減しながら、小さなオブジェクトをうまく処理できる技術を開発する必要があるようです。
この記事は公表時点の情報に基づいています。個別の事情については、当事務所にご相談ください。