
ECCV 2020论文解析:基于Transformer的端到端目标检测。
 如果点击图像,可以看到全文。
这篇文章由Facebook AI团队发表. 比传统的对象检测算法和更具竞争力的架构更简单.这引起了许多人的注意。 这叫做DETR(检测变形器). DETR的特征是:1)它使用二聚函数和2)它使用Transformer,这种Transformer常用于自然语言处理。 没错
这篇文章解决了问题?
现有的物体检测方法过于复杂,并使用多种库. 因此,很难使用现有方法。
例如,为了利用现有的物体探测方法来检测物体,必须考虑到边框的形状,以及边框重叠时如何处理. 让我们从整体上考虑一下,因为它更有效率。
也就是说, 需要一个更简单的架构来解决一个问题,即利用现有的物体检测方法是相当棘手的,这一点在本文中得到了解决.
整个DETR.
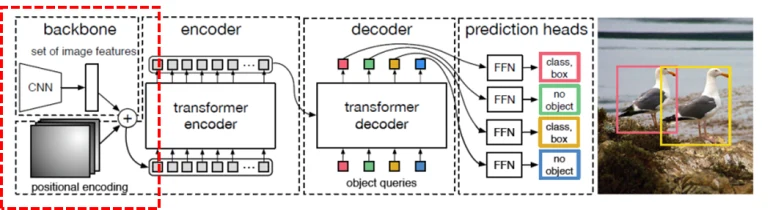
1)一个骨干网络(CNN)用于提取图像的特性,2)一个位置编码用于获取图像中的相对位置信息.
* * *
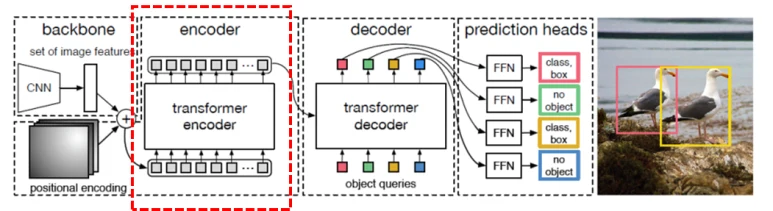
从主干网提取的特性和从位置编码中获得的相对位置信息都是对编码器的输入。在此,每个像素信息对应顺序数据。因此,处理相继数据的合适Transformer被用作编码器。
* * *
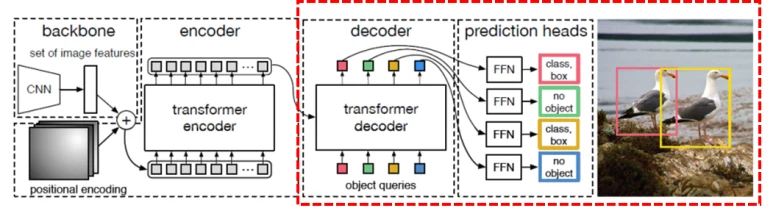
另一方面,编码器的输出和对象查询(一个固定数的学习位置嵌入)是解码器的输入,解码器的输出被传递给生成最终输出的饲料前进网络(FFN). 最终结果值是:1)如果某一对象存在,它包含该对象的类和与该对象存在地相关的边框的信息;2)如果某一对象不存在,则没有对象被表示为一个类,也就是说它不存在.
* * *
使用二进制匹配损失函数,确保最终结果与实际值的匹配成功.贡举志五种 上. 这使得他能够通过匹配的损失函数来检测每一个不重复的事件.
因此,在图像输入时从图像中提取特征,然后加以转换,从而获得实际的物体检测结果,是整个结构.
这是两党的匹配。
过去,设定预测问题使用NMS(非最大悬停)间接解决. 具体来说,设定的预测问题通过找到随机位置,然后将其压缩成一个,而没有指定整个图像中存在多少个对象实例来解决.
然而,根据报告, 设定预测问题。 直接《纽约时报》.
具体地说,设定预测问题通过固定,"只有N图像可以有一个对象实例"来解决.
也就是说, 模型输出N个预测结果,并与真实标注值进行二分图匹配,实现一对一对应,从而解决集合预测问题。.
例如,如果将 N 至 6 标定为整个图像中最多可以有六个对象实例,则在学习过程中执行二进制匹配,这样实例就不会重叠. 在这种情况下,案件不会发生重叠。
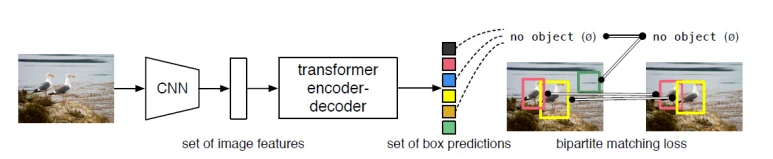
假设两只鸟利用学习过程中拍摄的图像进行物体探测的预测如下:
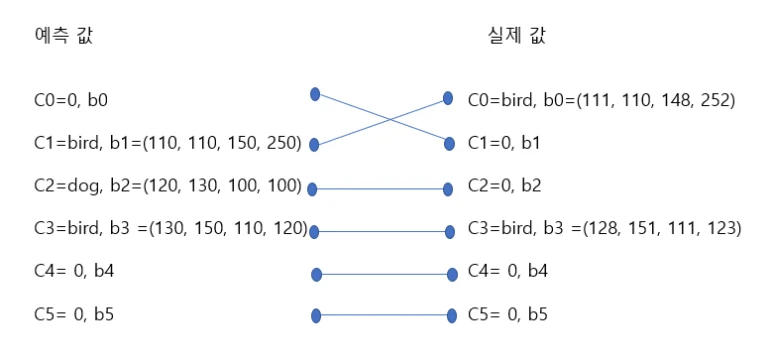
C = 类别
b = 边框信息(x坐标、y坐标、宽度、高度)
因为N=6,预测值为C0至C5.
在此,预测值C2包含错误的结果,在类相同且边框信息相似时,它会配置匹配的损失值以拥有较低的损失值. 而当整个匹配完成后,整个损失值以最低方向进行这一匹配.
根据类和边框信息进行匹配。 (预测值C1与实际值C0匹配,预测值C3与实际值C3匹配,其余没有分类的预测值则随机与其他真实世界值匹配.
在学习过程中,班级的边框信息被教化减少. 然后,如果预测值中存在不正确的预测值(预测值C2),则与没有数据的实际值(预测值C2)相匹配,这样它就可以被无对象区分.
这样,如果学习成功,只能预测对象的位置和数量. 问题由上游问题解决. 如果进行二进制匹配,即使预测结果中每个输出位置(如C1和C3的位置)都会改变,二进制匹配完全不会出现问题,所以会改变顺序,只学习两个边框来检测鸟类,这样可以自然避免事件冗余..
你为什么用变形金刚?
Transformer是用于在列出顺序数据时更好地训练嵌入数据的架构之一。
变频器 1)它通过关注来理解整个图像的上下文信息,2)促进理解图像中每个实例的相互作用.
具体地说,注意机制允许每个像素通过给对方分配注意分数来进行注意,在这种情况下,实例是分开的,并且每个实例都理解上下文.
还有... 变形器用于促进像素与大边框的结合.
即使在自然语言处理中,如果句子的长度偏离,可能也不容易识别出第一个单词和最后一个单词之间的关联. 变形器可以很容易地辨别出本案中的关系. 与图像中的自然语言处理类似,也存在一个问题,使得在远离一个大边框时难以轻易理解像素的关联.
什么是编码器?
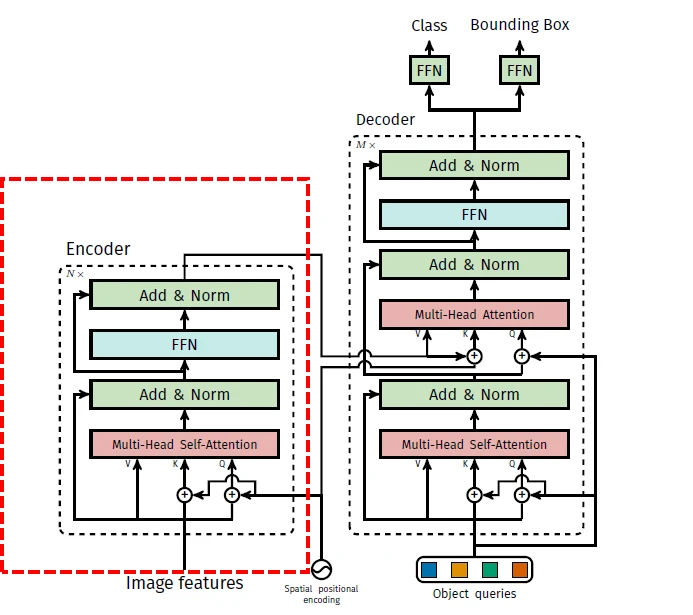
编码器取每个像素的位置数据,包含图像的特征信息,并进行编码.我这样做。 具体地说,编码器接收到一个具有d*HW大小的连续特性图.
(d=图像特性,HW=每个像素位置信息).
此外,可以输入位置编码信息,为2D中的实际图像数据正确编码和处理位置信息.
另一方面,当图像的特征信息输入编码器时,每个像素的交互和关联信息在进行自我注意的同时被学习. 然后在解码部分使用编码信息.
所有编码完成后,您可以直观地看到自觉地图,以看到单个实例被正确区分如下: 换句话说, 具体 您可以看到每个像素( 红色点) 被适当分离出来, 它与哪个部分是相关的 。
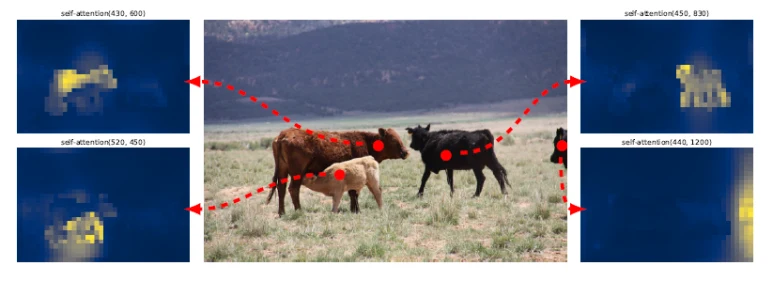
自观之图. 四头牛被适当分离.
解码器的功能?
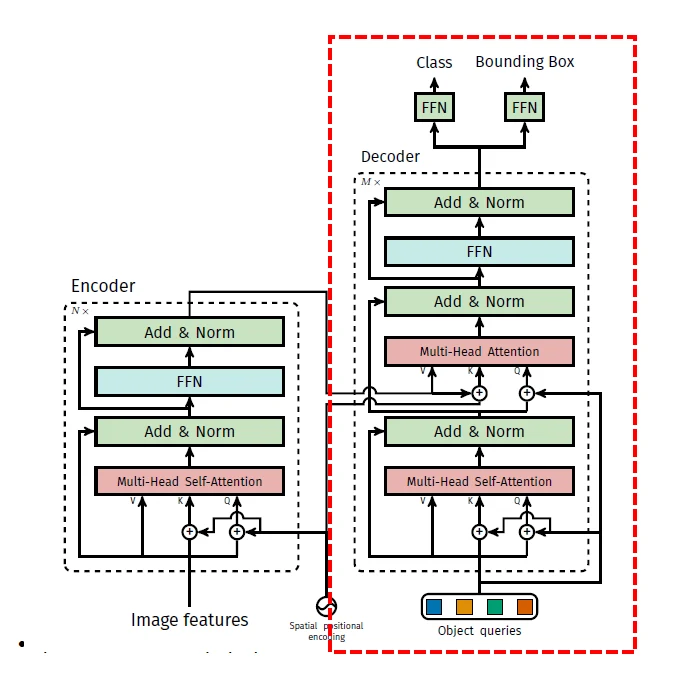
解码器接收N对象查询作为初始输入,接收编码器的编码信息,并能够理解整个图像的背景.。 。 。 。 当从编码器收到编码信息时,位置编码信息也是输入的,对2D中实际存在的图像数据的位置信息可以进行适当的编码和处理.
解码器允许每个对象查询输出一个实例的类和边框信息. 也就是说,一个架构的配置是为了区分N不同的独特实例.
结果, 如果编码器通过全局关注将一个实例分开,解码器会提取每个实例的类和边界.
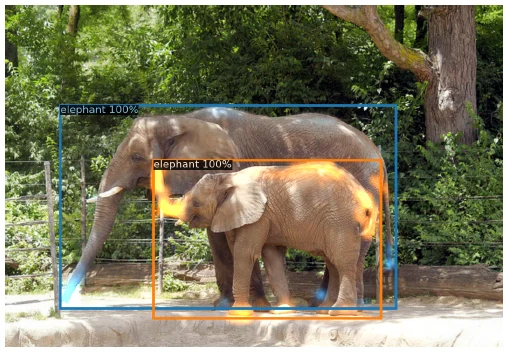
下面的图像显示了解码器部分中每个N对象的注意图. 在每一个实例的结尾,可以看到注意力的溶液值是高度形成的(用蓝色和橙色表示).。 。 。 。 在这种情况下,底线就是让边框适合.
DETR对大对象显示良好的性能,但对于小对象显示的性能较低. DETR的问题在于学习需要相当长的时间. 为了弥补这一点,似乎有必要开发这样一种技术,在减少DETR的学习时间的同时能够很好地处理小物体.
本文基于发表时的情况撰写。如需就具体事项咨询,请联系IPLEX。