
著者:IPLEX 知的財産権法律事務所 金容德, 弁理士
大規模な言語モデルの推論能力を強化するために、報酬ベースの強化学習を適用するケースが急速に増加しています。 現時点ではよく表示される方法は、PPO型方策の最適化です。 GRPO、Dr.GRPO、GSPO、およびREINFORCE++などのアドバンテージ推定または正規化方法を改善する方法は、一般的に、PPO スタイルのクリッピングをデバイスとして使用して、方策が大幅に変化するのを防ぐことができます。
TROLL論文は、この問題に正面から取り組んでいます。新しい報酬関数やアドバンテージ推定器を提案するのではなく、従来のクリッピングをトークン単位のKL信頼領域への射影に置き換えます。「範囲を超えた更新を切り詰める」方法から、「許容範囲内で最も近い確率分布に更新を戻す」方法への変更です。
本記事の1つの一貫した結論TROLLは、さまざまなトークン固有の信頼領域の予測とPPOタイプのクリッピングを交換し、実際に重要である少数のトークンの確率だけを分散させることにより、LM強化学習の安定性、学習速度、および最終的な成功率を向上させる試み方法です。
紙基本情報
「TROLL: Trust Regions Improve Reinforcement Learning for Large Language Models」は、ICLR 2026で発表された論文です。著者はカールスルーエ工科大学とMicrosoft Researchに所属するPhilipp Becker、Niklas Freymuth、Serge Thilges、Fabian Otto、Gerhard Neumannです。PPO方式のクリッピングを微分可能な離散信頼領域への射影に置き換え、数学的推論とコード生成、複数のモデル系列、アドバンテージ推定手法にわたって適用可能性を検証しています。
1。 1。 紙に尋ねた質問: PPO がなぜ再封されるべきか?
LLMの強化学習後学習では、モデルによって生成された応答が評価され、報酬が与えられ、将来的には高い評価がより頻繁に表示されるように方策が更新されます。 問題は、更新率が大きすぎると、モデルの出力分布が突然崩壊する可能性があることです。 トレーニングデータへの小さな変更でも、応答の長さをスパイク、特定のパターンを繰り返すか、多様性を調査してすぐに消える可能性があります。
そのような急速な変化を防ぐため、PPO は新しい方策の確率比と、特定の範囲外に落ちないように古い方策をクリップします。 大規模な学習を実装しやすく、適用しやすいため、広く使われてきましたが、この方法は、元の信頼領域の概念の原始的な近似であるということを著者が指摘しています。 特に、確率比が重要な範囲の外にあるトークンに対しては、勾配が震えているため、「誤った方向に移動した方策を安全な範囲に戻す方法」について、十分な情報が残らない場合があります。
車のクリップと比較すると、速度制限が超過したときにアクセラレータペダル入力を突然切り離すデバイスとクリップが似ています。 それはあまりにも速く行くからあなたを停止することができます, しかし、それはあなたが車が遅くするべきである方向またはスムーズな方法であなたを指示しません. 一方、信頼エリアの投影は、現在の位置から許容領域内の最も近い点を計算し、そこに車を移動することに近いです。 違いは、制御オブジェクトの状態が安全な領域内で明示的に配置されていることです。
PPO型クリッピングとTROLLの違いは以下のとおりです。 PPO スタイルのクリッピングは、重要な範囲内のサンプルトークンの方策比を切断する方法であり、範囲外に落ちると、目的関数と勾配が切断される可能性があります。 理論的には、信頼領域を縦断的に近似する方法であり、別々の分布予測を実行しません。 一方、TROLLは、各トークンの位置の確率分布全体をKL範囲に分割し、境界外にある場合は、許容範囲内の現在の分布に近い分布を計算します。 これは、明示的なKL制約で凸の最適化に近いです, そして、大規模な語彙では、それは、コストを抑制するために、スパーストークン分布を使用します. どちらの方法でも、推論ステップに追加料金はありません。
重要なTROLLは、PPO、GRPO、Dr.GRPO、GSPOなどで「メリットを計算する方法」を置き換えません。 計算されたメリットを使用して、実際にポリシーを更新するために使用されるクリッピング機構を置き換えます。
2。 最初に知る概念:方策、利点、KLの信頼の地帯
2.1 ポリシーは、次のトークンの確率分布です
言語モデルでは、方策は、現在のコンテキストに基づいて、各次のトークンに割り当てられた確率分布です。 たとえば、同じ文脈では「誤り」「熱回復」「しかし」などのトークンは、異なる確率を割り当てられます。 強化学習は、モデルパラメータを調整し、良好な応答に含まれているトークンの確率を高め、悪い応答に含まれているトークンの確率を下げます。
2.2 メリットは、この選択が平均よりもはるかに優れているかを示しています
Merit は、レスポンスやトークンの選択がベースラインの動作よりもはるかに優れているかのシグナルです。 PPO は別の値モデルを使うことができます。GRPO は同じ質問に対する複数の応答を選択し、グループ内の相対的な報酬に基づいてメリットを計算します。 TROLLは、この利点を計算する方法に特異的ではありませんので、複数のアルゴリズムと組み合わせることができます。
2.3 KLの発散は、2つの確率分布がどれだけ異なるかを測定します。
KL divergence は、以前の方策の配布から生じる新しい方策のトークン確率分布のどの位の尺度です。 TROLLは、各出力場所の新規および旧方策間のKLの利息を抑制し、前述のバウンダリ値 εを上回らない。 ここでの制限は、単にサンプルされた単一のトークンの割合を見ていません, しかし、むしろ、その場所で考慮したトークンの分布.
2.4 トラストゾーンは、1つのアップデートで許可された変更の半径です。
信頼領域は、一回の学習で方策の変化をどの程度まで許容するかを定める範囲です。狭すぎると学習が遅くなり、広すぎると方策が大きく変化して不安定になる可能性があります。論文でも、εが保守的すぎると速度が低下し、大きすぎると最終成功率が悪化する傾向を確認しています。
式なしで覚えておくべきポイントTROLLの目標は、古いものと同じ新しいポリシーを作ることではありません。 計画は、補償に沿って十分に動くことですが、許可されたKLの半径が一度に上回っている場合、最も近い安全な配分にのみ調整します。
3。 TROLLのコアアイデア:プロジェクトは、カットしません。
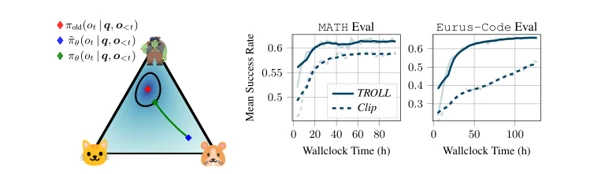
図1(原論文の図1)。左は3トークンの分布における旧方策・新方策・射影後の方策の関係、右は数学とコードの評価におけるTROLLとClipの学習速度の比較です。出典:Beckerら、ICLR 2026、原論文2ページ。
絵の左側を簡単に読み込む方法
三角形の3つの頂点は、すべての確率が3つのトークンに集中する極端なケースを表します:猫、トロール、ハムスター。 赤い点は、データを収集する際に使われる前の方策であり、青色の点は、現在のパラメータの更新で作成された新しい方策です。 新しい方策がハムスターに向かってあまりにも遠くに移動し、自信のゾーンを残した場合、TROLLは、青い点から円の中の最も近い緑色の点に確率分布を移動します。
重要なポイントは、これは必ずしも以前の方策に戻すという意味ではありません。 新しい方策が信頼できるゾーン内にある場合、それはそのまま残され、それが外側にあるときにのみ最小限に修正されます。 そのため、報酬に基づいて学習の方向性を維持しながら、1つの更新が大きすぎないようにします。
絵の右側が言うもの
GRPOでQwen3-14Bを学習させた実験では、実線で示されたTROLLが、点線で示されたClipよりも早く高い成功率に到達しています。特にコード生成では、同じ経過時間で比較した場合の差が大きく表れています。この結果は、最終スコアだけでなく、学習時間の効率も改善したという論文の主張を裏付けています。
クリッピングでは範囲外の更新の勾配が弱まったり途切れたりする一方、TROLLは射影による制約の下でも微分情報を維持します。これが安定性だけでなく学習効率の改善につながるというのが、論文の中心的な仮説です。
4。 TROLLの実際の処理フロー
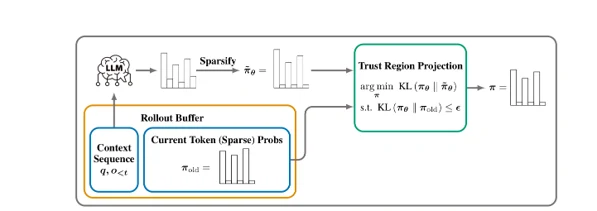
図2(原論文の図2)。現在のLLMと、ロールアウトバッファに保存された旧方策の確率分布をスパース化した後、KL信頼領域への射影により学習に用いる分布を計算します。出典:Beckerら、ICLR 2026、原論文4ページ。
ステップ1. 前の方策を保存 ロールアウトバッファのレスポンスを生成するときに使用される方策のトークン確率を格納します。 新たな方策がいかに異なるかを判断するためのベンチマークとなります。
ステップ2。 現在のポリシーの確率分布を再計算します。 同じ応答データを使用して更新される現在のモデルのトークン確率を計算します。
ステップ3。 両方の分布をスパースします。: 語彙全体を格納する代わりに、確率のほとんどを占めるトップトークンだけを残します。
ステップ4. 現在の分布が以前の分布から ε 以上であるかどうかをチェックしてください。 境界内にある場合、投影は行いません。
ステップ5. 境界線を越えたプロジェクト分布のみ。 境界が交差している場合は、現在の分布に最も近い分布を計算し、同時に前のポリシーの周りの信頼領域内にある。
ステップ6. プロジェクトの配布で方策を更新します。 投影された分布は、方策比を計算するために使用され、元のモデル出力が投影結果に続くように回帰期間も追加されます。
回帰項が必要な理由は、方策比率に射影後の分布だけを用いると、LLMが実際に出力する射影前の分布が信頼領域の外に残る可能性があるためです。論文では、射影結果を目標値とし、元の出力をそこに近づける回帰項を加えて、次の更新の安定性を確保します。
5。 5。 数学なしで理解するトラストエリアの予測
5.1 現在のポリシーと前のポリシーの最も近い妥協
簡単に言えば、問題TROLLは、2つの条件を同時に満たす確率分布を見つけることです。 まず、現在のモデルは、作成したい新しいディストリビューションにできるだけ近いものでなければなりません。 第二に、データ収集に用いられる前のポリシーから、KL の境界 ε 以上は行わないでください。 この問題は、convexの最適化フォームで書かれており、このソリューションは、現在のポリシーと以前のポリシーのログ確率の幾何学的補間です。
5.2 投影強度はトークン位置からトークン位置まで自動的に変わります
現在の分布が安全な領域内にある場合、投影強度は0で、何も変更しません。 逆に、境界線から著しく逸脱した場合、以前のポリシーの方向性を引き上げます。 この強度を決定する値は、単一のスカラー最適化の問題に変換されるため、高次元の最適化全体を直接解決するよりもはるかに効率的に計算できます。
5.3 なぜ異なる投影が重要である
強化学習では、最終的な損失からモデルパラメータへの勾配がなければなりません。 TROLLは、数値最適化を投影プロセスに組み込まれていますが、KKT条件と暗黙の区別を使用して、モデル出力で最適な投影強度が変化する方法を計算します。 これにより、学習グラフのレイヤーとしてプロジェクション自体を処理できます。
仮説例では、正しい候補トークンの確率が前のポリシーで0.45であったり、現在のポリシーで0.60に増加した場合、TROLLは報酬方向を維持しますが、KLの境界内にある場合は変更を維持します。 他の影響力のあるトークンが 0.35 から 0.15 まで大幅に低下すると、変更が過剰な場合、それらの一部が復元され、残りのトークンが 0.20 から 0.25 に変更されると、確率分布全体が有効であるように、それらは一緒に正規化されます。
簡単に誤解できるものTROLLは、各トークンの確率を上限と下限に個別に調整する簡単なカットではありません。 確率が1にまとめた全カテゴリー分布を考えると、KL制約を満たす有効な分布が1つあります。
6。 。 150,000を超えるトークン候補を処理する方法
原理上は、応答の各トークンについて語彙全体の確率分布を保存し、KL射影を行う必要があります。論文で例示されたQwen3のトークナイザーには151,936の候補があります。長い応答と大きなバッチを考えると、すべてのロジットをそのまま保存することは、メモリと計算量の面で現実的ではありません。
6.1 確率質量のほとんどは、いくつかのトークンに集中しています
言語モデルの次トークン分布では、多数の候補のうち少数に高い確率が集中します。論文では最大K個の候補を選び、累積確率が1−δに達するまで残します。既定値のK=64、δ=10⁻⁵では、平均5~10トークンで99.999%を超える確率質量を保持できると報告しています。
6.2 実際に選択したトークンは、後ろに残さなければならない
確率の高いトークンだけを残すと、低確率でサンプリングされた実際の応答トークンが除外されることがあります。しかし、強化学習における方策の確率比と勾配は、実際に生成されたトークンに直接依存します。そのため、TROLLでは、確率順位にかかわらず、モデルが選択したトークンを疎な集合に含めます。
6.3 捨てられたトークンは完全にゼロになりません
スパース化で除外したトークンの確率を0にすると、KLダイバージェンスの計算が不安定になる可能性があります。論文では、除外トークンに小さな基底確率を与え、残したトークンと併せて再正規化します。また、長い系列でメモリ使用量が急増しないよう、チャンク単位でスパース化します。
疎化では4つの仕組みを組み合わせます。上位K個の制限は、高エントロピー時に保存するトークン数の上限を設けるもので、論文の既定値はK=64です。累積確率質量を十分に保持した時点で選択を止め、既定のしきい値はδ=10⁻⁵です。サンプリングされたトークンは方策比と勾配の計算に必要なため必ず含めます。除外されたトークンにも、完全な0ではなく微小な既定確率pd > 0を与えます。
関係のスペシャリティそのものを組み合わせるよりもむしろ、特許実務に注目すべきである「各トークンの信頼領域を予測できる説得力のある表現」の目的であり、確率的質量基準、トップK、実際のサンプルトークンを強制的に含ま、再正規化は技術的特徴であるようにまとめられている。
7。 実験はどのように設計されましたか?
ペーパーは数学的な推論およびコード生成のためのRLVR環境のTROLLそして既存のクリップを比較します。 結果が特定のモデルや特定のアドバンテージ推定器に合わせられなかったことを確認し、モデルファミリー、パラメータスケール、データセット、および強化学習アルゴリズムの幅広い範囲で実験しました。
MATH500・AMC・AIME・OMNIMATH・OlympiadBench・Minerva、GSM8K、Eurus-MathのMATH500・AMC・Aime・OMNIMATH・OLYMPIAdBench・Minerva、 GSM8K、EユーラスMathから成る実験的なデータとモデル構成を見ると、Eユーラス-2-RL-Codeが使われました。 Qwenシリーズには、Qwen3 0.6B・1.7B・4B・8B・14B・Qwen2.5 0.5B・1.5B・3B・7Bが含まれています。 また、Llama 3.1・3.2、SmolLM3、Apertus、FineMath-Llamaなどと比較しました。 ポリシーの最適化方法は、GRPO、PPO、Dr.GRPO、GSPO、およびREINFORCE++をカバーし、適応型クリップBAPOと非クリッピングGPGを組み合わせる可能性も検討されました。
この実験の重要な質問は、TROLLがわずかにスコアを増加させるかどうかではありません。 学習中の崩壊を抑え、他のアルゴリズムやモデルで繰り返す、計算コストが戻ってくるかを検証します。
8月8日 Qwenモデルのパフォーマンス変更
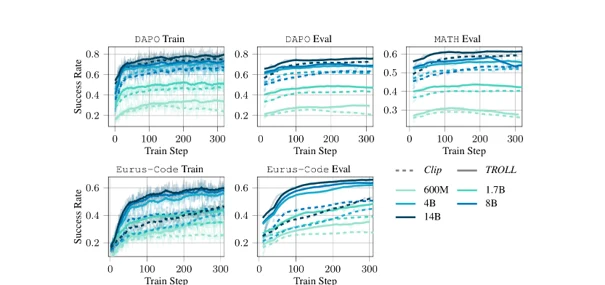
図3(原論文の図3)。Qwen3の600Mから14Bまでを対象に、実線でTROLL、点線でClipを示しています。DAPOの学習・評価、MATH評価、Eurus-Codeの学習・評価では、全体としてTROLLの曲線がより速く、より高く上昇しています。出典:Beckerら、ICLR 2026、原論文7ページ。
8.1 3〜10パーセントポイントで改善された数学的推論。
論文は、DAPO-Mathの実験で、TROLLの結果がClipを概ね3~10ポイント、相対値では約5~15%上回ったとまとめています。小規模モデルから14Bまで同じ方向の改善が見られ、学習セットだけでなくDAPO評価とMATH評価でも差が確認されました。
8.2 コード生成でギャップがより大きい
Eurus-Codeは、7〜18パーセントのポイントの改善、または18〜30パーセントの相対的な用語の改善を報告しました。 Qwen3-1.7B TROLLモデルがQwen3-4Bクリップモデルよりも高い結果を示す例を示します。 これにより、更新方法の安定性が向上し、モデルサイズを増加させるよりも効果が大きいことがわかります。
8.3 小さなTROLLモデルが大きいクリップモデルに近いケース
数学実験では、Qwen3-4B TROLLモデルは、Qwen3-14Bクリップモデルに近い性能を示しています。 もちろん、この結果だけでは、より小さいモデルがより大きなモデルを置き換えることはできない。 しかし、パラメータサイズとして、後学習アルゴリズムの選択がパフォーマンス変数として重要なことを明確に示しています。
9 月 9 日 利点を推定する方法が異なっている場合でも、効果は維持されますか?
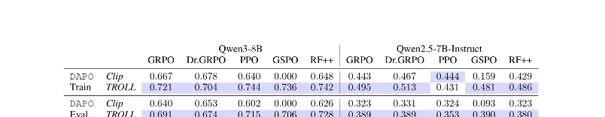
表1(原論文の表1)。Qwen3-8BとQwen2.5-7B-InstructにおけるGRPO、Dr.GRPO、PPO、GSPO、REINFORCE++のClip版とTROLL版の比較です。出典:Beckerら、ICLR 2026、原論文8ページ。
テーブルの最も注目すべき部分は、GSPOです。 Qwen3-8B で GSPO とクリップを組み合わせると、成功率は事実上ゼロに崩壊しましたが、TROLL は 0.706 の DAPO 格付けで結果しました。 Qwen2.5-7B-Instructでも、GSPO ClipはTROLLの安定学習中に低結果を示した。
他のアルゴリズムでも、TROLLは概ね成功率を改善しました。検証範囲では、アドバンテージ推定手法を変更するより、ClipをTROLLに置き換える方が大きな改善につながる場合が多いと論文は説明しています。特定の推定手法の補助手段ではなく、方策更新層で共通に利用できる安定化手法であることを示しています。
特にQwen3-8BのDAPO評価、GRPOでは、クリップは0.640からTROLL 0.691に0.051増加し、PPOでは、0.602から0.715に0.113増加しました。 GSPOは、クリップで0.000に学習中に崩壊しましたが、TROLLで0.706を記録することによって学習を回復しました。 また、クリップ0.626からTROLL 0.728に0.102で増加したREINFORCE++。
通訳のポイント
TROLLは「より良いアドバンテージ推定者」ではなく、「アドバンテージ推定結果を反映したより原則的な制約方法」ではありません。したがって、さまざまなアドバンテージ推定方法に効果が再現されるかどうかが重要です。
10月10日 モデルシリーズが変化しても効果は維持されますか?
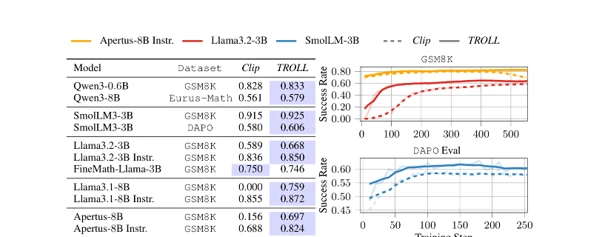
図4(原論文の図4)。Llama、SmolLM3、ApertusなどのモデルとGSM8K・DAPOの組合せで、TROLLとClipの最終性能・学習曲線を比較しています。出典:Beckerら、ICLR 2026、原論文9ページ。
TROLLのメリットは、Qwenシリーズに限定されません。 特に、既存のクリップで少し学習信号を示したモデルには大きな違いがありました。 Llama3.1-8B の GSM8K の結果はクリップ 0.000 から TROLL 0.759 に改善され、Apertus-8B は 0.156 から 0.697 に改善しました。 Apertus-8B-Instructも0.688から0.824に増加しました。
一部のLlamaモデルでは、Clipを用いた学習で性能が改善し始めるまでに時間を要する一方、TROLLでは早い段階で学習の効果が表れています。モデル系列を変えても、論文が重視する学習の速さと更新の安定性が観察されています。
しかし、すべての組み合わせは必ずしも良いわけではありません。 FineMath-Llama-3BのGSM8Kの結果は、クリップ0.750とTROLL 0.746でほぼ同じか少し下がりました。 この例外は、TROLLは、常にパフォーマンスを保証する1つのサイズのフィットオール式ではなく、従来のクリッピングが非常に不安定な環境で特に価値のある方法であることを示しています。
信頼できる論文を読むための基準は、良い結果を選ぶのではなく、改善の量が小さい場合や例外を見るべきです。 この論文の説得力は、すべてのセルで勝つことではありませんが、学習安定性の改善は、さまざまなモデルやアルゴリズムで繰り返し観察されます。
11月11日 ハイパーパラメータ、エントロピー、計算コスト分析
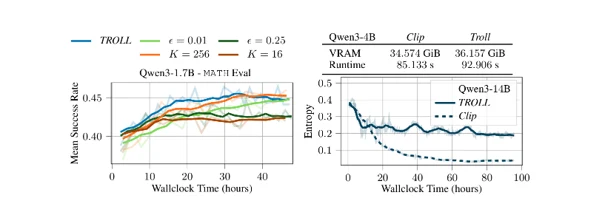
図5(原論文の図5)。左はKL境界と残すトークン数に応じた性能、右上はメモリ使用量と実行時間、右下は学習中のエントロピーの変化です。出典:Beckerら、ICLR 2026、原論文10ページ。
11.1 KL バウンダリー ε
εが小さすぎると更新が保守的になり、学習が遅くなります。大きすぎると方策が一度に大きく変化し、最終性能が低下する可能性があります。論文では、適度に小さく保守的な範囲であれば、収束時の性能は比較的安定していると説明しています。
11.2 ラズパライゼーションアッパーバウンドK
K=16 は、分布全体が十分に近似しなかったため、不断に行われました。 K=256 は計算費用を増加させますが、デフォルトの K=64 上で重要な性能の利益を持っていません。 言い換えれば、重要な十分なトークンを保存する間のバランスが取れる必要がありますが、あまりにも多くのトークンを必然的に保存しない必要があります。
11.3 エントロピー保存
クリップは、学習が進行するにつれて急速に減少するトークン分布のエントロピーの傾向を示しました。 既に知っているいくつかのパターンに確率を集中する現象として解釈できます。 TROLLは、成功率を高めながら、より高いエントロピーを維持します。 コード生成実験では、エントロピーの保存と性能向上の相関性も観察しました。
11.4 管理された環境で測定される付加的な費用
制御環境で測定された追加のコストを見ると、VRAMの使用量はクリップ34.574 GiBからTROLL 36.157 GiBに増加し、約4.6%の追加メモリを必要とします。 実行時間がクリップ85.133秒からTROLL 92.906秒に増加し、約9.1%の増加。
学習段階では追加の計算コストが生じます。ただし、論文ではスパースな分布を用いて増加を抑えています。このコストは主にモデルのパラメータ数ではなく語彙の大きさに依存するため、大規模モデルほど総学習コストに占める割合は小さくなると説明しています。推論時はTROLLの射影を用いないため、追加コストはありません。
12月12日 論文の結果を解釈するときに留意すべきこと
12.1 TROLLは、推論構造を変える方法ではありません
TROLLは事後学習段階の方策更新手法であり、モデル構造の変更や推論時のモジュール追加ではありません。学習後のモデルの推論処理と遅延を従来どおりに保てる点が、論文で示された利点です。
12.2 それは補償の設計問題を解決しません
報酬関数がうまく設計されていない場合、または、ベリファイアーが悪い場合、モデルは誤った目的を確実に最適化することができます。 TROLLは、ポリシーが大幅に変更されないことを保証するデバイスですが、良い応答とは何かを定義する報酬自体を修正しません。
12.3 実験の規模は数学とコード RLVR に焦点を合わせます
論文は複数のモデルの家族やアルゴリズムをカバーしていますが、タスクは主に数学的な推論と正しい答えを検証できるコード生成です。 人間の好みが複雑な役割を果たす一般的なRLHF、長期会話、ツール使用のエージェント、および視覚言語モデルで同じ効果が見られるかどうかをさらに検証する必要があります。
12.4 最大14Bの密モデルを検証
最大14Bの密なモデルで実験した作者。 Vocabulary分布、並列、通信コスト、および散乱誤は、より大きなモデルとMoE構造で異なる可能性があります。 著者はまた、フォローアップ研究トピックとしてこれを提案します。.
12.5 スパースの確率分布が十分に割り当てられていると仮定することが重要です。
TROLLの実用性は、確率の大部分のトークンアカウントの数が少ないプロパティに依存しています。 特別なタスクや、高エントロピーの出力が頻繁なマルチモーダルトークン分布の場合、平均5〜10トークンが十分でない場合があります。 この場合、K と δ または別のスパサフィング戦略を調整する必要があります。
TROLLが「クリップよりもはるかに優れている」と言うよりもバランスの取れた評価むしろ、より正確であり、明示的な信頼領域の予測は、クリッピングが不安定であるか、勾配の損失が大きい状況で有利である可能性があるという広範な実験を通してそれを読むことです。
13 . . 人工知能特許に特化した特許弁理士の視点からの技術分析
以下は、論文に開示された情報に基づく予備的な技術分析です。実際の新規性・進歩性や権利範囲を判断するには、先行技術調査と出願の経過確認が別途必要です。
13.1 技術的課題と解決への対応
技術的課題とソリューションの対応を検討し、PPO クリップのヒューリスティック制約とグラデーション損失の問題、トークン単位の KL 信頼領域の分岐を明示的に制限し、制約された領域でもグラデーションを維持しながら、更新幅を明示的に制限するために適用される。 語彙分布全体を写し出すときに発生するメモリと計算の負担のために、確率の質量基準とトップKを組み合わせたスパース分布は、現代のLLMの語彙サイズであっても、実用的なコストで投影できるようにします。 数値最適化が学習グラフを破る問題については、KKT条件ベースの暗黙差と異なる予測を適用して、ポリシー損失からモデルパラメータへのエンドツーエンド学習を有効にします。
また、投影分布と実際のLLM出力のギャップがあると、投影結果を標的する回帰的な用語は、その後の更新で、信頼領域に近い非投影方策を駆動するために使われます。 特定のアドバンテージ推定方法に依存する問題については、メリット計算方法を想定しない方策更新構造で、PPO、GRPO、Dr.GRPO、GSPO等との互換性を確保しています。
13.2 差分は、個々の要素よりも組み合わせて依存する可能性が高い
信頼領域とKL制約はTRPO系で以前から知られる概念です。射影を用いた強化学習、カテゴリ分布、上位トークンのスパース化、OptNet型の微分可能な最適化にも先行研究があります。そのため、論文で注目すべき点は、これらをLLMのトークン単位の方策更新に結び付けた具体的な組合せです。
特に、以前の方策と現在の方策の稀有なトークンの確率を格納、ソート、および再正規化するフローは、境界違反トークンの位置だけを選択することにより、一次元のデュアル問題を解決し、方策比と回帰目標の投影分布を使用して、単純な「KLペナルティを追加」とは異なる実装構造です。
13.3 技術の有効性を支える実験的なデータが重要である
この分野では、数学的な構成に加え、学習性能の低下の防止、エントロピーの維持、実際の経過時間、メモリ使用量の増加、複数のアルゴリズムでの再現性が重要です。明細書や技術資料では、精度の向上だけでなく、Clipが機能しない条件での安定化、スパース化による誤差、射影が発生する割合、境界値の変更に伴う収束特性を示すと、技術的意義を説明しやすくなります。
14 日 結論:TROLLによって示される後学習の次のタスク
TROLLが示すのは、LLMの強化学習の性能を改善するには、報酬モデル・データ・アドバンテージ推定器だけでなく、方策を実際に更新する最終的な規則も見直す必要があるということです。PPOのクリッピングは便利で実績のある選択肢ですが、信頼領域の原理を粗く近似する過程で、不安定性や勾配の損失を生じさせることがあります。
TROLLは、各トークンの分類的確率分布に関するさまざまなKL予測でこの問題を解決し、大規模な語彙から生じるコストは、スパースレーションによって削減されます。 その強みは、数学的推論とコード生成における複数のモデルとアルゴリズムを横断して、より速く学習、より高い最終的な成功率、学習の決定の緩和、および不作物の保存を実証する能力にあります。
特許の観点から、LMトークンの配布、境界違反の決定、二重問題に基づく投影、暗黙の区別、方策比率と回帰の観点から、信託地域や散布などの個々の言葉ではなく、方策の比率と回帰の観点全体を見ることが重要です。 同時に、前述の多くの要素を持つ分野であるため、特定の組み合わせの関係と有効性の証拠に基づいて権利を得る実際の可能性を判断する必要があります。
より大規模なモデル、MoE、一般的な選好学習、ツールを使うエージェント、マルチモーダルモデルでも同じ原理がどこまで有効かは、今後の検証課題です。本論文は、クリッピングを当然の前提としてよいかを問い、現代のLLMの規模で信頼領域手法を実装する現実的な方法を示しています。
最終的なサマリーTROLLは、単に方策の更新をトランクしていませんが、許されたKLの信頼領域に確率分布を最小限にプロジェクトします。 Sparse logitと異なるソルバーを組み合わせることで、現代のLLMに適用されるコストで実装され、さまざまな数学とコード実験でクリップよりも安定した学習がより速くなりました。
情報源・利用情報
原文: https://arxiv.org/pdf/2510.03817
論文引用:フィリップ・ベッカー、ニクラス・フレユムス、セルジ・ティルゲ、ファビア・オット、ゲルハルト・ノイマン、「TROLL: トラスト・リージョンは、大規模なランゲージ・モデルの強化学習を改善する」ICLR 2026。
本稿は、添付論文の内容を整理した技術解説です。個別の法的判断や特許性についての法律意見ではありません。実際の検討では、関連する出願書類と先行技術を別途調査する必要があります。
この記事は公表時点の情報に基づいています。個別の事情については、当事務所にご相談ください。