
作者:IPLEX知识产权法律事务所 金容德专利代理师
基于奖励的强化学习正广泛用于提升大语言模型的推理能力,PPO式策略优化是其中的常用方法。GRPO、Dr.GRPO、GSPO和REINFORCE++等方法调整优势估计或归一化方式,通常仍通过PPO式裁剪,防止单次更新使策略发生过大变化。
TROLL论文直接讨论这一问题。它没有提出新的奖励函数,也没有重新设计优势估计器,而是以词元级KL信赖域投影取代长期沿用的裁剪机制。其思路是:不再直接截断越界更新,而是将其调整为允许范围内最接近当前分布的概率分布。
核心结论:TROLL以可微的词元级信赖域投影取代PPO式裁剪,并通过稀疏化保留关键词元概率,尝试提升大语言模型强化学习的稳定性、训练速度与最终成功率。
论文基本信息
论文题为“TROLL: Trust Regions Improve Reinforcement Learning for Large Language Models”,发表于ICLR 2026。作者为Philipp Becker、Niklas Freymuth、Serge Thilges、Fabian Otto和Gerhard Neumann,来自卡尔斯鲁厄理工学院与微软研究院。论文以可微的离散信赖域投影取代PPO式裁剪,并在数学推理、代码生成、多个模型家族及不同优势估计方法中验证其适用性。
1. 论文提出的问题:为什么重新审视PPO裁剪?
在大语言模型的强化学习后训练中,系统评价模型生成的回答并给予奖励,再更新策略,使高奖励回答更容易出现。但更新幅度过大,可能导致输出分布突然崩溃。即使训练数据只有小幅变化,也可能出现回答长度激增、特定模式重复或探索多样性迅速下降。
PPO通过裁剪新旧策略的概率比来约束快速变化。这种方法易于实现,也便于大规模训练,但论文指出,它只是对信赖域原则的启发式近似。概率比越界时,相关词元的梯度可能被截断,难以保留足够的信息,引导已经偏离的策略回到安全范围。
以驾驶为例,裁剪类似于超速时切断油门输入:它能限制加速,却未必说明应向哪个方向、以何种方式平稳减速。信赖域投影则根据当前位置,计算允许区域内最近的点,再将状态调整到该点,从而明确满足约束。
PPO式裁剪约束采样词元的策略概率比;越界时,目标函数的相应贡献及梯度可能被截断。它以启发式方式近似信赖域,不单独执行分布投影。TROLL则在每个词元位置对概率分布施加KL约束:若分布越界,就求解允许区域内最接近当前分布的分布。这是具有显式KL约束的凸优化问题,并通过稀疏词元分布控制大词表的计算成本。两种方法都不会在推理阶段增加相应开销。
需要区分的是,TROLL并不改变PPO、GRPO、Dr.GRPO或GSPO中的优势计算方法,而是替换利用优势值更新策略时所采用的裁剪机制。
2. 基本概念:策略、优势与KL信赖域
2.1 策略是下一词元的概率分布
在语言模型中,策略根据当前上下文,为各个候选下一词元分配概率。例如,同一上下文中的“正确”“因此”“但是”会获得不同概率。强化学习通过调整模型参数,提高较好回答中相关词元的概率,降低较差回答中相关词元的概率。
2.2 优势:本次选择相对基准有多好
优势用于衡量一个回答或词元选择相对于基准表现的优劣。PPO可使用单独的价值模型;GRPO则为同一问题生成多个回答,根据组内相对奖励计算优势。TROLL不限定优势的计算方法,因此可与多种算法结合。
2.3 KL散度:衡量两种概率分布的差异
KL散度衡量新策略的词元概率分布相对于旧策略分布的偏离程度。TROLL要求每个输出位置的新旧策略KL散度不超过预设边界ε。约束对象是该位置所考虑的词元分布,而非仅检查某个采样词元的概率比。
2.4 信赖域:单次更新允许的变化范围
信赖域规定一次训练更新中策略可以偏离的范围。边界过小,训练进展较慢;边界过大,策略可能变化过快而失去稳定性。论文也观察到,ε过于保守会降低训练速度,过大则可能影响最终成功率。
无需公式也能理解其核心:TROLL并非要求新旧策略完全相同,而是允许策略沿奖励改善的方向更新,仅在超出KL边界时,将其调整到允许区域内最近的分布。
3. 核心思想:以投影取代裁剪
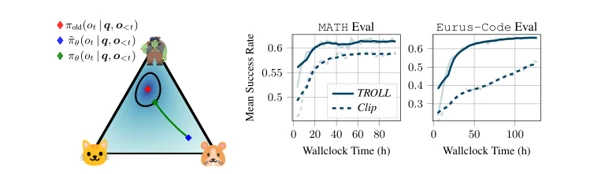
图1(论文图1):左侧展示三个词元的概率分布中新旧策略与投影后策略的关系;右侧比较TROLL与Clip在数学及代码任务中的训练速度。来源:Becker等,ICLR 2026,原文第2页。
如何理解图中左侧的分布变化
三角形的三个顶点分别代表概率全部集中于cat、troll或hamster的极端情况。红点为采集数据时的旧策略,蓝点为参数更新后的新策略。若新策略过度偏向hamster并越出信赖域,TROLL会将蓝点投影到允许区域内最近的绿点。
投影并不等于退回旧策略。新策略位于信赖域内时保持不变,越界时才作最小必要调整,因此既保留奖励引导的更新方向,也限制单次更新的幅度。
图中右侧的训练速度比较
在使用GRPO训练Qwen3-14B的实验中,实线表示的TROLL比虚线表示的Clip更快达到较高成功率。代码生成任务在相同实际运行时间下的差距尤其明显。这支持了论文关于最终性能与训练时间效率均有所改善的结论。
裁剪可能削弱或截断越界更新的梯度,而TROLL在投影约束下仍保留可微信息。论文的核心假设是,这有助于同时提高训练效率与稳定性。
4. TROLL的实际处理流程
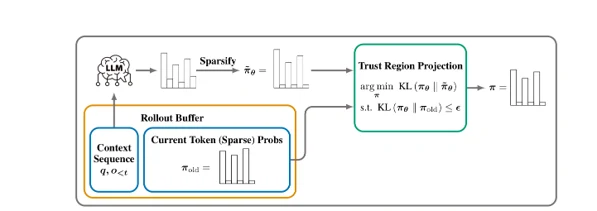
图2(论文图2):旧策略的稀疏概率保存在采样缓冲区中;训练时计算当前策略的稀疏分布,再执行KL信赖域投影。来源:Becker等,ICLR 2026,原文第4页。
步骤1:采样时保存旧策略信息。模型生成回答时,除采样词元外,还将旧策略的稀疏概率分布保存在采样缓冲区中。
步骤2:训练时重新计算当前策略。利用当前模型参数,重新计算同一上下文中的词元概率分布。
步骤3:对新旧策略分布进行稀疏化。不保存完整词表,而是保留承载主要概率质量的候选词元,降低内存与计算开销。
步骤4:检查KL边界。比较当前策略与旧策略,判断各词元位置的KL散度是否超过ε;未越界时无需投影。
步骤5:仅投影越界分布。对于超出边界的位置,计算允许区域内最接近当前策略的分布;未越界的位置保持不变。
步骤6:利用投影结果计算损失。将投影分布用于策略概率比,并加入使实际策略接近投影目标的回归项。
回归项很重要:未经投影的模型输出仍可能位于信赖域外。以投影结果作为目标,可以引导实际模型在后续更新中接近允许区域。
5. 不用公式理解信赖域投影
5.1 在约束内寻找最接近当前策略的分布
TROLL将投影表述为凸优化问题,在满足旧策略KL边界的前提下,寻找最接近当前策略的分布。其解可理解为在新旧策略的对数概率之间进行几何插值。
5.2 投影强度随词元位置而变化
当前分布位于信赖域内时,投影强度为0,分布保持不变;越界越明显,调整就越偏向旧策略。求解投影强度可转化为单一标量优化问题,比直接求解整个高维优化问题更高效。
5.3 为什么投影需要可微?
强化学习需要将最终损失的梯度传递至模型参数。TROLL在投影中引入数值优化,并利用KKT条件及隐式微分,计算最优投影强度如何随模型输出变化,从而使投影成为计算图中的一层,支持端到端训练。
例如,某正确候选词元的概率由旧策略中的0.45增至0.60,若仍满足KL边界,TROLL会保留这一奖励引导的变化。另一词元从0.35降至0.15,若变化过大,则适当恢复;第三个词元从0.20变为0.25时,也需共同归一化,使整体分布有效并满足约束。
投影后的概率仍需总和为1,并满足相对于旧策略的KL边界。因此,它处理的是整个类别分布,而非相互独立地限制单个概率。
6. 如何处理超过15万个候选词元?
Qwen3分词器的词表包含151,936个词元。若在每个输出位置保存并投影完整词表的分布,内存与计算开销都会很大。
6.1 少量词元承载大部分概率质量
语言模型的下一词元分布通常非常尖锐。虽然候选词元很多,实际获得较高概率的仅有少数。论文最多选取K个候选词元,并仅保留到累积概率质量达到1-δ为止。默认K=64、δ=10⁻⁵时,论文报告平均仅需5至10个词元即可保留99.999%以上的概率质量。
6.2 必须保留实际采样的词元
即使采样词元的概率较低,也必须纳入稀疏分布,因为策略概率比与梯度计算依赖该词元。
6.3 未保留词元的概率不能简单设为零
将稀疏集合之外词元的概率设为0,可能导致KL散度计算不稳定。论文为这些词元保留极小的基础概率,再与其余词元共同归一化;同时分块执行稀疏化,避免长序列处理时出现过高的内存峰值。
稀疏化结合了四种机制。Top-K限制为高熵情况下保留的词元数量设置上限,论文默认K=64。当累积概率质量得到充分保留时停止选择,默认阈值为δ=10⁻⁵。采样得到的词元始终包含在稀疏集合中,因为计算策略比和梯度需要它。被排除的词元仍获得微小的默认概率pd > 0,而非严格为零。
从专利分析角度看,重点不仅是“使用稀疏分布”,还包括概率质量阈值与Top-K的结合、采样词元的强制保留、重新归一化及其在后续投影中的具体处理流程。
7. 实验如何设计?
论文在数学推理与代码生成的可验证奖励强化学习(RLVR)环境中比较TROLL与Clip,并采用不同模型家族、参数规模、数据集和强化学习算法,检验效果是否依赖特定模型或优势估计器。
实验在数学领域使用DAPO-Math、由MATH500、AMC、AIME、OMNIMATH、OlympiadBench、Minerva组成的MATH评测组,以及GSM8K和Eurus-Math;代码领域使用Eurus-2-RL-Code。Qwen系列包括Qwen3的0.6B、1.7B、4B、8B、14B和Qwen2.5的0.5B、1.5B、3B、7B。此外,还比较了Llama 3.1和3.2、SmolLM3、Apertus及FineMath-Llama。策略优化方法涵盖GRPO、PPO、Dr.GRPO、GSPO和REINFORCE++,并研究了与自适应裁剪BAPO及无裁剪GPG结合的可能性。
实验不仅关注最终得分,还检验训练是否更快、崩溃是否减少、效果能否跨算法与模型复现,以及为此增加了多少计算成本。
8. Qwen系列模型的性能变化
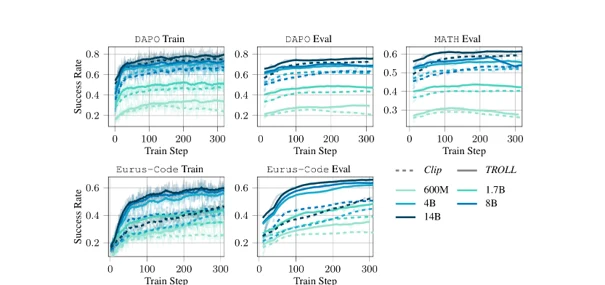
图3(论文图3):比较Qwen3-600M至Qwen3-14B,实线为TROLL,虚线为Clip。整体而言,TROLL在DAPO训练与评测、MATH评测及Eurus-Code训练与评测中,上升更快且达到更高水平。来源:Becker等,ICLR 2026,原文第7页。
8.1 数学任务:成功率提高约3至10个百分点
在基于DAPO-Math的实验中,TROLL相较Clip通常提高约3至10个百分点,相对改善约为5%至15%。从较小模型至14B模型,均观察到同方向改善,而且差异不仅体现在训练集上,也延续至DAPO与MATH评测。
8.2 代码任务:改善幅度更大
Eurus-Code实验报告成功率提高约7至18个百分点,相对改善约为18%至30%。使用TROLL的Qwen3-1.7B超过了使用Clip的Qwen3-4B,表明在该实验中,改善更新稳定性带来的收益可能大于单纯增加模型规模。
8.3 较小的TROLL模型接近较大的Clip模型
部分实验中,使用TROLL的Qwen3-4B接近使用Clip的Qwen3-14B。这并不意味着模型规模不再重要,而是说明后训练中的策略更新方法也会显著影响性能。
9. 更换优势估计方法后,效果是否仍然存在?
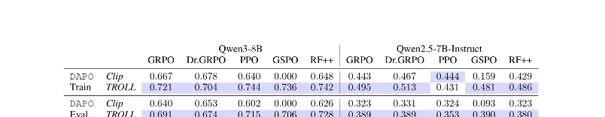
表1(论文表1):比较Qwen3-8B与Qwen2.5-7B-Instruct中,GRPO、Dr.GRPO、PPO、GSPO和REINFORCE++分别采用Clip及TROLL时的结果。来源:Becker等,ICLR 2026,原文第8页。
表中GSPO的差异尤其明显:Qwen3-8B结合GSPO与Clip时,成功率降至接近零;采用TROLL后,DAPO评测结果达到0.706。Qwen2.5-7B-Instruct也出现了GSPO结合Clip表现较低、TROLL使训练更稳定的情况。
其他算法中,TROLL也通常提高成功率。在论文的测试范围内,将Clip替换为TROLL,往往比更换优势估计方法带来更大收益。这说明它可作为策略更新层面的通用稳定机制,而非仅辅助某一种优势计算方式。
具体看Qwen3-8B的DAPO评测:GRPO从Clip的0.640提高至TROLL的0.691,增加0.051;PPO从0.602提高至0.715,增加0.113;GSPO从0.000提高至0.706;REINFORCE++从0.626提高至0.728,增加0.102。
如何理解这些结果
TROLL的作用并非提出更好的优势估计器,而是以更明确的约束处理策略更新,使既有优势估计方法能够更稳定地发挥作用。
10. 更换模型家族后,效果是否仍然存在?
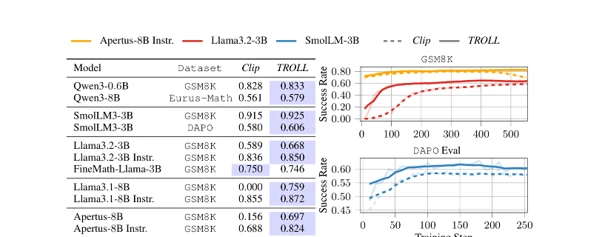
图4(论文图4):比较Llama、SmolLM3及Apertus系列在GSM8K与DAPO等任务中的表现。来源:Becker等,ICLR 2026,原文第9页。
改善并不限于Qwen系列。Llama3.1-8B在GSM8K上的结果从Clip的0.000提高至TROLL的0.759;Apertus-8B从0.156提高至0.697;Apertus-8B-Instruct从0.688提高至0.824。对原本在Clip下几乎无法有效学习的模型,差异尤为明显。
部分Llama模型在采用Clip时,需要较长时间才出现性能改善,而TROLL更早产生有效学习信号。这说明论文强调的训练速度与更新稳定性改善也出现在其他模型家族中。
但并非所有组合都更好。FineMath-Llama-3B在GSM8K上的结果为Clip 0.750、TROLL 0.746,表现基本相当或略有下降。TROLL并不保证在任何条件下提升性能,其价值在裁剪导致训练不稳定的场景中更为突出。
评价论文时,也应关注改善较小的情况及例外。该研究的说服力不在于每一项结果都领先,而在于多个模型与算法反复表现出训练稳定性的改善。
11. 超参数、熵与计算成本分析
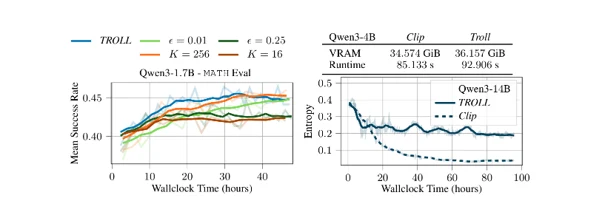
图5(论文图5):左侧展示KL边界及稀疏词元数量对应的性能;右上展示内存与运行时间;右下展示训练过程中的熵变化。来源:Becker等,ICLR 2026,原文第10页。
11.1 KL边界ε
ε过小会使更新过于保守、训练变慢;ε过大则可能使策略单次变化过大,影响最终表现。论文指出,在适度保守的取值范围内,收敛性能相对稳定。
11.2 稀疏化的词元数量上限K
K=16不足以充分近似完整分布,因而表现较差;K=256增加计算成本,却未比默认值K=64带来明显收益。需要在保留足够关键词元与控制额外开销之间取得平衡。
11.3 熵的保持
随着训练推进,Clip的词元分布熵呈现迅速下降的趋势。这可理解为模型将概率集中于少量已知模式。TROLL在提高成功率的同时保持更高的熵。代码生成实验也观察到熵的保持与性能提升之间存在关联。
11.4 受控环境下的额外开销
在受控环境中,VRAM占用从Clip的34.574 GiB增加至TROLL的36.157 GiB,约增加4.6%;运行时间从85.133秒增加至92.906秒,约增加9.1%。
训练阶段并非没有额外开销。论文通过稀疏分布限制开销增长,并说明其主要取决于词表大小,而非模型参数数量,因此模型越大,这部分开销占总训练成本的比例越小。推理阶段不使用TROLL投影,因而不会增加相应开销。
12. 如何理解实验结果的边界
12.1 TROLL并不改变推理结构
TROLL改变的是后训练阶段的策略更新方式,不改变模型架构,也不在推理时增加新模块。因此,训练完成后的推理方式与延迟可保持不变。
12.2 不能替代奖励设计
如果奖励函数设计不当或验证器不可靠,模型仍可能稳定地优化错误目标。TROLL限制的是策略变化幅度,并不修正定义“好回答”的奖励机制本身。
12.3 实验集中于数学和代码RLVR任务
论文虽涉及多个模型家族与算法,但主要任务仍是答案可验证的数学推理和代码生成。对于一般RLHF、长对话、工具调用智能体及视觉语言模型,是否存在同样效果,仍需进一步验证。
12.4 已验证的稠密模型规模最高为14B
作者测试了最高14B规模的稠密模型。更大模型及MoE架构的词表分布、并行方式、通信成本与稀疏化误差可能不同,作者也将其列为后续研究方向。
12.5 以概率分布可有效稀疏化为前提
TROLL依赖少量词元承载大部分概率质量这一特性。在经常出现高熵输出的特殊任务或多模态词元分布中,平均5至10个词元可能不足以近似完整分布,需要调整K、δ或采用其他稀疏化策略。
更准确的评价是:论文通过广泛实验表明,在裁剪不稳定或梯度损失较大的情况下,显式信赖域投影可能更有优势,而不是证明TROLL始终优于裁剪。
13. AI专利实务视角下的技术分析
以下仅根据论文公开内容进行初步技术分析。判断实际新颖性、创造性或权利范围,仍需另行开展现有技术检索并核查申请进程。
13.1 技术问题与解决手段的对应关系
针对PPO裁剪的启发式约束与梯度损失,TROLL对词元的类别分布执行KL信赖域投影,在明确限制更新幅度的同时保留梯度。针对完整词表投影的内存与计算负担,它结合概率质量阈值与Top-K构建稀疏分布。针对数值优化可能中断计算图的问题,则通过基于KKT条件的隐式微分,实现从策略损失到模型参数的端到端训练。
针对投影分布与实际模型输出的差异,TROLL以投影结果为目标加入回归项,引导未经投影的策略在后续更新中接近信赖域。其更新机制不限定优势计算方法,因此可与PPO、GRPO、Dr.GRPO及GSPO等方法结合。
13.2 技术差异可能更多体现于组合关系
信赖域与KL约束在TRPO系列中已有研究;投影式强化学习、类别分布、Top-K词元稀疏化及OptNet式可微优化也各有先行研究。因此,值得关注的是这些要素如何在大语言模型的词元级策略更新中具体结合。
例如,保存、排序并重新归一化新旧策略的稀疏词元概率,仅对越界位置求解一维对偶问题,再将投影分布用于策略概率比与回归目标。这一实现流程区别于简单增加KL惩罚项。
13.3 支持技术效果的实验数据很重要
在这一领域,防止训练性能退化、保持熵、实际运行时间、内存增长及跨算法可复现性,与数学构造同样重要。与其仅在专利说明书或技术文件中呈现准确率提升,不如同时说明Clip失效条件下的稳定性、稀疏化误差、投影发生率,以及边界值变化时的收敛特性,这样更有说服力。
14. 结语:TROLL对后训练方法的启示
改善大语言模型的强化学习,不仅需要关注奖励模型、数据与优势估计,也需要重新审视实际驱动策略变化的更新规则。PPO裁剪便于实现且经过广泛应用,但对信赖域原则的近似仍可能带来不稳定性与梯度损失。
TROLL通过对每个词元的类别概率分布进行可微KL投影解决该问题,并以稀疏化降低大词表带来的成本。其优势在于,在数学推理和代码生成任务中,跨多个模型和算法展示了更快的训练、更高的最终成功率、训练性能退化的缓解,以及熵的保持。
专利分析应关注完整处理流程:词元分布的存储与压缩、越界判断、基于对偶问题的投影、隐式微分,以及策略概率比与回归项的组合,而非仅着眼于“信赖域”或“稀疏化”等概念。由于相关要素已有较多研究,能否获得保护仍取决于具体组合关系及技术效果证据。
这些原则在更大模型、MoE、一般偏好学习、工具调用智能体与多模态模型中是否同样有效,仍是后续验证重点。论文的意义在于重新审视裁剪这一默认选择,并提供了在现代大语言模型规模下实现信赖域方法的可行路径。
总结:TROLL以最小必要投影使概率分布满足KL信赖域约束,并结合稀疏logit与可微求解器控制实现成本。在多项数学与代码实验中,它表现出比Clip更稳定、更快的训练。
来源和使用信息
原文:https://arxiv.org/pdf/2510.03817
论文引文:Philipp Becker、Niklas Freymuth、Serge Thilges、Fabian Otto、Gerhard Neumann,TROLL: Trust Regions Improve Reinforcement Learning for Large Language Models,ICLR 2026。
本文件是一份技术评注,以易于理解的方式整理所附文件。 对于具体的法律判决或专利权的确定,它不是法律意见,实际审查需要对有关申请文件和先前条款进行单独调查。
本文基于发表时的情况撰写。如需就具体事项咨询,请联系IPLEX。