
Autor: Yongduck Kim, agente de patentes de IPLEX IP Law Firm
El aprendizaje por refuerzo basado en recompensas se utiliza cada vez más para mejorar el razonamiento de los grandes modelos de lenguaje. Una técnica habitual es la optimización de políticas de tipo PPO. Métodos como GRPO, Dr.GRPO, GSPO y REINFORCE++, que modifican la estimación de ventajas o la normalización, suelen recurrir al recorte de PPO para limitar los cambios de la política en cada actualización.
El artículo sobre TROLL aborda directamente esta limitación. En lugar de introducir una nueva función de recompensa o rediseñar el estimador de ventajas, propone sustituir el recorte por una proyección sobre una región de confianza KL para cada token. El cambio consiste en pasar de recortar las actualizaciones que superan un intervalo a encontrar la distribución de probabilidad más cercana que respete la restricción.
Idea central del artículo: TROLL busca mejorar la estabilidad, la velocidad de entrenamiento y la tasa de éxito final del aprendizaje por refuerzo de los LLM. Para ello, sustituye el recorte de PPO por una proyección diferenciable sobre regiones de confianza por token y utiliza una representación dispersa de las probabilidades más relevantes.
Datos del artículo científico
El artículo «TROLL: Trust Regions Improve Reinforcement Learning for Large Language Models» se publicó en ICLR 2026. Sus autores son Philipp Becker, Niklas Freymuth, Serge Thilges, Fabian Otto y Gerhard Neumann, vinculados al Karlsruhe Institute of Technology y Microsoft Research. El trabajo sustituye el recorte de PPO por proyecciones diferenciables sobre regiones de confianza para distribuciones discretas y evalúa su aplicación al razonamiento matemático y la generación de código, con distintas familias de modelos y métodos de estimación de ventajas.
1. La pregunta del artículo: ¿por qué reconsiderar el recorte de PPO?
En el posentrenamiento de los LLM mediante aprendizaje por refuerzo, se evalúan las respuestas del modelo y se asignan recompensas. La política se actualiza para favorecer las respuestas mejor valoradas. Si la actualización es excesiva, la distribución de salida puede colapsar de forma repentina. Incluso pequeños cambios en los datos de entrenamiento pueden provocar respuestas mucho más largas, repetición de patrones o una rápida pérdida de diversidad en la exploración.
Para limitar los cambios bruscos, PPO recorta el cociente entre las probabilidades de la política nueva y la anterior cuando supera un intervalo determinado. Su sencillez facilita su uso a gran escala, pero los autores señalan que solo aproxima de manera heurística el concepto de región de confianza. Cuando se anula el gradiente de los tokens cuyo cociente excede el umbral, puede perderse información útil para devolver una política desviada a una región admisible.
La diferencia puede ilustrarse con un automóvil. El recorte se asemeja a un dispositivo que interrumpe la aceleración al superar un límite de velocidad: restringe el avance, pero no indica cómo regresar de forma gradual a una situación segura. La proyección, en cambio, calcula el punto admisible más cercano al estado actual y lleva el sistema hasta él. Así, sitúa explícitamente el estado dentro de la región permitida.
El recorte de PPO limita el cociente de políticas del token muestreado; fuera del intervalo, puede anular la contribución correspondiente a la función objetivo y su gradiente. Aproxima la región de confianza de forma heurística, sin proyectar por separado la distribución. TROLL, en cambio, considera la distribución de probabilidades de cada posición y, si se supera el límite KL, calcula la distribución admisible más cercana a la actual. Formula así una optimización convexa con restricciones KL explícitas y utiliza distribuciones dispersas para limitar el coste de trabajar con vocabularios grandes. Ninguno de los dos métodos añade coste en la fase de inferencia.
Una distinción importante: TROLL no sustituye el cálculo de ventajas de PPO, GRPO, Dr.GRPO o GSPO. Sustituye el mecanismo de recorte que se utiliza para actualizar la política a partir de esas ventajas.
2. Conceptos básicos: política, ventaja y región de confianza KL
2.1 La política determina la distribución de probabilidad del siguiente token
En un modelo de lenguaje, la política asigna una probabilidad a cada posible siguiente token según el contexto. Por ejemplo, en un mismo contexto, «correcto», «por tanto» y «pero» pueden recibir probabilidades diferentes. El aprendizaje por refuerzo ajusta los parámetros del modelo para favorecer los tokens de las respuestas mejor valoradas y reducir la probabilidad de los que aparecen en respuestas deficientes.
2.2 La ventaja indica cuánto mejora una elección respecto a la referencia
La ventaja expresa en qué medida una respuesta o la elección de un token supera el comportamiento de referencia. PPO puede utilizar un modelo de valor independiente; GRPO genera varias respuestas a una misma pregunta y calcula ventajas a partir de sus recompensas relativas. Como TROLL no impone una forma concreta de calcularlas, puede combinarse con distintos algoritmos.
2.3 La divergencia KL mide la diferencia entre dos distribuciones de probabilidad
La divergencia KL mide cuánto se aparta la distribución de tokens de la nueva política de la distribución anterior. TROLL limita esa divergencia en cada posición de salida para que no supere un umbral ε. La restricción considera la distribución de tokens en esa posición, y no únicamente el cociente de probabilidades del token muestreado.
2.4 La región de confianza limita el cambio permitido en cada actualización
La región de confianza establece hasta dónde puede cambiar la política en una actualización. Un límite demasiado pequeño ralentiza el aprendizaje; uno demasiado amplio puede permitir cambios inestables. El artículo observa que un valor ε excesivamente conservador reduce la velocidad y que un valor demasiado grande tiende a perjudicar la tasa de éxito final.
La idea, sin fórmulas: TROLL no pretende que la nueva política sea idéntica a la anterior. Permite avanzar en la dirección indicada por la recompensa y solo ajusta la distribución cuando se supera el radio KL permitido, buscando la alternativa admisible más cercana.
3. La idea central de TROLL: proyectar en lugar de recortar
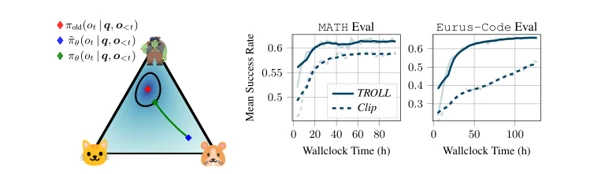
Figura 1 del artículo. A la izquierda se muestra la relación entre la política anterior, la nueva y la proyectada en una distribución de tres tokens. A la derecha se compara la velocidad de entrenamiento de TROLL y Clip en matemáticas y código. Fuente: Becker et al., ICLR 2026, página 2 del original.
Cómo interpretar la parte izquierda de la figura
Cada vértice del triángulo representa una distribución que concentra toda la probabilidad en uno de tres tokens: gato, troll o hámster. El punto rojo corresponde a la política utilizada para recopilar los datos y el azul a la política obtenida tras actualizar los parámetros. Si la nueva política se desplaza demasiado hacia hámster y sale de la región de confianza, TROLL la proyecta al punto verde admisible más cercano.
Esto no implica volver necesariamente a la política anterior. Si la nueva distribución está dentro de la región de confianza, se conserva; si queda fuera, se modifica lo mínimo necesario. Así se limita el tamaño de la actualización sin perder la dirección del aprendizaje guiado por recompensas.
Qué muestra la parte derecha de la figura
En el experimento con Qwen3-14B y GRPO, TROLL, representado con línea continua, alcanza antes tasas de éxito elevadas que Clip, representado con línea discontinua. La diferencia es especialmente visible en generación de código al comparar el mismo tiempo real de ejecución. El resultado respalda una mejora tanto de la puntuación final como de la eficiencia temporal del entrenamiento.
Punto clave: mientras que el recorte puede debilitar o anular el gradiente de las actualizaciones fuera del intervalo, TROLL mantiene el flujo de gradientes a través de la proyección. La hipótesis central es que esto mejora la estabilidad y la eficiencia del entrenamiento.
4. Flujo de procesamiento de TROLL
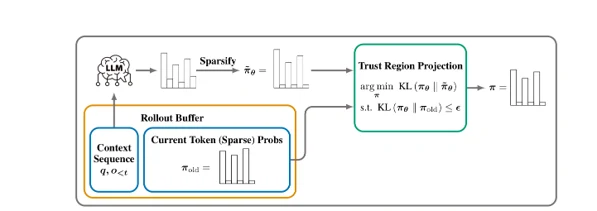
Figura 2 del artículo. Tras obtener representaciones dispersas de la distribución del LLM actual y de la política anterior almacenada en el búfer de trayectorias, se calcula la distribución utilizada para entrenar mediante una proyección sobre la región de confianza KL. Fuente: Becker et al., ICLR 2026, página 4 del original.
Paso 1. Guardar la política anterior. Se almacenan en el búfer de trayectorias las probabilidades de los tokens de la política que generó la respuesta. Servirán de referencia para medir el cambio de la nueva política.
Paso 2. Recalcular la distribución actual. Con los mismos datos de respuesta, se calculan las probabilidades de los tokens bajo el modelo que se está actualizando.
Paso 3. Obtener representaciones dispersas de ambas distribuciones. En lugar de almacenar todo el vocabulario, se conservan los tokens que concentran la mayor parte de la masa de probabilidad.
Paso 4. Comprobar el límite KL. Se verifica si la distribución actual se aparta de la anterior más de ε. Si respeta el límite, no se realiza ninguna proyección.
Paso 5. Proyectar únicamente las distribuciones que superan el límite. Se calcula la distribución más cercana a la actual que, al mismo tiempo, permanece dentro de la región de confianza de la política anterior.
Paso 6. Actualizar la política con la distribución proyectada. Esta distribución se utiliza para calcular el cociente de políticas. También se añade un término de regresión para acercar la salida original del modelo al resultado de la proyección.
¿Por qué se necesita un término de regresión? Utilizar solo la distribución proyectada para calcular el cociente de políticas puede dejar la salida original del LLM fuera de la región de confianza. El artículo utiliza el resultado de la proyección como objetivo de regresión para acercar ambas distribuciones y favorecer la estabilidad de las siguientes actualizaciones.
5. Cómo entender la proyección sin recurrir a fórmulas
5.1 La distribución admisible más cercana a la política actual
TROLL busca una distribución que cumpla dos condiciones: mantenerse lo más cerca posible de la nueva distribución que produce el modelo y no superar el límite KL ε respecto a la política utilizada para recopilar los datos. El problema se formula como una optimización convexa cuya solución combina las probabilidades de ambas políticas mediante una interpolación geométrica, expresada en el dominio logarítmico.
5.2 La intensidad de la proyección se ajusta en cada posición de token
Si la distribución actual ya está dentro de la región admisible, la intensidad de la proyección es cero y no se modifica. Cuanto mayor es la desviación, más se aproxima a la política anterior. La intensidad se obtiene resolviendo un problema de optimización escalar, más eficiente que abordar directamente la optimización completa en alta dimensión.
5.3 Por qué es importante que la proyección sea diferenciable
En el aprendizaje por refuerzo, el gradiente de la pérdida final debe propagarse hasta los parámetros del modelo. Aunque TROLL incorpora optimización numérica en la proyección, utiliza las condiciones KKT y diferenciación implícita para calcular cómo varía la intensidad óptima de proyección con la salida del modelo. Esto permite integrar la proyección como una capa del grafo de cálculo del entrenamiento.
Como ejemplo hipotético, supongamos que la probabilidad de un token correcto pasa de 0.45 en la política anterior a 0.60 en la actual. TROLL conserva ese cambio si respeta el límite KL. Si la probabilidad de otros tokens relevantes baja de 0.35 a 0.15 de forma excesiva, la proyección compensa parcialmente la reducción. Los tokens restantes, cuya probabilidad pasa de 0.20 a 0.25, se normalizan conjuntamente para mantener una distribución válida.
Conviene evitar una confusión: TROLL no ajusta de forma independiente cada token a un límite superior o inferior. Busca una distribución categórica válida, cuyas probabilidades sumen 1, que cumpla la restricción KL.
6. Cómo trabajar con más de 150.000 tokens candidatos
En principio, sería necesario almacenar la distribución de todo el vocabulario para cada token de respuesta y realizar una proyección KL. El tokenizador Qwen3 del ejemplo contiene 151.936 candidatos. Con respuestas largas y lotes grandes, almacenar todos los logits resulta poco viable por su coste de memoria y cálculo.
6.1 Unos pocos tokens concentran la mayor parte de la probabilidad
La distribución del siguiente token suele estar muy concentrada: aunque existen numerosos candidatos, pocos reciben una probabilidad alta. El método selecciona hasta K tokens y se detiene cuando la probabilidad acumulada alcanza 1−δ. Con K=64 y δ=10⁻⁵, el artículo informa de que se conserva más del 99,999% de la masa de probabilidad con entre 5 y 10 tokens de media.
6.2 El token muestreado debe conservarse
Conservar solo los tokens más probables puede excluir un token que efectivamente se generó mediante muestreo. Sin embargo, el cociente de políticas y el gradiente dependen directamente del token generado. Por ello, TROLL lo incluye siempre en la representación dispersa, con independencia de su posición en la clasificación de probabilidades.
6.3 Los tokens excluidos no reciben una probabilidad exactamente nula
Asignar probabilidad cero a los tokens excluidos puede desestabilizar el cálculo de la divergencia KL. El artículo les asigna una pequeña probabilidad de base y vuelve a normalizar la distribución. Además, el proceso se realiza por bloques para evitar picos de memoria en secuencias largas.
La dispersificación combina cuatro mecanismos. El límite top-K acota el número de tokens conservados en situaciones de alta entropía; el valor predeterminado es K=64. La selección se detiene cuando se ha preservado suficiente masa de probabilidad acumulada, con δ=10⁻⁵. El token muestreado siempre se incluye porque es necesario para calcular el cociente de políticas y el gradiente. Los tokens excluidos reciben una pequeña probabilidad predeterminada pd > 0, en lugar de cero exacto.
Desde la perspectiva de las patentes, interesa la combinación concreta que permite proyectar regiones de confianza por token sobre una representación dispersa. El criterio de probabilidad acumulada, el límite top-K, la inclusión obligatoria del token muestreado y la renormalización deben analizarse junto con su orden de ejecución, y no como una mera reducción aislada de la distribución.
7. Diseño experimental
El artículo compara TROLL con Clip en un entorno de aprendizaje por refuerzo con recompensas verificables (RLVR) para razonamiento matemático y generación de código. Para comprobar que los resultados no dependen de un único modelo o estimador de ventajas, se evalúan varias familias de modelos, tamaños, conjuntos de datos y algoritmos.
En matemáticas se utilizan DAPO-Math; el grupo de evaluación MATH, compuesto por MATH500, AMC, AIME, OMNIMATH, OlympiadBench y Minerva; GSM8K; y Eurus-Math. En código se utiliza Eurus-2-RL-Code. Se evalúan Qwen3 0.6B, 1.7B, 4B, 8B y 14B, y Qwen2.5 0.5B, 1.5B, 3B y 7B, además de Llama 3.1 y 3.2, SmolLM3, Apertus y FineMath-Llama. Los métodos de optimización incluyen GRPO, PPO, Dr.GRPO, GSPO y REINFORCE++; también se examina la combinación con BAPO, que emplea recorte adaptativo, y con GPG, que prescinde del recorte.
El experimento no se limita a comprobar si TROLL mejora la puntuación. También examina la velocidad de aprendizaje, la reducción de colapsos durante el entrenamiento, la reproducibilidad entre modelos y algoritmos, y el coste computacional adicional.
8. Cambios de rendimiento en el modelo Qwen
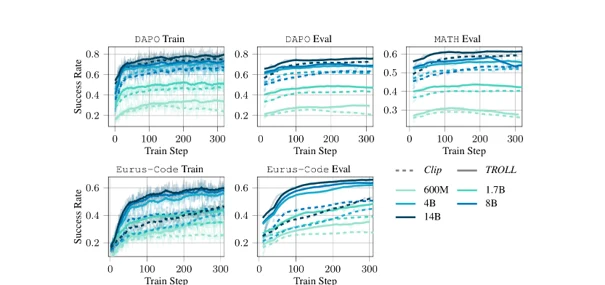
Figura 3 del artículo. Comparación desde Qwen3-600M hasta Qwen3-14B: línea continua para TROLL y discontinua para Clip. En conjunto, TROLL progresa antes y alcanza valores superiores en entrenamiento y evaluación con DAPO, evaluación con MATH y entrenamiento y evaluación con Eurus-Code. Fuente: Becker et al., ICLR 2026, página 7 del original.
8.1 El razonamiento matemático mejoró en 3 a 10 puntos porcentuales.
En los experimentos con DAPO-Math, el artículo informa de mejoras de entre 3 y 10 puntos porcentuales frente a Clip, equivalentes aproximadamente a un 5–15% en términos relativos. La tendencia se observa desde los modelos pequeños hasta el de 14B parámetros y se mantiene en las evaluaciones DAPO y MATH, además del conjunto de entrenamiento.
8.2 La brecha es aún mayor en la generación de código
En Eurus-Code se registran mejoras de entre 7 y 18 puntos porcentuales, aproximadamente un 18–30% en términos relativos. El artículo presenta un caso en el que Qwen3-1.7B con TROLL supera a Qwen3-4B con Clip. Esto ilustra que estabilizar las actualizaciones puede tener más impacto que aumentar el tamaño del modelo.
8.3 Un modelo menor con TROLL se aproxima a otro mayor con Clip
En los experimentos matemáticos, Qwen3-4B con TROLL se aproxima al rendimiento de Qwen3-14B con Clip. Este resultado no permite concluir que un modelo pequeño sustituya en general a uno mayor, pero muestra la importancia del algoritmo de posentrenamiento, junto con el número de parámetros.
9. ¿Se mantiene el efecto incluso si el método de estimación de la ventaja es diferente?
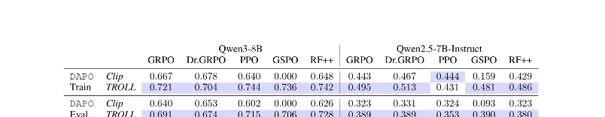
Tabla 1 del artículo. Comparación de Clip y TROLL con GRPO, Dr.GRPO, PPO, GSPO y REINFORCE++ en Qwen3-8B y Qwen2.5-7B-Instruct. Fuente: Becker et al., ICLR 2026, página 8 del original.
El caso más llamativo es GSPO. En Qwen3-8B, su combinación con Clip reduce la tasa de éxito prácticamente a cero, mientras que TROLL alcanza 0.706 en la evaluación DAPO. En Qwen2.5-7B-Instruct, GSPO con Clip también obtiene resultados bajos y TROLL estabiliza el entrenamiento.
En los demás algoritmos, TROLL mejora en general la tasa de éxito. Dentro del conjunto de pruebas, sustituir Clip por TROLL suele aportar más que cambiar el estimador de ventajas. Esto sitúa su contribución en la estabilización de las actualizaciones de la política, sin limitarla a un método concreto de estimación.
En la evaluación DAPO de Qwen3-8B, GRPO pasa de 0.640 con Clip a 0.691 con TROLL, una mejora de 0.051. PPO pasa de 0.602 a 0.715, con una mejora de 0.113. GSPO pasa de 0.000 a 0.706, mientras que REINFORCE++ pasa de 0.626 a 0.728, una mejora de 0.102.
Clave de interpretación
TROLL no es un nuevo estimador de ventajas, sino un mecanismo de restricción más fundamentado para trasladar esas estimaciones a la actualización de la política. Por ello, resulta relevante comprobar si sus efectos se reproducen con distintos estimadores.
10. ¿Se mantiene el efecto incluso si la serie de modelos cambia?
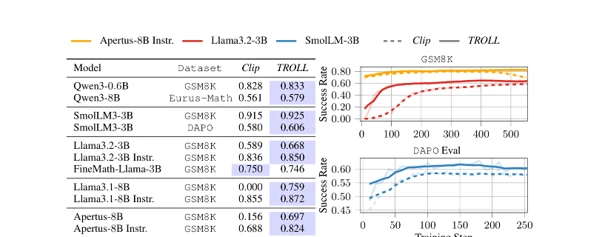
Figura 4 del artículo. Comparación del rendimiento final y de las curvas de aprendizaje de TROLL y Clip en modelos como Llama, SmolLM3 y Apertus, utilizando GSM8K y DAPO. Fuente: Becker et al., ICLR 2026, página 9 del original.
Las mejoras no se limitan a Qwen. Son especialmente visibles en modelos con escasa señal de aprendizaje bajo Clip. En GSM8K, Llama3.1-8B pasa de 0.000 con Clip a 0.759 con TROLL; Apertus-8B, de 0.156 a 0.697; y Apertus-8B-Instruct, de 0.688 a 0.824.
En algunos modelos Llama, las curvas con Clip tardan en mostrar mejoras, mientras que con TROLL la señal de aprendizaje aparece antes. Esto indica que la mayor velocidad y estabilidad descritas en el artículo también se observan al cambiar de familia de modelos.
No todas las combinaciones mejoran. En GSM8K, FineMath-Llama-3B obtiene resultados casi iguales o ligeramente inferiores: 0.750 con Clip y 0.746 con TROLL. La excepción impide presentar TROLL como una garantía universal de mejora; su valor resulta especialmente visible cuando el recorte tradicional genera inestabilidad.
Cómo valorar la evidencia: además de las mejoras, conviene examinar los resultados modestos y las excepciones. La aportación del artículo no consiste en superar a Clip en todas las pruebas, sino en observar mejoras de estabilidad de forma repetida en distintos modelos y algoritmos.
11. Hiperparámetros, entropía y coste computacional
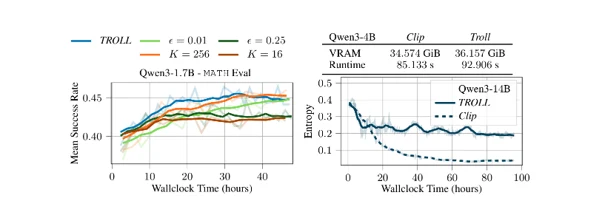
Figura 5 del artículo. A la izquierda se compara el rendimiento según el límite KL y el número de tokens conservados; arriba a la derecha, la memoria y el tiempo de ejecución; abajo a la derecha, la evolución de la entropía durante el entrenamiento. Fuente: Becker et al., ICLR 2026, página 10 del original.
11.1 El límite KL ε
Si ε es demasiado pequeño, las actualizaciones resultan excesivamente conservadoras y el entrenamiento se ralentiza. Si es demasiado grande, la política puede cambiar demasiado y perjudicar el resultado final. El artículo señala, no obstante, que la convergencia se mantiene relativamente estable dentro de un intervalo pequeño y conservador adecuado.
11.2 El límite K de tokens conservados
Con K=16, la representación aproxima de forma insuficiente la distribución completa y el rendimiento empeora. Con K=256 aumenta el coste computacional, sin una mejora significativa respecto al valor predeterminado K=64. Es necesario equilibrar la conservación de tokens relevantes con el coste de retener candidatos innecesarios.
11.3 Conservación de la entropía
Con Clip, la entropía de la distribución de tokens tiende a disminuir rápidamente durante el entrenamiento, lo que apunta a una concentración en patrones ya conocidos. TROLL mantiene una entropía mayor mientras aumenta la tasa de éxito. En generación de código también se observa una correlación entre conservación de la entropía y mejora del rendimiento.
11.4 Coste adicional medido en un entorno controlado
En el entorno controlado, el uso de VRAM pasa de 34.574 GiB con Clip a 36.157 GiB con TROLL, aproximadamente un 4,6% más. El tiempo de ejecución aumenta de 85.133 a 92.906 segundos, alrededor de un 9,1%.
El entrenamiento sí implica un coste adicional. El artículo explica que la representación dispersa limita ese incremento y que el coste depende principalmente del tamaño del vocabulario, no del número de parámetros. Por ello, su peso relativo en el coste total disminuye al aumentar el modelo. Durante la inferencia no se utiliza la proyección de TROLL y, por tanto, no se añade ese coste.
12. Límites que deben tenerse en cuenta al interpretar los resultados
12.1 TROLL no modifica la arquitectura de inferencia
TROLL modifica la actualización de la política durante el posentrenamiento. No cambia la arquitectura del modelo ni añade módulos a la inferencia. Por ello, el funcionamiento y la latencia de inferencia del modelo entrenado permanecen inalterados.
12.2 No resuelve los problemas de diseño de la recompensa
Si la función de recompensa está mal diseñada o el verificador es deficiente, el modelo puede optimizar de forma estable un objetivo incorrecto. TROLL limita los cambios bruscos de la política, pero no corrige la recompensa que define qué se considera una buena respuesta.
12.3 Los experimentos se centran en RLVR para matemáticas y código
Aunque se evalúan distintas familias de modelos y algoritmos, las tareas principales permiten verificar las respuestas: razonamiento matemático y generación de código. Se requiere más validación para trasladar las conclusiones al RLHF general, a conversaciones prolongadas, a agentes que utilizan herramientas y a modelos de visión y lenguaje en los que intervienen preferencias humanas complejas.
12.4 Modelos densos de hasta 14B parámetros
Los autores experimentan con modelos densos de hasta 14B parámetros. En modelos mayores o arquitecturas MoE pueden variar la distribución del vocabulario, el paralelismo, el coste de comunicación y el error de la representación dispersa. El artículo plantea estos aspectos como líneas de investigación futura.
12.5 La representación dispersa debe aproximar bien la distribución
La viabilidad de TROLL depende de que pocos tokens concentren gran parte de la probabilidad. En tareas especiales o distribuciones multimodales con salidas de alta entropía, conservar entre 5 y 10 tokens de media puede ser insuficiente. En esos casos, puede ser necesario ajustar K y δ o utilizar otra estrategia de representación dispersa.
Una lectura equilibrada: TROLL no demuestra que proyectar sea siempre mejor que recortar. Sus experimentos muestran que las regiones de confianza explícitas pueden ser ventajosas cuando el recorte produce inestabilidad o una pérdida importante de gradiente.
13. Análisis técnico desde la práctica de las patentes de IA
El análisis siguiente es preliminar y se basa únicamente en la información divulgada en el artículo. Valorar la novedad o el alcance de una posible protección requiere una búsqueda independiente del estado de la técnica y la revisión de las solicitudes relacionadas y de su tramitación.
13.1 Relación entre problemas técnicos y soluciones
Frente al carácter heurístico del recorte de PPO y la pérdida de gradiente, TROLL proyecta la distribución categórica de cada posición sobre una región KL, limitando explícitamente la actualización y manteniendo el flujo de gradientes. Para reducir el coste de memoria y cálculo de proyectar todo el vocabulario, combina un criterio de probabilidad acumulada con top-K en una representación dispersa. Para integrar la optimización numérica en el grafo de entrenamiento, utiliza diferenciación implícita basada en las condiciones KKT y una proyección diferenciable, de modo que el gradiente pueda propagarse desde la pérdida de la política hasta los parámetros.
Cuando existe una diferencia entre la distribución proyectada y la salida real del LLM, un término de regresión aproxima la política sin proyectar al objetivo obtenido mediante la proyección. Además, la estructura de actualización no exige un estimador de ventajas específico, lo que permite combinarla con PPO, GRPO, Dr.GRPO o GSPO.
13.2 La aportación puede residir en la combinación de los elementos
Las regiones de confianza y las restricciones KL tienen antecedentes en TRPO. También existen trabajos sobre aprendizaje por refuerzo basado en proyecciones, distribuciones categóricas, representaciones dispersas de tokens y optimización diferenciable, como OptNet. Por ello, la aportación del artículo debe examinarse en la combinación concreta de estos elementos para actualizar las políticas de los LLM por token.
Interesan especialmente el almacenamiento, la selección y la renormalización de las probabilidades de ambas políticas; la resolución de un problema dual unidimensional solo en las posiciones que superan el límite; y el uso de la distribución proyectada tanto para el cociente de políticas como para el objetivo de regresión. Esta secuencia de implementación va más allá de añadir una penalización KL.
13.3 La evidencia experimental debe respaldar el efecto técnico
La prevención del colapso, la conservación de la entropía, el tiempo real de ejecución, el consumo adicional de memoria y la reproducibilidad entre algoritmos son tan relevantes como la formulación matemática. En una memoria de patente o un documento técnico, conviene explicar la estabilidad en condiciones en las que Clip falla, el error de la representación dispersa, la frecuencia de proyección y la convergencia al variar los límites, además de las mejoras de precisión.
14. Conclusión: qué aporta TROLL al posentrenamiento
El artículo propone revisar no solo las recompensas, los datos y los estimadores de ventajas, sino también la regla que actualiza efectivamente la política. El recorte de PPO es una opción sencilla y ampliamente utilizada, pero su aproximación al principio de región de confianza puede introducir inestabilidad y pérdida de gradiente.
TROLL aborda el problema mediante una proyección KL diferenciable de la distribución categórica en cada posición de token y reduce el coste del vocabulario mediante una representación dispersa. Los experimentos de matemáticas y código muestran un aprendizaje más rápido, mayores tasas de éxito final, menos colapsos y una mejor conservación de la entropía en distintas combinaciones de modelos y algoritmos.
Desde la perspectiva de las patentes, conviene analizar la secuencia completa: almacenamiento y reducción de la distribución de tokens, comprobación de límites, proyección mediante el problema dual, diferenciación implícita y combinación del cociente de políticas con el término de regresión. La posible protección no depende de expresiones aisladas como «región de confianza», sino de relaciones concretas entre elementos y de evidencia de sus efectos, teniendo en cuenta los antecedentes existentes.
Queda por comprobar hasta qué punto los mismos principios se mantienen en modelos mayores, arquitecturas MoE, aprendizaje de preferencias, agentes que utilizan herramientas y modelos multimodales. La relevancia del artículo reside en cuestionar el uso del recorte como opción predeterminada y presentar una forma viable de aplicar regiones de confianza fundamentadas a la escala de los LLM actuales.
Síntesis: TROLL sustituye el recorte de actualizaciones por una proyección mínima sobre la región KL permitida. Una representación dispersa de logits y un solucionador diferenciable permiten aplicarlo a los LLM con un coste controlado. En los experimentos de matemáticas y código, el método muestra un aprendizaje más estable y rápido que Clip.
Fuente e información sobre el uso
Texto original: https://arxiv.org/pdf/2510.03817
Referencia: Philipp Becker, Niklas Freymuth, Serge Thilges, Fabian Otto y Gerhard Neumann, «TROLL: Trust Regions Improve Reinforcement Learning for Large Language Models», ICLR 2026.
Este texto ofrece una explicación técnica del artículo de referencia. No constituye una opinión jurídica sobre un caso concreto ni una evaluación de patentabilidad. Esta última requiere revisar por separado las solicitudes relacionadas y el estado de la técnica.
Este artículo del archivo refleja la situación en su fecha de publicación. Contacte con el despacho para analizar su caso.