
著者:IPLEX 知的財産権法律事務所 金容德, 弁理士
ChatGPTのような会話AIを使うと不思議な瞬間があります。 当初はかなり正確に続くモデルは、条件が1つずつ加えられるように間違った方向に行きます。 時々、あなたはあなたが正しいことについて再び間違いを犯し、あなたが最初で行った仮定に保たれているとき。 すべての会話レコードが残っているにもかかわらず、重要な用語を見逃したかのように行動します。
単純にこの現象を「文脈が長いので記憶できない」と説明するだけで、ポイントが見逃せません。 「LLMs Get Lost in Multi-Turn Conversation」は、Microsoft Research and Salesforce Researchの研究者によって公開され、同じタスクが一度に完全に指示され、指示が複数の会話のターンに分割されたときに比較されました。 変更した情報は情報量ではなく、情報開示の方法であった。
結果はかなり明確でした。 平均性能は、シングルターンで約90ポイントから約65ポイントのマルチターンまで低下します。 論文は39%の平均相対的な性能低下としてこれを要約します。 一方、適性は、よく解決されるとモデルの可能性を示し、平均16%、信頼性が減少し、同じ問題が繰り返されたとき、結果が不安定な状態であるかを示す、平均で112%増加した。 言い換えれば、「突然のモデルが腐敗した」と言っても、より正確で「モデルは、もはや同じ能力を確実に使うことができなくなった」と言えるでしょう。
1。 1。 問題は「記憶」ではなく、「不完全な要求を処理する方法」ではありません。
実際には、ユーザーは最初から完全に自分の要件を入力しません。 「レポートを書く」と言い始めて、次のメッセージに長さを述べ、投票を依頼し、最後にオーディエンスと目的を追加してください。 しかし、既存のLMM評価は、最初のプロンプトに含まれているすべての必要な条件でモデルを評価します。 実験を通してこのギャップを隔離した紙。
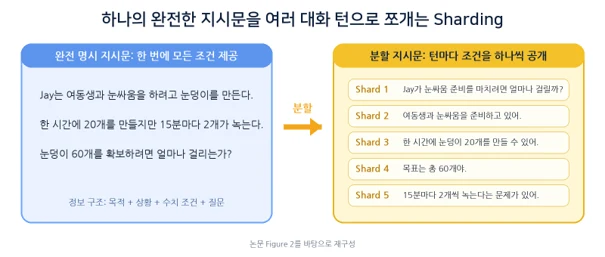
研究者が目指す最初の条件は完全指定です。 使用目的、制約、入力データ、出力フォーマットはすべて最初のメッセージに含まれているため、モデルはすぐに最終回答を生成できます。 逆に、未指定のマルチターンでは、最初のメッセージで主要な目的のみが与えられ、詳細な条件はその後のターンで順次明らかにされます。 今回、モデルはブランクを離れるか、まだ知られていない部分について質問をする必要がありますが、実際には、ブランクを推測し、あまりにも早く答えを完了しました。
重要な点は、マルチターン形式自体が必ずしも悪いことではないことです。 各ターンの結果が、翻訳などの独立してリンクできるタスクでは、パフォーマンスの低下は比較的小さい。 一方、問題は既存のコード、SQL、計算式、要約全体が新しい条件が導入されたたびに再編集されなければならないタスクで著しく現れました。 最後に、以前の対話全体が新しい条件に従って再統合されるべきかどうかが難しかった。
2。 研究者は、小さな作品に会話を破り、再び同じ問題を解く。
研究者は、完全な指示を原子情報に分割し、残りの部分で最初の部分と詳細な条件に高レベルの目的を置く。 ユーザシミュレータは、各ターンでまだ明らかにされていないほとんどの条件で配信され、実験の構造を知らずに定期的なユーザーと話しているかのように評価されるモデルです。 この方法は、シャード・コンバージネーションと呼ばれます。
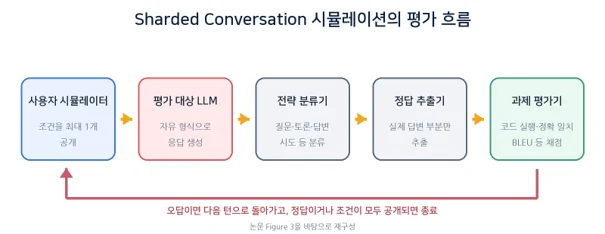
モデルの応答は、質問、保持、議論、拒絶、仮説候補、実際の回答試みに分類されました。 モデルが回答を試みたとき、コードの実行、SQLの実行、正確な一致、BLEU、および引用による要約スコアを含むタスクに適した評価器を使用して得られました。 回答が間違っていた場合、次の条件が明らかにされ、正しい回答が与えられた場合、またはそれ以上の条件が明らかにされていない場合は、会話が終了しました。
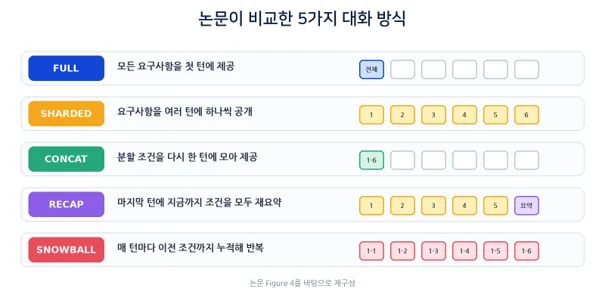
比較条件も慎重に設計されました。 FULLは、最初のターンで元の完全な指示を提供するためのベースライン条件です。 複数ターンで条件を開示 CONCAT は、SHADED に分けられた文章を 1 回にまとめて、単純な文再表現や情報損失によるかどうかをチェックします。 チャットの最後にすべての条件をリキャップし、SNOWBALLはこれまで各ターンを繰り返す。 これら5つの条件を比較することで、「情報共有の行為」と「複数のターンを連携させる失敗」を分離することができます。
3。 同じ現象は15モデルと20万人の会話で繰り返されました。
実験の規模は1つまたは2つのモデルに限定されません。 研究者は、コード生成、自然言語をSQL、APIコール生成、小学生の数学、文中の表を説明するタスク、複数の文書を引用しまとめるタスクなど、6種類のタスクを使用しました。 各タスクでは、90〜120分割の指示が作成され、合計600の指示が作成されました。
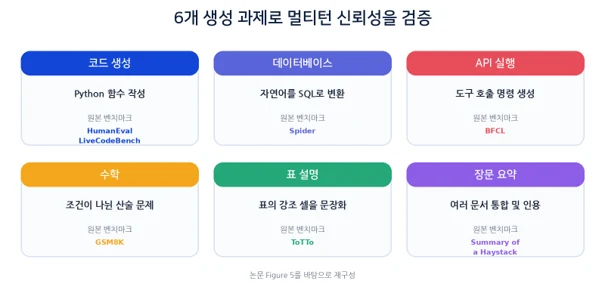
比較対象は、GPT-4.1、GPT-4o、O3、Gemini 2.5 Pro、Flash、Claude 3.7 Sonnet、DeepSeek-R1、Llamaシリーズ、Phi-4、OLMo 2、およびCommand-Aを含む15の代表モデルが含まれています。 モデル、ディレクティブ、会話条件の組み合わせを複数回繰り返すことで、会話の総数が20万を超えた。
同じ問題が繰り返される理由も重要である。 LLMは文章を確率的に生成するので、ただの成功や失敗で安定性を判断するのは困難です。 同じ問題を複数回実行することで、平均的なパフォーマンスだけでなく、うまく機能し、悪意に失敗したときにの間のギャップを見ることができます。 本紙の重要な点は、別々の信頼性の問題として「ギャップ」を提示することです。
4。 39%の低下よりも多くの注意を払う番号は「112%の増加」です。
論文は平均的な性能を見るだけでなく、適性および信頼性を別に見ていました。 適性は、繰り返された実行中のパフォーマンスのトップ10%レベルを参照します。 簡単に言えば、良い条件で問題が解決したときにモデルが達成できる距離を示します。 信頼性は、同じ指示で上位10%と下10%の性能の違いです。 この値が大きいほど、同じリクエストであっても、会話パスによって結果が大きく変化します。
すべてのモデルは、すべてのタスクでFULLよりも SHARDEDでパフォーマンスを低下させました。 平均的な性能はおよそ90から65に25ポイントを落としました、相対的な条件の39%の平均減少。 しかしながら、平均16%しか経度が低下しました。 一方、信頼は平均112%増加し、倍増しています。 単一の指示の中にも、ベストと最悪の実行間、平均的な差は50点程度でした。
CONCATの結果は、この解釈を強化します。 分割された条件が再び結合されたとき、フルの約95.1%で性能が維持されました。 言い換えれば、文章が小さい部分に壊れたときに情報が失われたり、表現が変更されたため、パフォーマンスが劣化したと言い難しくなります。 同じ情報が複数のターンにわたって受け取らなければならなかった状況では、会話状態そのものを統合するモデルのプロセスは問題でした。
そのため、この論文のメッセージは「最新のLMはマルチターンをすることはできません」ではありません。より正確な表現は「うまくいくことができますが、その能力を毎回確実に再現することはできません」です。製品観点から、同じ要件が異なる注文と会話パスで提示されると、結果がどのように変動するかを調べることが重要です。
5。 5。 チャットでモデルが失われたのはなぜですか?
回答を早めに完了
コードと数学のタスクでは、最初の回答が会話の最初の20%の中で発生したとき、平均スコアは30.9でした。 逆に、最後の20%まで待つと、平均スコアは64.4であった。 必要な条件がまだ十分に開示されていないにもかかわらず、モデルが最初に答えを作成する場合は、ユーザーが聞いたことがないという仮定が、回答が含まれている可能性が高い。
初期の前提で固定
LLMでは、未知の部分をそのまま残すのではなく、文脈から盗まれた値に充填することによって、答えを完了する傾向があります。 問題は、新しい条件が後ろから来るときです。 モデルは、回答全体を破棄し、再計算するのではなく、既に作成している構造の一部だけを変更します。 初期の欠陥のある前提は、会話のフレームワークとなり、その後の修正はそれの上に構築し続けます。
編集するほど、回答が大きくなります。
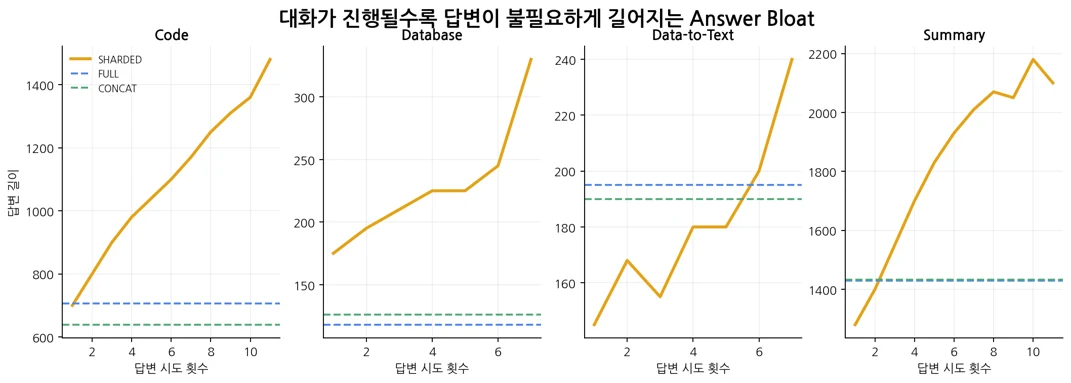
最終的な SHARDEDの回答は、FULLまたはCONCATの回答よりも20-300%長くなりました。 単独で正しい答えを見ると、コードの回答は平均値とSQLの回答が平均値で14%長くなりました。 研究者は、この回答ブロアットを呼び出します。 このモデルは、以前の回答を削除し、anew を計算するのではなく、例外や修正の説明を追加することによって応答するからです。
ミドルターンが弱くなり、最初と最後のターンがより強くなります。
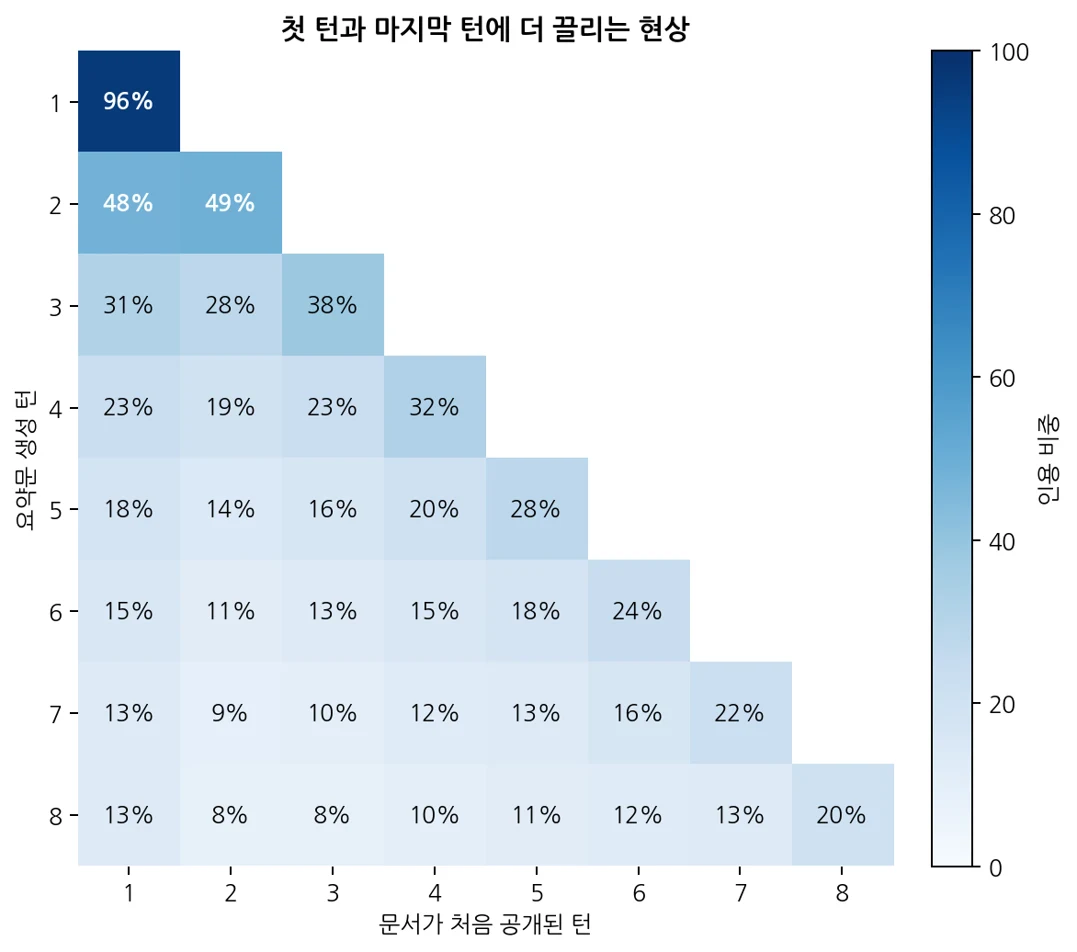
長い要約タスクでは、8つのターンの要約は、最後のターンに公表された文書の20%を引用しましたが、文書は2秒と3分の1はそれぞれ8%を引用しました。 これは、会話の始まりと終わりの情報が比較的強く反映される現象であり、中に入る条件は弱まっている。 研究者は、このロス・イン・ミドル・トゥーンズと名付けました。
長い、友好的な答えは実際に騒音になることができます。
6つのタスクの5つで、最も短い応答グループは、最も長い応答グループよりも10〜50パーセント優れたパフォーマンスを発揮しました。 説明が初期のターンで作成されると、ユーザが新しい入力の一部となる、ステータスが切れてしまう可能性が高まります。 複数のターン状況では、「まだわからないこと」を判断し、短い確認の質問を要求する能力は、最初で長い回答を注ぐ能力よりも重要であるかもしれません。
6。 。 より長い文脈とより劣りが十分ではなかった
最も簡単な治療法は、再び会話を繰り返すことです。 RECAP のような終端で全ての条件が再配置されている場合は、CharDED 上でのパフォーマンスが向上します。 ただし、実際のサービスでは、最終条件を記載した際は、分かりにくいサービスです。 SNOWBALLと同様に、以前の条件を繰り返すと、パフォーマンス劣化の約15〜20%を緩和しますが、迅速な対応が長くなり、フルレベルに回復しませんでした。
世代のランダム性を下げる方法も限られました。 温度を下げることで、単一ターンでの信頼性が大幅に低下しましたが、マルチターンでは改善が小さくなりました。 温度をゼロにしても、約30%の信頼性が残っています。 会話では、ひとつの小さな違いは、入力そのものを次の順番に変えるので、一世代のランダム性を抑えることで、累積的な誤差をなくすことは困難です。
より詳細な計算を使用するモデルは、自動的に解決できませんでした。 o3やDeepSeek-R1などの推論モデルは、非推論モデルと同様のマルチターン性能劣化を示しています。 研究者は、推論モデルが平均してより長い回答を生成する傾向があることを指摘しています。 答えが長くなり、モデルがそれ自体を想定し、ユーザーのニーズとモデルの見積りを次の順番で区別することがより困難になります。
7。 対話型AI製品は、「アンサワー世代」ではなく「状態管理」のために設計すべき
製品設計の観点からこれらの結果を読み込むと、方向はかなり明確になります。 まず、前提条件が満たされるまで、完全な回答を生成しない最終的な回答ゲートが必要です。 つまり、単純な「わからない場合は、プロンプトを尋ねる」ではなく、最終的な作成が現在の状態で許可されているかどうかを判断するために、制御ロジックが必要です。
第二に、同じ会話レコード内でユーザーの状態とモデルの仮定を混合しないことが重要です。 ユーザが確認した要件、未確認の項目、モデルによって推定される値、およびその後の撤退条件は、構造化された状態に別々に保存されなければなりません。 つまり、新しい条件が入って来るとき、あなたは何を保ち、何を捨てるかを決めることができます。
第三に、新しい情報が既存の仮定と競合するかどうかを確認する手順が必要であり、そうなら、関連する中間結果を無効にし、回答を草案する。 モデルを「Modify」に伝えれば、保存中に既存の構造に付加する「回答ブロアット」を作成できます。 必要に応じて、以前の回答を変更するのではなく、検証済みの条件のみを取ることによって、新しい推論ブランチを開始することがより信頼性が高いです。
4 つは、特定のポイントで会話全体をまとめるのではなく、「検証済みのユーザー条件のみ」を完全に明示的なディレクティブに再構成するのに便利です。 ターンの数、トークン数、条件の競合数、および再開のタイミングを決定するための修正回数などの信号を使用して、製品レベルの設計ポイントです。
最後に、正しい回答の平均的なパーセンテージで評価が終わるべきではありません。 同じ要件は、パフォーマンスの分散、仮定の離脱率、誤った回答後の回復率、および最も悪いギャップを測定するための異なる情報開示シーケンスで繰り返し実行されるべきです。 この用紙のアドレスが「一度はうまくいくの?」という疑問ではなく、「複数の方法で確実にそれをやりたい」という問題は、最終的には問題ではありませんか?
8月8日 特許慣行では、キーは「対話制御構造」です
新しいベースモデルアーキテクチャを提案するよりも、この論文は、会話AIの脆弱性を再現し、定量化する評価フレームワークと信頼性指標を提示する研究に近づいています。 そのため、製品やサービスレベルでの技術差別を調べる際、特定の状態管理構造と「LLM」の抽象的な目標よりも、その目標を実装する制御手順が重要になります。
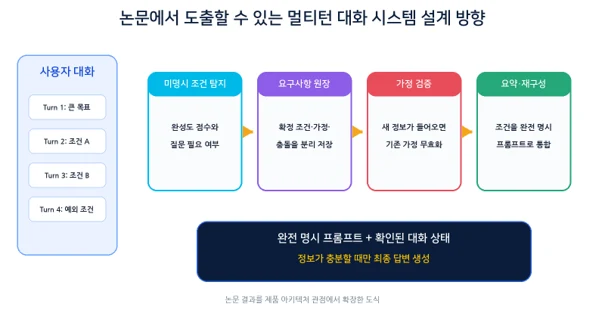
たとえば、最終的な回答が現在の入力だけで作成できるかどうかを判断する未指定条件検出、確認された条件を格納する要件のレジャー、未確認条件、モデルの仮定、および離脱条件を別々に、新しいステートメントと既存の仮定と選択的に中間出力を破棄し、特定の条件下で会話状態を完全に整理する要約トリガー、新しい条件を継承し、再確認されたシステムと異なる評価を繰り返すことによって、新しい条件が始まる会話の分岐が始まります。 技術的な設定として指定できます。
しかし、差分は「以前の会話を監視する」などの抽象的なアイデアで簡単ではなく、「必要に応じて質問をask」、そして「会話を記憶する」などです。 最終的なモデルコールがブロックまたは許可されると、どのような情報がデータ構造に格納されているかを指定することで、技術的な特徴と効果を簡単に説明しやすくなります。 エラー率、回復率、トークン使用量、および結果が異なる場合、どのユニットが、想定されるかが接続され、無効化されるか、最終的なモデルがブロックされるか、および許可されると、エラー速度、および回復率、トークン使用率、および結果が変化します。
また、この論文は2025年5月9日(水)に公表されました。 後で、関連技術の新規性/進歩性を見直した場合、単純なシャードシミュレーション、FULL・CONCAT・SHARDED比較、RECAP・SNOWBALL反復、高度および信頼性の定義に基づいて差別を主張することは困難であるかもしれません。 実際のライセンスでは、製品固有の状態管理構造、衝突検証手順、モデルルーティング、リソース保存、安全管理などの追加構成が重要になります。
9 月 9 日 また、会話スタイルを若干変更することで、障害の確率を低下させることもできます。
普通のユーザーにも適用できるレッスンもあります。 これは、すべての条件が最初の要求で完全に書かれなければならないという意味ではありません。 むしろ、条件が定義されていない場合は、「不十分な情報がある場合、最初に確認質問をしてください」と指定するのが良いでしょう。 条件を追加すると、既存の条件のどの状態を保ち、変更または削除するかを明確にする良い考えです。
会話が長い場合は、途中で一度尋ねることができます。「これまでのところ確認した条件だけを再配置し、あなたが推定したものを別々に示すようにしてください。」モデルが既に誤った構造で固定されていると思われる場合は、確認された条件だけを一度に新しい対話に投入し、それを継続的に変更するのではなく、起動するようにより安定しているかもしれません。 重要なタスクの場合、現実的な検証方法は、新しいダイアログで同じ完全に明示的なプロンプトを実行し、結果を比較することです。
結論。 良い会話AIは、「最初からそれを得るモデル」ではなく、「間違ったパスから戻るシステム」に近いです。
この論文では、ハイ・シングルターンのベンチマークを持つモデルは、必ずしも実際のインタラクティブなサービスで同じ品質を確実に提供していないことを示しています。 複数のターンで要件が解放されると、モデルはあまりにも早い回答を作成することで偽装することができます、事実としてその前提を保持し、途中で条件を弱く反映し、既存の回答に引き続き追加することができます。
そのため、次の世代の会話AIの競争力は、より多くの知識や長い回答によってのみ決定される可能性が高い。 情報が不十分であるとき待つ能力、ユーザーのニーズとモデルの推定と区別する能力、新しい条件が入ってくるときに既存の判断を撤回する能力、間違ったパスをダウンするときに検証された状態だけから始める能力は、製品の信頼性のコアです。
この記事は公表時点の情報に基づいています。個別の事情については、当事務所にご相談ください。