
作者:IPLEX知识产权法律事务所 金容德专利代理师
使用像ChatGPT这样的对话AI时,有些奇怪的时刻. 该模式最初相当准确地遵循,但随着条件逐一增加而走向错误的方向。 有时你再次犯错 你刚刚纠正, 有时你坚持 你所做的假设 在开始。 尽管所有的对话记录都保留下来,但它们的行为仿佛错过了一些重要的术语.
仅仅将这种现象解释为“我记不清了,因为背景很长”就忽略了这一点。 “LLMs Get Lost in Multiple-Turn Conversation”,由微软研究和销售力量研究研究所的研究人员出版,比较了同一任务一时被完全指示,指令被分为几个对话回合的情况。 改变的不是信息的数量,而是披露信息的方式。
结果相当清楚。 平均表现从单回合约90分下降到多回合约65分. 论文总结称,平均相对业绩下降39%。 另一方面,表明模型在妥善解决时潜力的能力,平均只减少了16%,可靠性则表明,当同一问题再次出现时,结果是多么不稳定,平均增加了112%。 换句话说,与其说“模型突然变得愚蠢”,不如说“模型不再能够可靠地使用同样的能力”。
1. 问题不是`记忆 ' 而是`如何处理不完整的请求 ' 。
在现实中,用户并不从一开始就完全输入自己的要求. 首先说,“写一份报告”,然后在下一个信息中说明长度,然后要求投票,并在结尾增加听众和目的。 然而,许多现有的LLM评价都对模型进行了评估,并包括了所有必要的条件。 这篇论文通过实验将这一差距隔离开来.
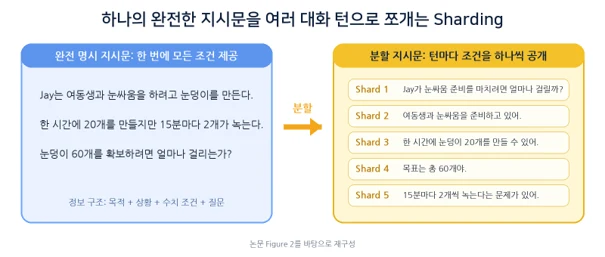
研究者区分的第一个条件是Fully-Specific化。由于使用的目的,限制,输入数据和输出格式都包含在第一个消息中,该模型可以立即产生最终答案。反之,在未明确的多轮弯中,在第一回电中只给出了主要目的,详细的条件在后续转弯中依次揭示。此时,模型应该留下空白,或者询问尚不为人知的部分,但实际上它常常猜到空白,完成答案太早。
重要的一点是,多回合格式本身并不总是坏事。 在每次转弯的结果可以独立连接的任务中,如翻译,性能下降相对较小. 另一方面,在每次引入新条件时,必须重新编辑全部现有代码,SQL,计算公式和摘要的任务中,出现了很大的问题. 归根结底,困难在于以前的所有对话是否应根据新的条件重新组合。
2. 研究者将对话破碎成小块,让他们再次解决同样的问题.
研究者将完整的指令分为原子片信息,然后将高级目的放在第一部中,并将详细的条件放在其余的作品中. 用户模拟器最多交付了一个在每一转弯时尚未披露的条件,被评价的模型在回应中仿佛在不知实验结构的情况下与一个普通用户交谈. 这种方法被称为"Sharded Conversation"(Shardd Conversation).
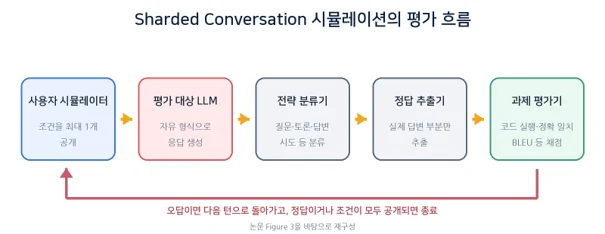
该模式的答复分为问题、搁置、辩论、拒绝、假设候选人和实际的回答尝试。 当模型尝试答案时,它使用适合任务的评价器打分,包括代码执行,SQL执行,精确匹配,BLEU,以及带有引文的汇总分数. 如果答案不正确,则揭示下一个条件,如果给出了正确的答案或者没有进一步的条件需要透露,则对话结束.
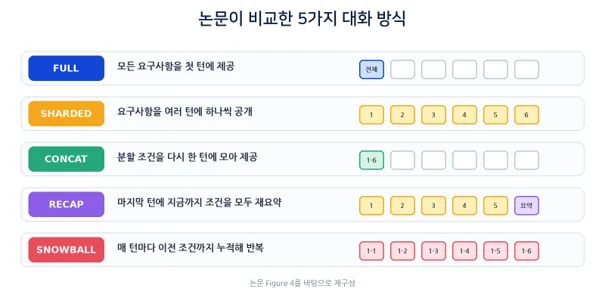
比较条件也经过精心设计。 FLL是第一个回合提供原始完整指令的基准条件. SHARDED在几个回合中披露了条件. CONCAT将SHARDED中划分的句子合并成一个转弯,并检查它是由于简单的句子重新表达还是信息丢失. RECAP在SHARDED对话结束后重新排列所有条件,SNOWBALL累计重复至今每个回合的条件. 通过比较这五个条件,我们可以在某种程度上将“分享信息的行为”和“未能在多个回合融合”分开。
3. 15个模型和20万个对话者重复了同样的现象。
实验范围不仅限于一两个模型. 研究人员使用了六种任务,包括代码生成,将自然语言转换成SQL的数据库任务,API呼叫生成,初级数学,解释句子中的表格的任务,以及引用和总结多个文档的任务. 每项任务都制定了90至120个分头指令,共计600个分头指令。
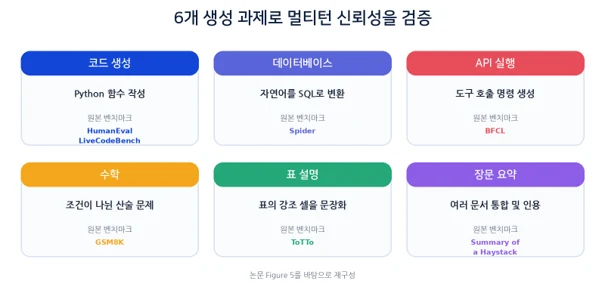
比较目标包括当时的15个代表性模型,包括GPT-4.1,GPT-4o,o3,双子座2.5 Pro和Flash,Claude 3.7 Sonnet,DeepSeek-R1,Llama系列,Phi-4,OLMo 2和Command-A. 通过多次重复模式,指令,和对话条件的组合,对话的总数超过20万.
同一问题再次出现的原因也很重要。 由于LLM产生句子概率很高,因此很难仅以一次成功或失败来判断稳定性. 通过多次运行同样的问题,你不仅可以看到一般的性能,还可以看到它运行良好和它失败严重之间的间隙. 本文件的要点是,它把“差距”作为一个单独的可靠性问题提出来。
4. 比起39%的下降,需要更多关注的数字是“112%的增长 ” 。
该文件不仅审视了平均业绩,而且还分别审视了能力和不可靠性。 端正度(英語:Aptitude)是指在重复执行时表现水平最高的10%. 简而言之,它显示了当模型在良好条件下解决问题时,它能完成多远. 可靠性是前10%和后10%在同一指令上的性能差异. 这种值越大,结果也会因对话路径的不同而变化越大,即使是针对同一请求.
所有模型在SHARDED中的性能都低于在所有任务中的FLL. 平均业绩从大约90点降至65点,相对而言平均下降39%。 然而,平均而言,能力下降只有16%。 另一方面,可信度平均增加了112%,翻了一番以上。 即使是在单一的指令中,执行最好和最差的平均差约50分.
国家消除酷刑委员会的结果加强了这种解释。 当分裂的条件再次合并时,性能维持在全能水平的95.1%左右. 换句话说,很难说表现恶化是因为信息丢失,或者当句子被破碎成较小的片段时表达方式被改变. 在必须经过若干个回合才能收到同样信息的情况下,将对话状态本身纳入模型的过程是一个问题。
因此,本文的信息不是“即使是最新的LLM也不能做多轮转 ” 。 更准确的表述是“你做得很好,但你无法每次都可靠地复制这种能力 ” 。 从产品角度看,重要的是要审视当相同的要求以不同的顺序和对话路径,而不是最高的基准得分时,结果会如何波动。
5. 模型为什么会在长对话中迷失方向?
早点回答
在代码和数学任务中,当第一次回答尝试在对话的前20%内发生时,平均得分为30.9. 相反,如果你等到最后20%,平均得分是64.4。 如果该模型先生成一个答案,即使必要的条件尚未完全披露,那么答案就更有可能包含用户没有听到的假设.
早期假设的安插
在LLM中,有一种倾向,就是通过从上下文中填入可信值来完成答案,而不是像现在这样留下未知的部分. 问题是,当新的条件从后面出现时。 模型常常只修改他们已经创建的部分结构,而不是丢弃和重新计算整个答案. 最初的缺陷前提随后成为对话的框架,随后的更正继续在其之上发展.
你编辑得越多,答案就越大。
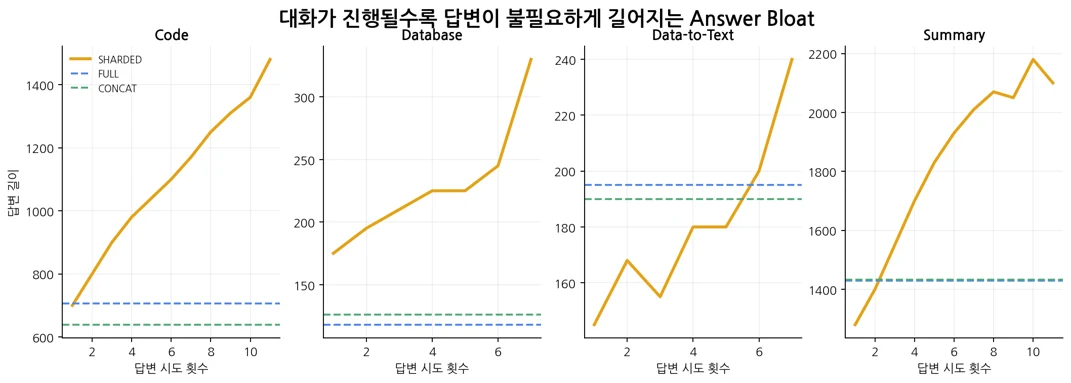
最后的SHARDED答案比FL或CONCAT答案长20-300%. 单看正确答案,代码答案平均长27%,SQL答案平均长14%. 研究者称这个为"回答"(Answer Bloat). 这是因为模型的反应是增加例外和校正解释,而不是删除先前的答案和重新计算.
中间转弯变弱,第一和最后转弯变强.
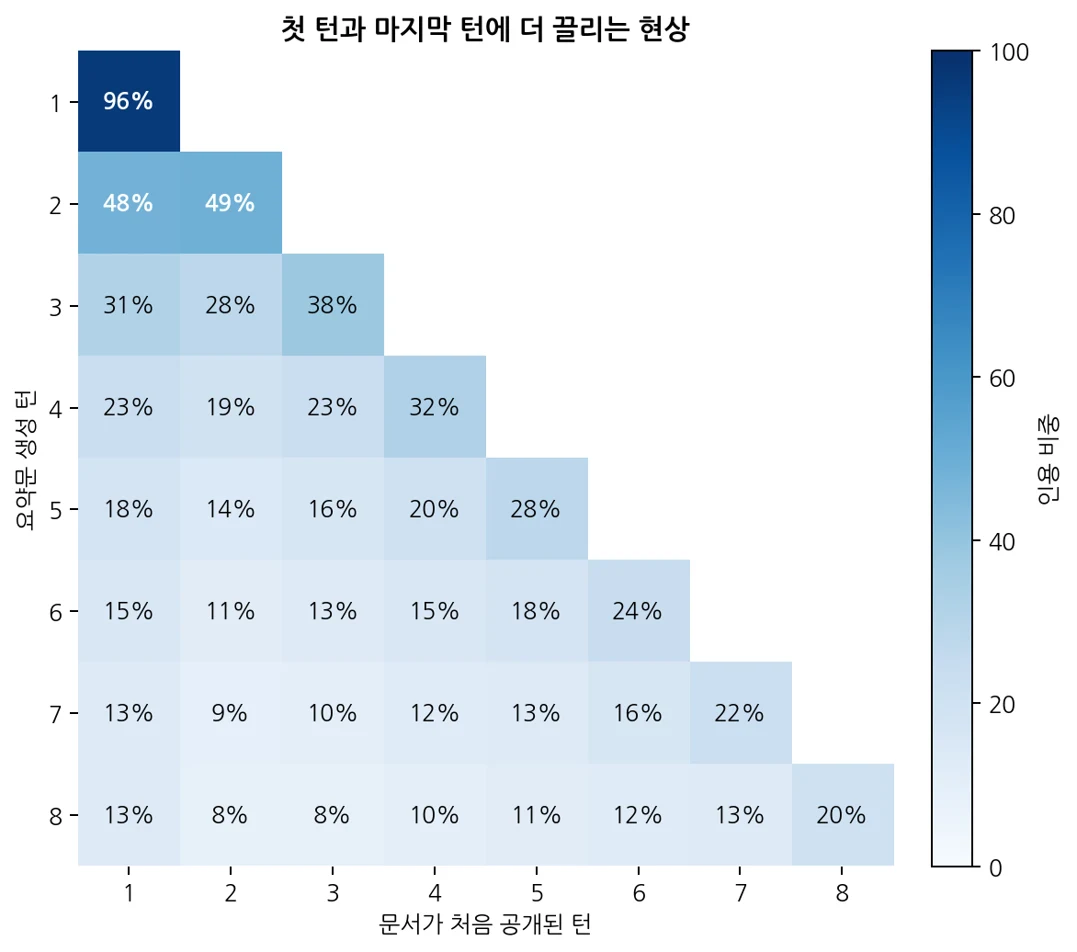
在漫长的总结任务中,第八回合的总结引用了上一轮公布的20%的文件,而第二和第三回合公布的文件只引用了8%的文件. 这种现象在对话的开始和结束的信息得到相对强烈的反映,中间进入的条件被削弱. 研究人员将这个Loss-in-Middle-Turns命名为"中转".
长期友好的答案实际上会变成噪音.
在6项任务中的5项中,最短的响应组比最长的响应组的成绩要好10%至50%. 描述在早期的转弯中创建的时间越长,用户可能留下更多假设和工作绕圈,这在后期转弯中成为新输入的一部分. 在多变的情况下,确定“我们尚不知道的”和提出简短的确认问题的能力可能比一开始就提供长长答案的能力更重要。
6. 更长的背景和更多的推理是不够的
最容易的补救办法是再次重复对话。 如果所有条件都像RECAP一样在结尾重新排列,则性能比SHARDED有所改进. 然而,在实际服务中,很难知道用户是什么时候提出最后一个条件的. 和SNOWBALL一样,重复之前的情况,每次转弯都缓解了约15-20%的性能退化,但即时迅速变长,没有恢复到全能水平.
降低发电随机性的方法也很有限。 降温显著降低了单轮式的可靠性,但多轮式的改进幅度很小。即使在零温度下,仍有大约30%的不可靠性。 在谈话中,一个小的差别在下一个回合中会改变输入本身,所以仅仅通过降低单生成的随机性就很难消除累积错误。
使用更多推算的模型也无法自动解析. o3和DeepSeek-R1等推理模型也表现出类似于非推理模型的多轮性能降解。研究者指出,推理模型往往平均产生较长的答案。答案越长,模型对自身作出的假设就越多,在下一个回合中区分用户需要和模型的估计可能越难。
7. 对话式AI产品应设计为 " 状态管理 " 而不是 " 回答一代 " 。
如果你从产品设计的角度来读这些结果,那么这个方向就变得相当清楚了. 首先,我们需要一个最终的答案门,在满足先决条件之前不能产生一个完整的答案。 这意味着,与其说简单的“如果不知道,请问 ” , 还需要快速控制逻辑来确定最终设定是否在当前状态下被允许。
第二,在同一对话记录中不要将用户条件和模型假设混为一谈,这一点很重要。 用户确认的要求,尚未确认的物品,模型临时估计的值,以及随后撤回的条件,必须分别储存在结构化状态下. 这样,当新的条件出现时,你可以决定保留什么和丢弃什么.
第三,需要有一种程序来核实新信息是否与现有假设相冲突,如果有,则使相关中间结果无效并起草答案。 仅仅告诉模型“修改”,就可以创建一个Answer Bloat,在保留现有结构的同时,增加现有结构。 如有必要,则更可靠的做法是,只采用经核实的条件,而不是修改先前的答案,从而开始一个新的推理分支.
第四,也许应该将“只有经核实的用户条件”重新组织成完全明确的指示,而不是概括某些时候的整个对话。 利用转弯次数,令牌次数,条件冲突次数,以及答题修改次数等信号,确定复赛或重启的时间,也是产品层面的设计点.
最后,评价不应仅以正确答复的平均百分比结束。 应在不同的信息披露序列中反复执行同样的要求,以衡量业绩差异、假设退出率、答错后的恢复率和最坏的差距。 本文所论述的可靠性问题最终不是一个“你能做一次好吗?” 的问题,而是“你能以多种方式可靠地做吗?”
8. 在专利实践中,关键是`对话控制结构 '
本文与其提出新的基本模型架构,不如更接近于提出评价框架和可靠性指标的研究,以复制和量化对话AI的脆弱性. 因此,在审查产品或服务层面的技术差异时,执行这一目标的具体状态管理结构和控制程序比“LLM处理多轮转”这一抽象目标更为重要。
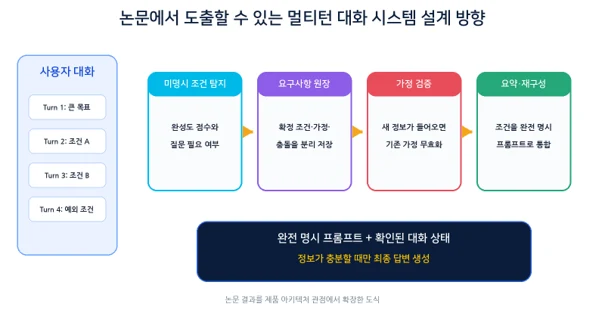
例如,未具体说明的状态检测,决定最终答案是否能够仅使用当前输入,要求分类账分别存储确认的条件,未经证实的条件,模型假设,以及退出条件,假设无效,检测新报表与现有假设之间的冲突,并有选择地丢弃中间输出,汇总触发,在特定条件下将谈话状态重组为完全明确的提示,对话分支通过仅继承经核实的条件开始新的推理,通过重复不同信息披露序列来衡量恢复率和波动性的可靠性评价系统等. 可以指定为技术配置.
然而,用抽象的想法来区分并不容易,例如“总结先前的对话”、“必要时的问询”和“回忆的对话 ” 。 通过具体说明存储在何种数据结构中的信息、使用何种信号来判断未指明状态、假设与何种单位有关并失效、最后的模型调用被阻断或允许时,以及错误率、恢复率、象征性使用率和延迟如何因结果而变化,就更容易解释技术特征和效果。
此外,本文于2025年5月9日发表. 后来,在审查相关技术的新颖/创新步骤时,可能难以根据简单的硬化模拟、FLL-CONCAT-SHARDED比较、RECAP-SNOWBALL重复以及能力和可靠性定义来主张区别。 在实际许可中,产品特定状态管理结构,碰撞核查程序,模型路由,资源节约,安全控制等额外配置变得重要.
9. 用户还可以通过略微改变其对话风格来降低失败概率.
也有可以适用于普通用户的经验教训。 这并不意味着所有条件都必须在第一次请求中完美地写出来。 相反,如果条件定义较少,最好规定“如果资料不足,首先提出确认问题”,以防止模型任意填写。 在增加条件时,一个好主意是明确说明哪些现有条件需要保留,哪些条件需要改变或删除。
如果对话时间长,你可以在中间问一次,“请只重新安排我迄今确认的条件,并单独说明你估计到的情况。” 如果模型似乎已经深深扎根于不正确的结构中,那么只需将确认的条件插入一次新的对话并重新开始就可能更加稳定,而不是继续修改。 对于重要的任务来说,一种现实的核查方法是在新的对话中再次运行同样的完全明确的提示,并对结果进行比较。
结论。 良好对话的人工智能更接近于“从错误路径返回的系统”而不是“从一开始就得到正确的模式”。
本文显示,单回合基准高的模型在实际互动服务中不一定能可靠地提供同样的质量. 当要求通过多个回合发布时,模型可能会因创建答案太早,将其假设作为事实,在中转时弱化地反映条件,并继续附在现有的答案上而动摇.
因此,下一代对话AI的竞争力可能不会完全由更多的知识或更长的答案来决定. 信息不足时的等待能力,区分用户需求和模型估计的能力,在新条件出现时撤回现有判断的能力,以及在走错误路径时仅以经核实的状态重新开始的能力,是产品可靠性的核心.
本文基于发表时的情况撰写。如需就具体事项咨询,请联系IPLEX。