
Autor: Yongduck Kim, agente de patentes de IPLEX IP Law Firm
Hay momentos extraños al usar IA conversacional como ChatGPT. El modelo, que inicialmente siguió correctamente, va en la dirección equivocada, ya que las condiciones se añaden una por una. A veces vuelves a cometer errores sobre lo que acabas de corregir, y a veces te aferras a las suposiciones que cometiste al principio. A pesar de que todos los registros de conversación permanecen, actúan como si se perdieran algunos términos importantes.
Simplemente explicando este fenómeno como “no puedo recordar porque el contexto es largo” pierde el punto. “LLM Get Lost in Multi-Turn Conversation”, publicado por investigadores de Microsoft Research y Salesforce Research, en comparación con cuando la misma tarea fue instruida completamente a la vez y cuando las instrucciones se dividieron en varias curvas de conversación. Lo que cambió no fue la cantidad de información, sino la forma en que se divulgó la información.
Los resultados fueron bastante claros. El rendimiento medio se redujo de unos 90 puntos en un solo giro a unos 65 puntos en un giro múltiple. El documento resume esto como una disminución promedio del rendimiento relativo del 39%. Por otro lado, aptitude, que indica el potencial de un modelo cuando se resuelve bien, disminuyó sólo un 16% en promedio, y la fiabilidad, lo que muestra lo inestables que son los resultados cuando se repite el mismo problema, aumentó un 112% en promedio. En otras palabras, en lugar de decir “el modelo de repente se hizo estúpido”, es más preciso decir “el modelo ya no era capaz de utilizar la misma habilidad de manera fiable”.
1. El problema no es ‘memoria’ sino ‘cómo manejar solicitudes incompletas’
En realidad, los usuarios no introducen sus requisitos completamente desde el principio. Comience por decir, “Escribe un informe”, luego indicar la longitud en el siguiente mensaje, luego pedir votos, y añadir el público y el propósito al final. Sin embargo, muchas evaluaciones existentes de LLM evalúan el modelo con todas las condiciones necesarias incluidas en el primer momento. Este documento aisló esta brecha a través de experimentos.
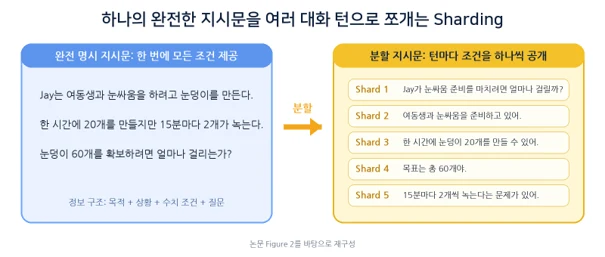
La primera condición distinguida por los investigadores es Fully-Specified. Dado que el propósito del uso, las limitaciones, los datos de entrada y el formato de salida están incluidos en el primer mensaje, el modelo puede producir inmediatamente la respuesta final. A la inversa, en un giro multiespejado, sólo el propósito principal se da en el primer mensaje, y las condiciones detalladas se revelan secuencialmente en giros posteriores. En este momento, el modelo debe dejar en blanco o hacer preguntas acerca de partes que aún no se conocen, pero en realidad, a menudo adivinó los espacios en blanco y completó la respuesta demasiado pronto.
El punto importante es que el formato multi-torno en sí no es siempre una cosa mala. En tareas en las que los resultados de cada giro pueden vincularse independientemente, como la traducción, la caída del rendimiento fue relativamente pequeña. Por otro lado, los problemas surgieron significativamente en tareas donde todo el código existente, SQL, fórmula de cálculo y resumen tuvieron que ser reeditados cada vez que se introdujo una nueva condición. Al final, la dificultad era si todo el diálogo anterior debía reintegrarse de acuerdo con las nuevas condiciones.
2. Los investigadores rompieron la conversación en pequeños pedazos y los hicieron resolver el mismo problema de nuevo.
Los investigadores dividieron las instrucciones completas en piezas atómicas de información, luego colocaron el propósito de alto nivel en la primera pieza y condiciones detalladas en las piezas restantes. El simulador de usuario entregado en la mayoría de una condición que aún no se había revelado en cada turno, y el modelo que se evalúa respondió como si hablara con un usuario regular sin conocer la estructura del experimento. Este método se llama Conversación Durada.
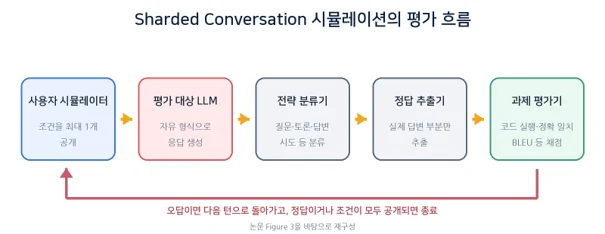
Las respuestas del modelo se clasificaron en preguntas, debates, rechazos, candidatos hipotéticos y intentos de respuesta reales. Cuando el modelo intentó una respuesta, se anotó utilizando un evaluador apropiado para la tarea, incluyendo ejecución de código, ejecución SQL, coincidencia exacta, BLEU, y puntuaciones sumarias con citas. Si la respuesta era incorrecta, se reveló la siguiente condición, y si se dio la respuesta correcta o no había otras condiciones para ser revelada, la conversación terminó.
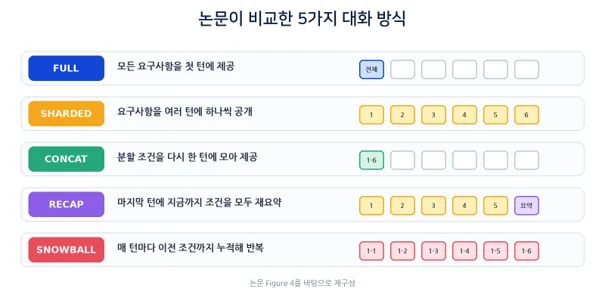
Las condiciones de comparación también fueron cuidadosamente diseñadas. FULL es la condición de referencia para proporcionar la directiva completa original en el primer turno. SHARDED revela las condiciones en varios giros. CONCAT combina las frases divididas en SHARDED en un solo giro y comprueba si se debe a una simple reexpresión de frases o pérdida de información. RECAP reorganiza todas las condiciones al final de la conversación SHARDED, y SNOWBALL repite acumulativamente las condiciones hasta ahora cada turno. Al comparar estas cinco condiciones, podemos separar en cierta medida “el acto de compartir información” y “el fracaso para integrarse en múltiples turnos”.
3. El mismo fenómeno se repitió con 15 modelos y 200.000 conversaciones.
El alcance del experimento no se limita a uno o dos modelos. Los investigadores utilizaron seis tipos de tareas, incluyendo generación de códigos, tareas de base de datos que convierten el lenguaje natural en SQL, generación de llamadas API, matemáticas elementales, tareas que explican tablas en oraciones, y tareas que citan y resumen múltiples documentos. Para cada tarea, se crearon 90 a 120 instrucciones divididas, haciendo un total de 600 instrucciones.
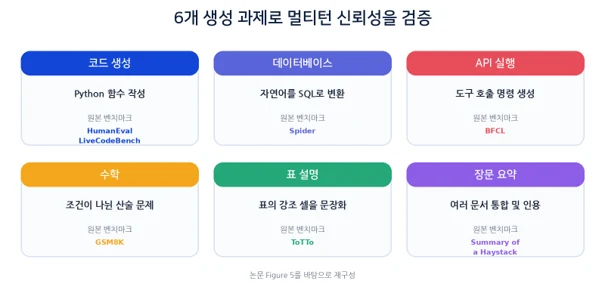
El objetivo de comparación incluía 15 modelos representativos en ese momento, entre ellos GPT-4.1, GPT-4o, o3, Gemini 2.5 Pro y Flash, Claude 3.7 Sonnet, DeepSeek-R1, serie Llama, Phi-4, OLMo 2, y Command-A. Al repetir la combinación de modelos, directivas y condiciones de conversación varias veces, el número total de conversaciones superó los 200.000.
La razón por la que se repite el mismo problema también es importante. Debido a que LLM genera oraciones probabilísticamente, es difícil juzgar la estabilidad con un solo éxito o fracaso. Al ejecutar el mismo problema varias veces, se puede ver no sólo el rendimiento promedio, sino también la brecha entre cuando funcionó bien y cuando falló mal. El punto clave de este documento es que presenta el “gap” como un problema de fiabilidad separado.
4. El número que debe prestar más atención que la caída del 39% es el ‘un aumento del 112%’.
El documento no sólo miraba el rendimiento promedio, sino que también miraba la aptitud y la falta de fiabilidad por separado. Aptitud se refiere al nivel superior del 10% de rendimiento durante la ejecución repetida. En pocas palabras, muestra hasta qué punto el modelo puede lograr cuando resuelve un problema en buenas condiciones. La fiabilidad es la diferencia entre el rendimiento del 10% superior y el 10% inferior en la misma instrucción. Cuanto mayor sea este valor, mayor será el resultado dependiendo del camino de conversación, incluso para la misma solicitud.
Todos los modelos mostraron menor rendimiento en SHARDED que FULL en todas las tareas. El rendimiento medio disminuyó 25 puntos de aproximadamente 90 a 65, una disminución promedio del 39% en términos relativos. Sin embargo, la aptitud disminuyó sólo en un 16% en promedio. Por otra parte, la confianza aumentó en un promedio del 112%, más que duplicar. Incluso dentro de una sola instrucción, había una diferencia promedio de unos 50 puntos entre la mejor y la peor ejecución.
Los resultados del CONCAT refuerzan esta interpretación. Cuando las condiciones divididas se combinaron una vez más, el rendimiento se mantuvo en cerca del 95,1% del FULL. En otras palabras, es difícil decir que el rendimiento se deterioró porque se perdió la información o se cambiaron las expresiones cuando las frases se dividieron en piezas más pequeñas. En una situación en la que se debía recibir la misma información durante varias vueltas, el proceso del modelo que integraba el estado de conversación era un problema.
Así que el mensaje de este artículo no es “Incluso el último LLM no puede hacer varios giros”. Una expresión más precisa es “Usted puede hacerlo bien, pero no puede reproducir fiablemente esa capacidad cada vez.” Desde una perspectiva de producto, es importante ver cómo los resultados fluctúan cuando los mismos requisitos se presentan en diferentes órdenes y caminos de conversación, en lugar de la puntuación más alta de referencia.
5. ¿Por qué los modelos se pierden en conversaciones?
Completa tu respuesta demasiado pronto
En las tareas de código y matemáticas, cuando el primer intento de respuesta ocurrió dentro del primer 20% de la conversación, la puntuación media fue de 30.9. Por el contrario, si esperó hasta el último 20%, la puntuación media fue de 64.4. Si el modelo crea una respuesta primero a pesar de que las condiciones necesarias aún no han sido completamente reveladas, hay una mayor posibilidad de que la respuesta contendrá supuestos que el usuario no ha escuchado.
Anclado en hipótesis tempranas
En LLM, existe una tendencia a completar las respuestas llenando valores plausibles del contexto en lugar de dejar partes desconocidas como es. El problema es cuando las nuevas condiciones vienen desde atrás. Los modelos a menudo modifican sólo parte de la estructura que ya han creado en lugar de descartar y recalcular toda la respuesta. La premisa defectuosa inicial se convierte entonces en el marco de la conversación, y las correcciones posteriores continúan a construir sobre ella.
Cuanto más editas, mayor será la respuesta.
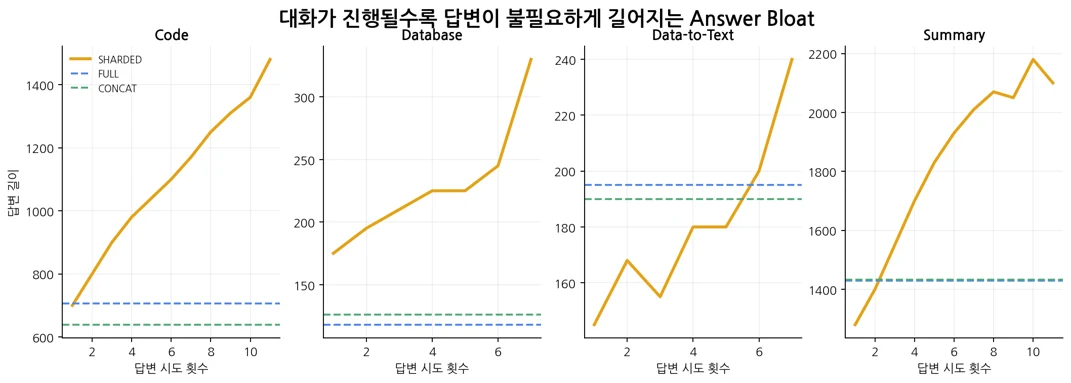
La respuesta final SHARDED fue 20-300% más larga que la respuesta FULL o CONCAT. Mirando las respuestas correctas por sí solas, las respuestas de código fueron un 27% más en promedio y las respuestas SQL fueron un 14% más en promedio. Los investigadores llaman a este Bloat de Respuesta. Esto se debe a que el modelo responde añadiendo excepciones y explicaciones de corrección en lugar de borrar la respuesta anterior y calcular de nuevo.
El giro medio se vuelve más débil y los primeros y últimos giros se vuelven más fuertes.
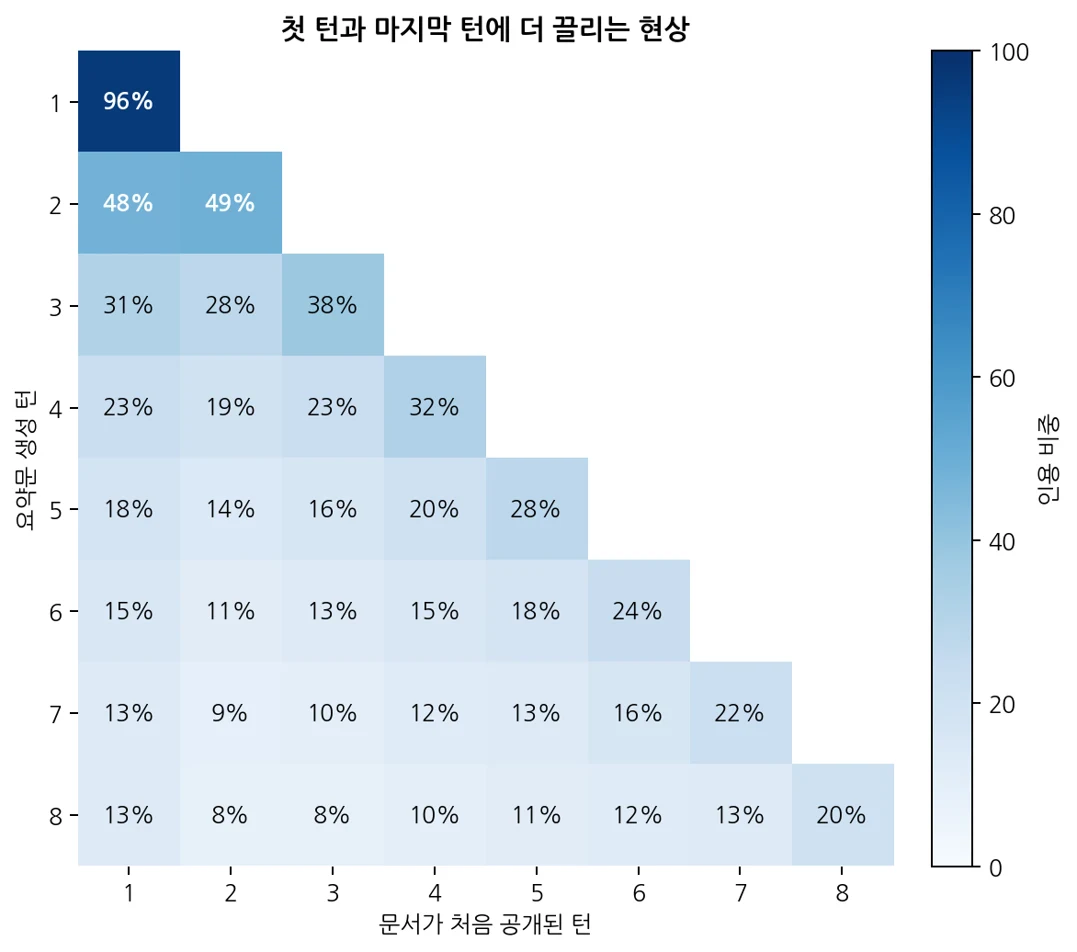
En la larga tarea sumaria, el resumen de la octava vuelta citó el 20% de los documentos publicados en el último turno, mientras que los documentos publicados en las segundas y terceras vueltas citaron sólo el 8% cada uno. Este es un fenómeno en el que la información al principio y al final de una conversación se refleja relativamente fuertemente, y las condiciones que se introducen en el medio se debilitan. Los investigadores llamaron a este Loss-in-Middle-Turns.
Las respuestas largas y amistosas pueden convertirse en ruido.
En cinco de las seis tareas, el grupo de respuesta más corto realizó del 10 al 50 por ciento mejor que el grupo de respuesta más largo. Cuanto más tiempo se crea la descripción en los primeros turnos, más supuestos y soluciones de trabajo el usuario puede dejar sin estado, lo que se convierte en parte de la nueva entrada en turnos posteriores. En una situación de giro múltiple, la capacidad de determinar “lo que todavía no sabemos” y hacer preguntas de confirmación cortas puede ser más importante que la capacidad de ver respuestas largas al principio.
6. El contexto más largo y más inferencias no eran suficientes
El remedio más fácil es repetir la conversación de nuevo. Si todas las condiciones se reorganizan al final como RECAP, el rendimiento se mejora sobre SHARDED. Sin embargo, en los servicios reales, es difícil saber cuándo el usuario declaró la última condición. Como SNOWBALL, repetir las condiciones previas cada vuelta aliviaba alrededor del 15-20% de la degradación del rendimiento, pero el impulso rápidamente se volvió más largo y no se recuperó al nivel FULL.
Los métodos para reducir la aleatoriedad de la generación también eran limitados. Bajar la temperatura redujo significativamente la fiabilidad en giros individuales, pero la mejora fue pequeña en varios giros. Incluso a temperatura cero, aproximadamente el 30% de la insuficiencia se mantuvo. En las conversaciones, las pequeñas diferencias en un turno cambian la entrada en el siguiente turno, por lo que es difícil eliminar errores acumulativos sólo reduciendo la aleatoriedad de una sola generación.
Los modelos que utilizan más cálculos inferenciales tampoco podrían resolverse automáticamente. Los modelos de inferencia como o3 y DeepSeek-R1 también mostraron una degradación del rendimiento de múltiples giros similar a los modelos de no inferencia. Los investigadores señalan que los modelos de inferencia tienden a producir respuestas más largas en promedio. Cuanto más larga sea la respuesta, más hipótesis el modelo se hace sobre sí mismo, y más difícil puede ser distinguir entre las necesidades del usuario y las estimaciones del modelo en el siguiente turno.
7. Los productos de IA conversacional deben ser diseñados para la ‘gestión del estado’ en lugar de ‘generación más alta’
Si usted lee estos resultados desde una perspectiva de diseño de producto, la dirección se vuelve bastante clara. Primero, necesitamos una puerta de respuesta final que no produzca una respuesta completa hasta que se cumplan los requisitos. Esto significa que en lugar de un simple “si no lo sabes, preguntar” rápido, la lógica de control es necesaria para determinar si la creación final está permitida en el estado actual.
En segundo lugar, es importante no mezclar las condiciones de usuario y las hipótesis modelo dentro del mismo registro de conversaciones. Los requisitos confirmados por el usuario, los elementos no confirmados, los valores estimados temporalmente por el modelo, y las condiciones posteriormente retiradas deben almacenarse por separado en un estado estructurado. De esa manera, cuando entran nuevas condiciones, puedes decidir qué guardar y qué desechar.
En tercer lugar, se necesita un procedimiento para verificar si los nuevos conflictos de información con las hipótesis existentes y, de ser así, invalidar los resultados intermedios conexos y redactar respuestas. Simplemente diciéndole al modelo, “Modify”, puede crear un Bloat de Respuesta que se suma a la estructura existente mientras la preserva. Si es necesario, es más confiable comenzar una nueva rama de inferencia tomando sólo condiciones verificadas en lugar de modificar la respuesta anterior.
Cuarto, en lugar de resumir toda la conversación en ciertos puntos, puede ser útil reorganizar “sólo las condiciones de usuario verificadas” en directivas totalmente explícitas. Utilizar señales como el número de giros, el número de tokens, el número de conflictos de condiciones y el número de modificaciones de respuesta para determinar el momento de la resummarización o reiniciar es también un punto de diseño a nivel de producto.
Por último, la evaluación no debe terminar con sólo el porcentaje medio de respuestas correctas. Los mismos requisitos deben ejecutarse repetidamente en diferentes secuencias de información para medir la diferencia de rendimiento, la tasa de retiro de hipótesis, la tasa de recuperación después de la respuesta incorrecta y la brecha más difícil. El problema de fiabilidad que este artículo aborda no es en última instancia una cuestión de “¿puedes hacerlo bien una vez?”, pero “¿puedes hacerlo de forma fiable en múltiples maneras?”
8. En la práctica de patentes, la clave es “estructura de control de diálogo”
En lugar de proponer una nueva arquitectura modelo base, este artículo está más cerca de un estudio que presenta un marco de evaluación e indicadores de fiabilidad que reproducen y cuantifican las vulnerabilidades de la IA conversacional. Por lo tanto, al examinar la diferenciación técnica a nivel de producto o servicio, la estructura de gestión del estado específica y los procedimientos de control que implementan ese objetivo son más importantes que el objetivo abstracto de “LLM maneja bien multi giro”.
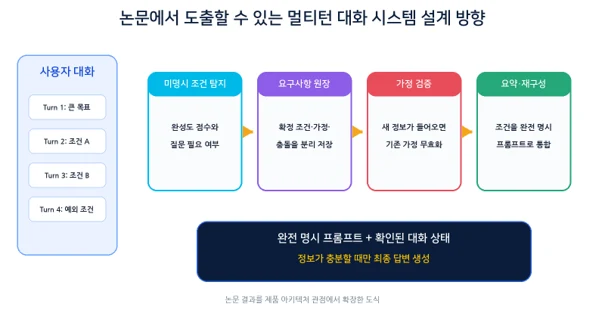
Por ejemplo, la detección de condiciones no especificadas que determina si la respuesta final se puede crear con sólo la entrada actual, requisitos libro mayor que almacena condiciones confirmadas, condiciones no confirmadas, supuestos modelo, y condiciones de retiro por separado, la invalidación de hipótesis que detecta conflictos entre nuevas declaraciones y supuestos existentes y descarta selectivamente salidas intermedias, disparador sumario que reorganiza el estado de conversación en un impulso completamente explícito bajo ciertas condiciones, intercambio de conversaciones que inicia una nueva recuperación. Puede especificarse como una configuración técnica.
Sin embargo, la diferenciación no es fácil con ideas abstractas tales como “summarizar conversaciones anteriores”, “preguntas rápidas cuando sea necesario”, y “recordar conversaciones”. Se hace más fácil explicar características técnicas y efectos especificando qué información se almacena en qué estructura de datos, qué señales se utilizan para juzgar estados no especificados, qué unidades las suposiciones están conectadas y invalidadas, cuando la llamada final del modelo está bloqueada o permitida, y cómo el índice de error, tasa de recuperación
Además, este artículo fue publicado el 9 de mayo de 2025. Más tarde, al revisar los pasos novedosos/inventivos de las tecnologías relacionadas, puede ser difícil reclamar diferenciación basada en la simple simulación durada, comparación FULL·CONCAT·SHARDED, repetición RECAP·SNOWBALL, y definiciones de aptitud y fiabilidad. En la concesión de licencias efectivas, las configuraciones adicionales, como la estructura de gestión del estado específica de productos, el procedimiento de verificación de colisiones, el enrutamiento de modelos, el ahorro de recursos y el control de seguridad, son importantes.
9. Los usuarios también pueden reducir la probabilidad de fracaso cambiando ligeramente su estilo de conversación.
También hay lecciones que se pueden aplicar a los usuarios ordinarios. Esto no significa que todas las condiciones deben ser escritas perfectamente en la primera solicitud. Más bien, si las condiciones están menos definidas, es mejor especificar “Si hay información insuficiente, haga una pregunta de confirmación primero” para evitar que el modelo lo llene arbitrariamente. Al agregar condiciones, es una buena idea indicar claramente cuál de las condiciones existentes para guardar y qué cambiar o eliminar.
Si la conversación es larga, se puede preguntar una vez en el centro, “Por favor reorganice sólo las condiciones que he confirmado hasta ahora, e indique por separado lo que usted ha estimado.” Si el modelo ya parece estar profundamente anclado en una estructura incorrecta, puede ser más estable insertar sólo las condiciones confirmadas en un nuevo diálogo de inmediato y empezar de nuevo, en lugar de modificarlo continuamente. Para tareas importantes, un método de verificación realista es ejecutar el mismo impulso completamente explícito de nuevo en un nuevo diálogo y comparar los resultados.
Conclusión. Una buena IA conversacional está más cerca de un ‘sistema que regresa de un camino equivocado’ en lugar de un ‘modelo que lo hace bien desde el principio’.
Este documento muestra que los modelos con puntos de referencia de alto rendimiento no necesariamente proporcionan la misma calidad de forma fiable en los servicios interactivos reales. Cuando los requerimientos se liberan en múltiples turnos, el modelo puede falsificar creando respuestas demasiado tempranas, sosteniendo sus suposiciones como hechos, reflexionando débilmente las condiciones a mediados de los giros, y continuando anexando las respuestas existentes.
Por lo tanto, es probable que la competitividad de la próxima generación de IA conversacional no se determine únicamente por más conocimiento o respuestas más largas. La capacidad de esperar cuando la información es insuficiente, la capacidad de distinguir entre las necesidades de los usuarios y las estimaciones modelo, la capacidad de retirar los juicios existentes cuando entran nuevas condiciones, y la capacidad de comenzar con sólo el estado verificado al bajar una ruta incorrecta son el núcleo de la fiabilidad del producto.
Este artículo del archivo refleja la situación en su fecha de publicación. Contacte con el despacho para analizar su caso.