
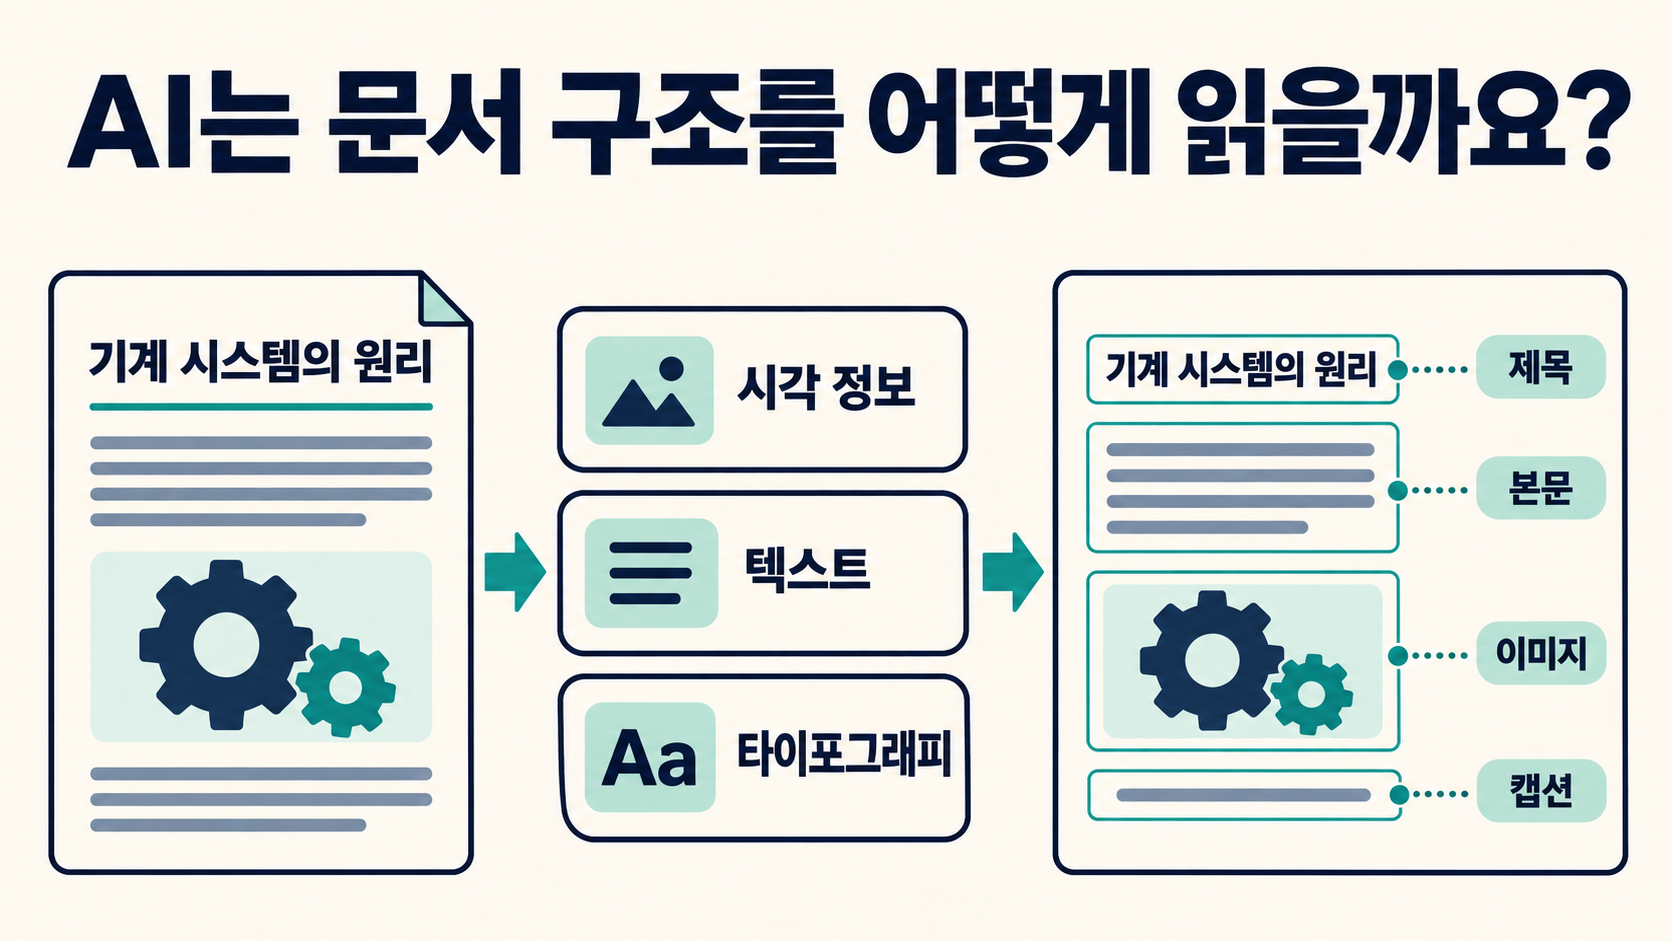
将设备手册中的文字提取为连续文本,可能会丢失操作步骤所属的标题,也可能无法判断图片下方的说明究竟对应哪张图。谷歌的美国专利US12393768B2提出,将文档划分为多个块,表示每个块的内容与布局,再处理相邻块之间的关系,形成整个文档的表示。本文以虚构检查手册为例,说明这两个阶段的区别,以及文档检索为何需要保留标题、插图与正文之间的联系。
识别出文字后,为什么仍可能失去原意
假设现场人员在设备手册中找到“关闭盖板后检查”这句话。要实际使用这条信息,还需要知道它针对哪台设备,以及右侧插图是否在说明同一操作。如果同一页包含两个章节,标题与说明所处的位置也会成为重要线索。
从文档图像中检测文字并转换为文本的技术,称为光学字符识别,即OCR。如果只保存识别出的文字列表,原页面中相邻元素之间的关系可能随之丢失。因此,识别文字与确定文字属于文档的哪个部分,是相互配合的两个任务。
这件谷歌专利同时考虑文字、图像及其布局,也就是各元素在页面中的位置和排列。粗体内容是否为章节标题,下方段落是否承接该标题,插图与说明如何对应,都可以通过输入给模型的相关信息加以考虑。
先将标题、段落与插图划分为块
处理首先将文档划分为多个块。块是具有一定作用的区域,例如标题、段落、图像或表格。说明书中的示例会使用页面位置、字体、颜色及格式等信息。对于网页文档,标识标题或段落的HTML标签也可以作为划分依据。
设想双栏文档中左右两栏在同一高度各有一行文字。读完左侧一行就直接接上右侧一行,可能把两个章节的内容混在一起。先识别段落区域并保留各区域的位置,后续模型才有依据判断哪些元素应当关联处理。
这一阶段需要把区域内容与布局结合起来。例如,一个块可以同时记录“定期检查”这几个字、大号粗体格式,以及它位于页面上方的信息。图像块保存视觉特征,下方说明可以表示为独立块或相关内容。
从块级表示进一步形成文档级表示
第一个模型将每个块转换为可计算的数值表示,这一过程称为编码。文本块可以提供语句内容及格式,图像块可以提供图像特征。专利还规定,将各块对应的布局数据作为输入提供给该模型。
第二个模型共同处理各块的表示,以及相邻块之间的局部联系。第一阶段表示“块内有什么”,第二阶段则把“它与文档其他部分有什么关系”纳入计算,由此形成包含标题、说明和图像的文档整体表示。
文档级表示随后可供其他任务使用。说明书举出了查找相关文档、判断文档类别等用途,也说明了从候选图像中推荐适合插入文档的图像的流程。无论用于哪种任务,分别表示块的内容与进一步表示文档内的关系,都是这两级处理的核心。
通过预训练学习顺序和图文关系
可以设置训练任务,让模型学习标题与说明如何衔接。例如,交换两个块的位置,让模型判断顺序是否正确。专利还描述了遮盖部分文字或整个块,再根据周围信息进行预测的预训练任务。
图像与文本的关系也可以用于训练。将训练文档中的图像替换为另一篇文档的图像后,可让模型判断是否发生了替换。另一类任务会遮盖文档中的图像,再从候选中选出合适的图像。这样,模型学习的不仅是图像本身的特征,还包括图像与周围说明的联系。
这些预训练任务用于让模型学习文档结构的线索。在实际处理新手册时,已经训练好的模型会表示输入文档的各个块及其关系。后续采用何种处理,取决于这些表示是用于检索、分类还是文档整理。
用双栏检查手册说明标题和图注的联系
假设一份虚构手册的顶部有“定期检查”大标题,左栏列出检查步骤,右栏放置设备插图及简短图注。先划分区域,就能分别处理标题、步骤段落、插图和图下说明。
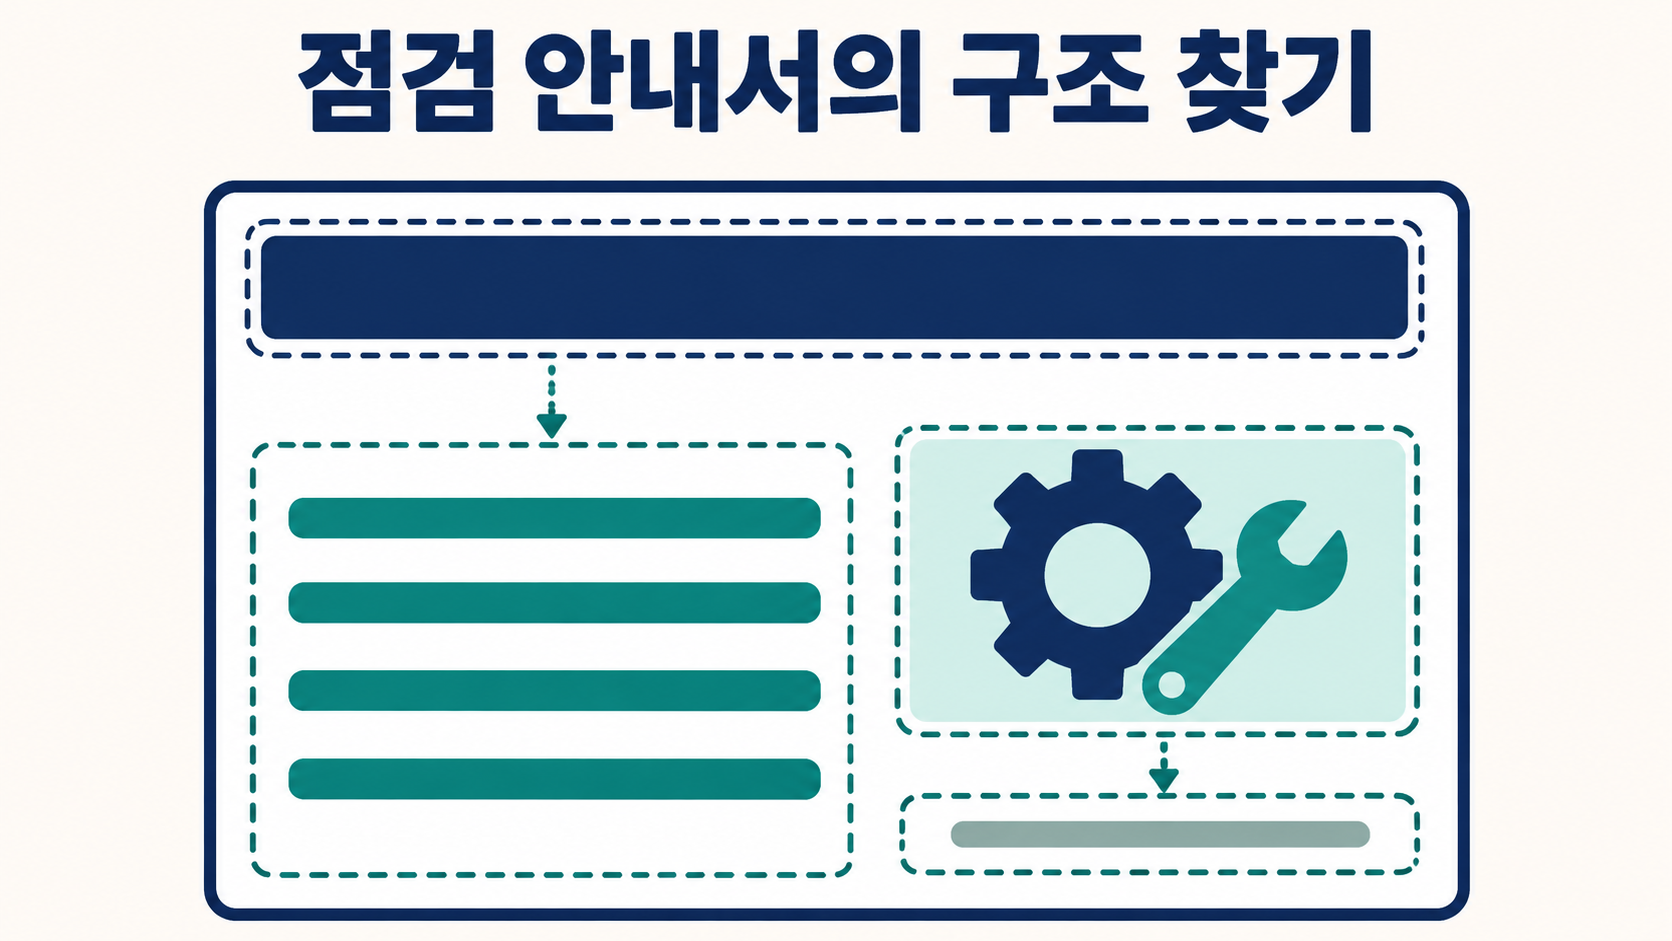
在块级层面,标题包含大字号和简短文字,步骤块包含多行操作内容,图像块包含设备外观。在文档级层面,标题与步骤的联系、插图与图注的联系都具有意义。即使左侧步骤与右侧图注处于同一高度,也可以考虑它们分别属于哪个区域。
将这些信息用于检索时,可以在返回“检查盖板”这句话的同时,提供其所属章节标题和相关插图的说明。这是一种利用结构信息的设想,能帮助读者判断这句话属于哪项操作,而不是只看到一个脱离上下文的句子。
区分Document AI输出的文档结构
Google Cloud官方资料介绍了多种不同的文档处理功能。Enterprise Document OCR可提取文字与布局信息,包括字符、行、词和段落。扫描手册的可搜索化处理,就是这类输出的应用场景之一。
Document AI的Layout Parser资料介绍了识别PDF中的标题、表格、列表和插图等元素,并返回结构化文档层级的功能。在将文档划分为便于检索的小单元时,还可以附加相应的上级标题。这些保留上下文的单元通常称为文本块或检索分块,即chunk。
汇集设备资料建立检索系统时,可以使用保留章节标题与段落关系的分块。专利原文解释了如何将文档块及其关系处理为数值表示;产品资料则介绍了保留结构和标题上下文的输出如何用于业务。两类资料应当分别理解。
同时检查文字准确性和文档元素之间的对应
评价文档处理系统时,首先应明确输出的用途。如果业务需要保持标题与步骤的关系,除了检查文字识别是否正确,还应检查步骤是否归入了正确的标题。如果结果同时展示插图,则需要关注图注是否对应正确的图像。
比较材料也应具体选择,例如相同句子出现在不同标题下的手册、双栏页面,以及图片与图注相距较远的文档。依次记录输入时保留的布局信息、中间阶段形成的块,以及检索结果所附的依据,有助于定位错误。
准备技术说明时,也可以分别梳理文字识别、块的生成、关系处理及最终业务应用。说明各阶段加入了哪些信息、这些信息如何进入下一步计算,更有利于具体呈现不同文档处理方法的技术差异。
图中保留原始标注与形态,相关内容在正文中说明。
检查手册为解释原理而设的虚构示例。本篇技术概述并非完整的权利要求范围说明:权利要求1还包括候选图像推荐,以及基于识别另一文档图像替换情况的训练条件;权利要求14、19涉及训练系统与存储介质的具体配置。仅凭产品资料,不能断定Document AI实施了专利中的全部技术要素。
Google Cloud Layout Parser官方资料
Google Cloud Enterprise Document OCR官方资料
如需从专利角度梳理文档处理机制及其技术差异,可参阅IPLEX的AI项目与咨询准备资料。