
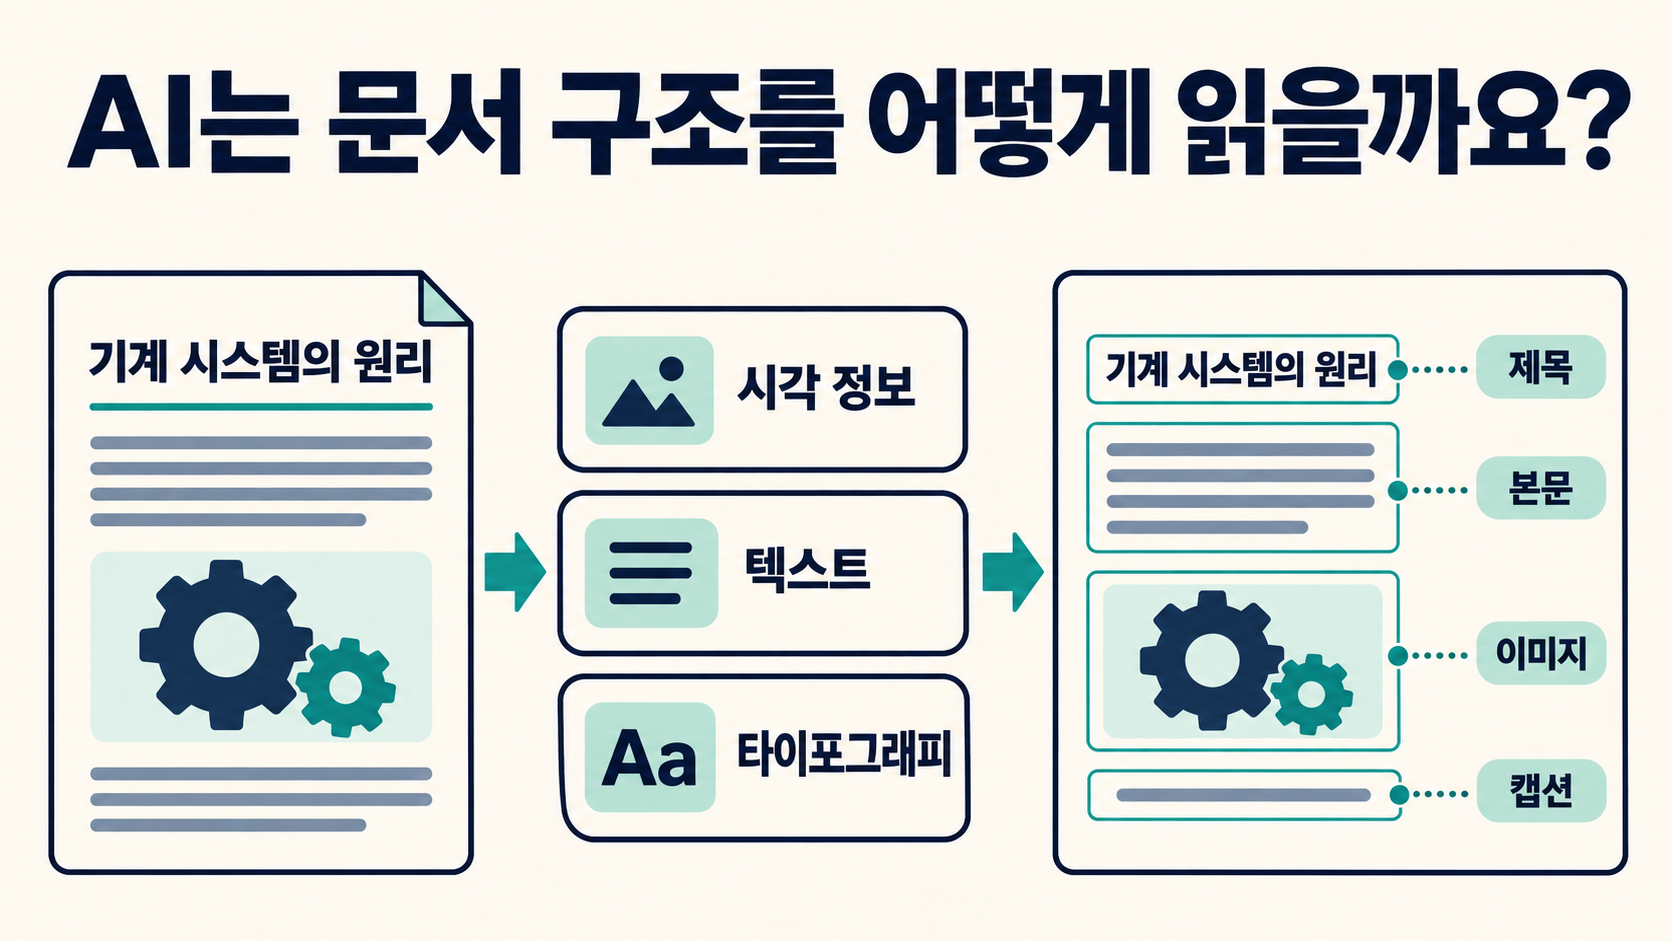
Если извлечь из руководства по оборудованию только сплошной текст, можно потерять связь между процедурой и её заголовком или между фотографией и подписью. В патенте Google US12393768B2 описано разделение документа на блоки, представление их содержимого и расположения, а затем обработка связей между соседними блоками для получения представления всего документа. На примере условной инструкции по проверке оборудования рассмотрим различие этих двух этапов и значение связей между заголовками, иллюстрациями и основным текстом для поиска.
Почему распознанные слова могут утратить контекст
Допустим, специалист нашёл в инструкции фразу «Проверьте после закрытия крышки». Чтобы воспользоваться ею, нужно понимать, к какому оборудованию относится действие и поясняет ли его рисунок справа. Если на странице размещены два раздела, расположение заголовков и пояснений становится важной подсказкой.
Оптическое распознавание символов, или OCR, обнаруживает текст на изображении документа и преобразует его в машинно-читаемые символы. Сохранение только списка слов может привести к утрате отношений между элементами, которые находились рядом на исходной странице. Поэтому распознавание текста и определение его места в структуре документа решают взаимодополняющие задачи.
Патент Google рассматривает не только текст и изображения, но и макет: положение элементов и их размещение на странице. Полужирное начертание может указывать на заголовок, следующий абзац — относиться к этому разделу, а подпись — пояснять соседний рисунок. Модель получает данные, позволяющие учитывать такие связи.
Разделение заголовков, абзацев и рисунков на блоки
Сначала документ разделяется на блоки. Блок представляет область с определённой функцией: заголовок, абзац, изображение или таблицу. В описании приводятся примеры использования координат, шрифта, цвета и форматирования. В веб-документах границы блоков могут определяться также с учётом HTML-тегов заголовков и абзацев.
Представим две строки на одинаковой высоте в документе с двумя колонками. Автоматический переход от левой строки к правой способен смешать содержание разных разделов. Если предварительно выделить области абзацев и сохранить их положение, последующая модель получит данные для определения того, какие элементы следует рассматривать совместно.
На этом этапе содержимое области связывается с данными о расположении. Например, один блок может включать слова «Плановая проверка», крупный полужирный шрифт и положение в верхней части страницы. Блок изображения содержит визуальные признаки, а пояснение под ним может быть отдельным блоком или связанным содержимым.
От кодирования блоков к представлению документа
Первая модель преобразует содержимое каждого блока в числовое представление, пригодное для вычислений. Этот процесс называется кодированием. Текстовый блок может передавать формулировки и форматирование, а блок изображения — визуальные признаки. Патент предусматривает также подачу в эту модель данных о расположении соответствующего блока.
Вторая модель обрабатывает полученные представления вместе с локальными связями между соседними блоками. Первая ступень выражает то, что находится внутри блока, а следующая учитывает его отношение к другим частям документа. Результатом становится общее представление документа с его заголовками, пояснениями и изображениями.
Это представление используется в последующих задачах. В описании рассматриваются поиск связанных документов и классификация по типам. Также приведён процесс рекомендации подходящего изображения из набора кандидатов для размещения в документе. Основная идея двух ступеней — раздельно представить содержимое блоков и их отношения внутри документа.
Предобучение на порядке блоков и связях изображений с текстом
Учебные задачи могут помочь модели освоить связь между заголовками и пояснениями. Например, два блока меняют местами, после чего модель определяет, верен ли их порядок. Патент описывает и маскирование части текста или целого блока с последующим предсказанием на основании окружающей информации.
Другие задачи касаются изображений и текста. Изображение заменяют изображением из другого учебного документа и обучают модель распознавать факт замены. Можно также скрыть изображение и выбрать подходящее из набора кандидатов. Тем самым в обучение включаются не только визуальные признаки, но и отношения изображения с поясняющим его текстом.
Такое предобучение знакомит модель с признаками структуры документа. При обработке новой инструкции уже обученная модель представляет её блоки и связи между ними. Дальнейшая обработка зависит от назначения представлений: поиска, классификации или систематизации документов.
Связи в условной инструкции с двумя колонками
Представим условную инструкцию: сверху расположен крупный заголовок «Плановая проверка», слева — последовательность действий, справа — рисунок оборудования с короткой подписью. Разделение областей позволяет отдельно рассматривать заголовок, абзац с процедурой, рисунок и пояснение под ним.
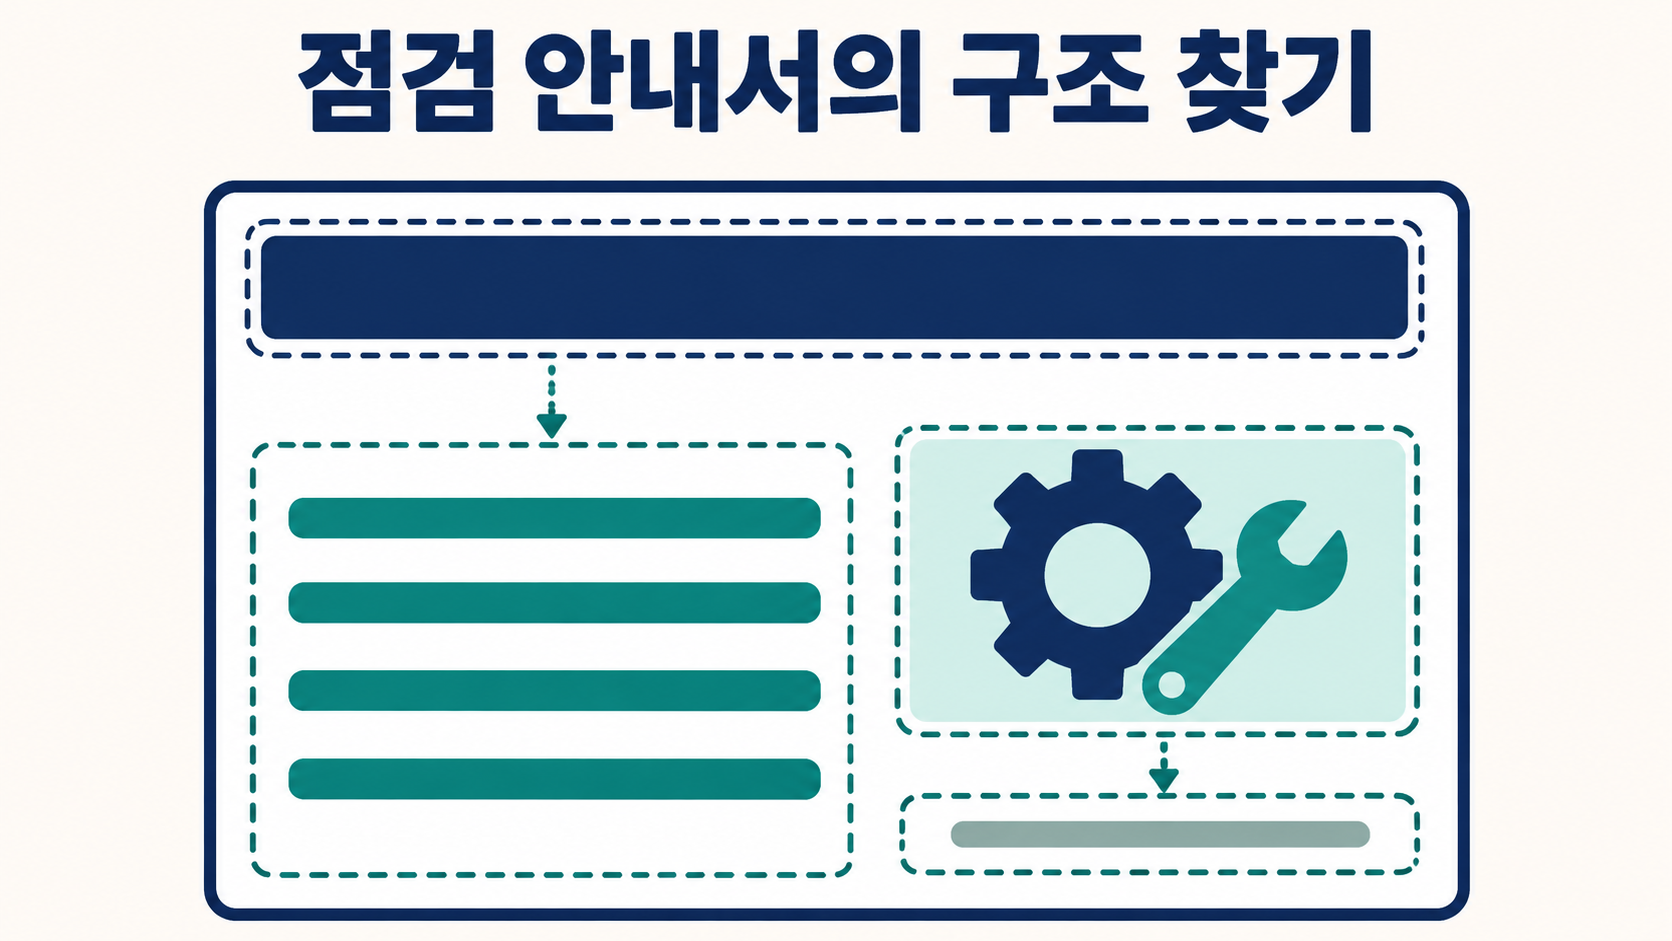
На уровне блоков заголовок содержит короткую фразу и крупный шрифт, процедура — несколько строк указаний, а изображение — внешний вид оборудования. На уровне документа значимы отношения «заголовок — процедура» и «рисунок — подпись». Даже текстовые элементы на одной высоте в разных колонках можно соотнести с их собственными областями.
В поисковом приложении фразу «Проверьте крышку» можно было бы возвращать вместе с названием раздела и пояснением к связанному рисунку. Это пример возможного применения структуры: читатель лучше понимает, частью какой процедуры является фраза, чем при её показе вне контекста.
Какую структуру возвращает Document AI
Официальная документация Google Cloud описывает несколько разных функций обработки документов. Enterprise Document OCR извлекает текст и данные о расположении, включая символы, строки, слова и абзацы. Такой результат может использоваться, например, для организации поиска по отсканированным инструкциям.
Документация Layout Parser в составе Document AI описывает выделение в PDF заголовков, таблиц, списков и рисунков с возвратом структурированной иерархии документа. При разбиении материала на небольшие единицы для поиска к ним могут добавляться соответствующие заголовки верхних уровней. Такие единицы с сохранённым контекстом называют фрагментами, или чанками.
Команда, создающая поиск по техническим руководствам, может использовать фрагменты, сохраняющие связь разделов и абзацев. Патент объясняет способ числового представления блоков и отношений, а документация продукта — применение результатов, сохраняющих структуру и контекст заголовков. Эти источники следует рассматривать раздельно.
Проверять связи элементов наряду с точностью распознавания
Оценку системы стоит начинать с её назначения. Если для работы важна связь процедуры с заголовком, следует проверить не только правильность распознанных символов, но и отнесение инструкции к нужному разделу. При показе иллюстраций важно также соответствие подписей конкретным рисункам.
Полезно заранее выбрать характерные примеры: руководства с одинаковой фразой под разными заголовками, страницы с двумя колонками, документы с удалёнными от фотографий подписями. Последовательная фиксация сохранённых данных о расположении, промежуточных блоков и оснований, сопровождающих поисковый результат, помогает находить ошибки.
При подготовке технического описания также следует различать распознавание текста, формирование блоков, обработку связей и конечное использование. Чем яснее показано, какие данные добавляются на каждом этапе и как передаются в следующий расчёт, тем конкретнее можно описать различия способов обработки документов.
Сохранены исходные обозначения и формы; содержание раскрыто в тексте.
Инструкция представляет собой условный пример. Обзор технологии не является полным изложением объёма формулы: пункт 1 дополнительно предусматривает рекомендацию изображения и обучение на выявлении замены изображениями из другого документа; пункты 14 и 19 определяют конфигурации системы обучения и носителя данных. Описание продукта само по себе не подтверждает реализацию в Document AI всех признаков патента.
Текст патента USPTO · US12393768B2
Официальная документация Google Cloud Layout Parser
Официальная документация Google Cloud Enterprise Document OCR
Патент Naver на перевод изображений: как совместить перевод с движущимся кадром
Как Baidu обрабатывает противоречия между ответом модели и найденными знаниями
Материалы IPLEX по ИИ и подготовке к консультации помогут описать механизмы обработки документов и их технические отличия для патентной работы.
Опыт патентного поверенного Ким Ёндока в области ИИ