
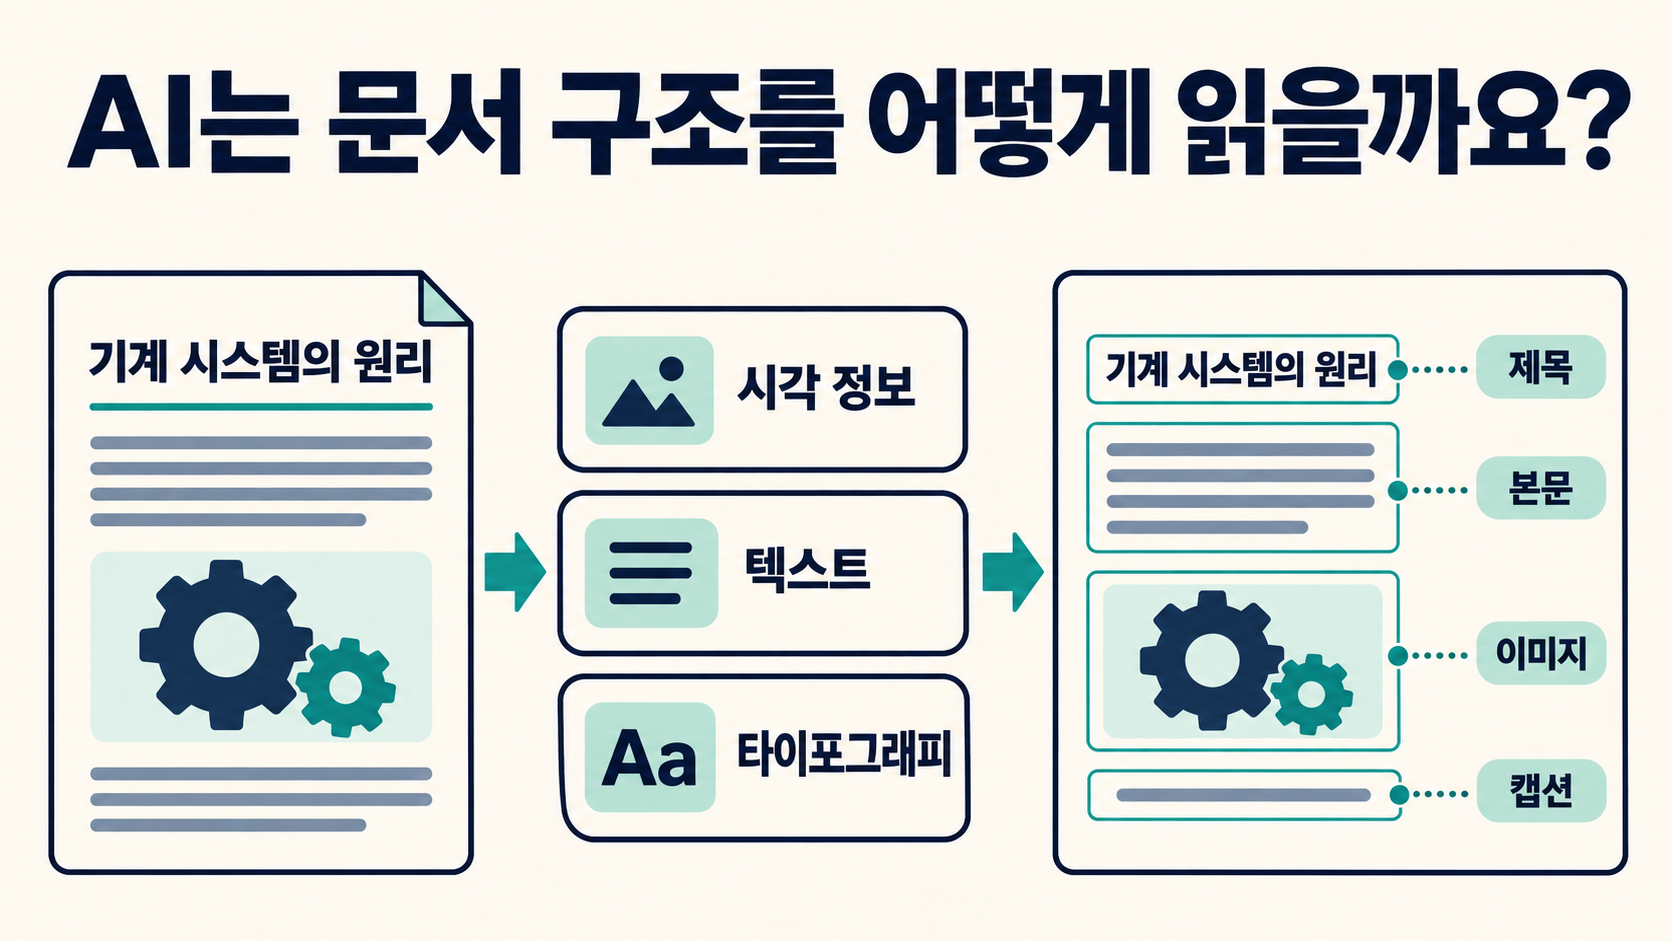
機器のマニュアルから文字だけを取り出して一続きにすると、手順がどの見出しに属するのか、写真の下の説明が何を指すのか分かりにくくなることがあります。Googleの米国特許US12393768B2は、文書をブロックに分け、各ブロックの内容と配置を表現したうえで、隣接するブロックの関係を処理し、文書全体の表現を生成する方法を記載しています。架空の点検マニュアルを使い、この二段階の違いと、文書検索で見出し・図・本文のつながりを残す意味を見ていきます。
文字を認識しても文脈が失われる理由
点検担当者がマニュアルで「カバーを閉じてから確認」という一文を見つけたとします。実際に役立てるには、どの機器の手順なのか、右側の図がその手順を説明しているのかも把握する必要があります。同じページに二つの節があれば、見出しや説明の位置も重要な手掛かりになります。
文書の画像から文字を検出し、テキストに変換する技術が光学式文字認識、OCRです。認識結果を文字列の一覧だけで保存すると、元のページで近くに置かれていた要素同士の関係が失われる場合があります。文字の読み取りと、その文字が文書のどの部分に属するかの整理は、併せて考える必要があります。
このGoogleの特許は、文字や画像とともにレイアウト、すなわちページ内の位置や配置を扱います。太字が節の見出しを示すのか、その下の段落が同じ節の説明なのか、図と説明がどのように配置されているのか。こうした関係を考慮するための情報をモデルに入力する考え方です。
見出し・段落・図をブロックに分ける
最初に文書を複数のブロックに分割します。ブロックは、見出し、段落、画像、表など、文書内で一つの役割を持つ領域です。明細書では、ページ内の位置に加え、フォント、色、書式などの情報を用いる例が示されています。ウェブ文書では、見出しや段落を示すHTMLタグを分割の手掛かりにする方法も記載されています。
二段組みの文書で、左右の同じ高さに文章がある場合を考えてみます。左の行を読んですぐ右の行へ進むと、別々の節の内容が混ざるおそれがあります。段落の領域を先に区別し、その位置を残しておけば、後段のモデルがどの要素を関連付けるか判断するための情報になります。
この段階では、各領域の内容と配置を結び付けた入力が必要です。例えば「定期点検」という文字、大きな太字の書式、ページ上部という位置を一つのブロックの情報として保持します。画像ブロックは視覚的特徴を含み、その下の説明は別のブロックや関連する内容として表せます。
ブロックを符号化し、文書全体の関係を扱う
第一のモデルは、ブロックごとの内容を計算に使える数値の表現へ変換します。これを符号化、またはエンコーディングと呼びます。文字のブロックには文章と書式、画像のブロックには画像の特徴を入力できます。特許には、そのブロックに対応する配置情報もモデルへ入力する構成が記載されています。
第二のモデルは、生成された各ブロックの表現と、隣接ブロック間の局所的なつながりを処理します。第一段階が「このブロックに何が含まれるか」を表すのに対し、第二段階は「文書内の他のブロックとどう関係するか」を計算に反映します。こうして見出し、説明、画像を含む文書全体の表現を生成します。
文書全体の表現は、後続の処理に利用されます。明細書には、関連文書の検索や文書の種類の分類が挙げられています。また、候補画像の中から文書に合う画像を提案する処理も記載されています。個々のブロックの内容を表すことと、文書内の関係を併せて表すことが、二段階の中心です。
順序と画像・文章の関係を事前学習する
見出しと説明のつながりを学ばせるために、学習課題を設定できます。例えば二つのブロックの順序を入れ替え、その順序が適切かをモデルに判定させます。一部の文字やブロックを隠し、周辺情報から予測させる事前学習も記載されています。
画像と文章の関係を扱う課題もあります。学習文書の画像を別の文書の画像に置き換え、置換の有無を判定させる方法です。また、文書内の画像を隠して、候補から適切な画像を選ぶ課題も示されています。画像自体の特徴に加え、その説明や周囲の内容との対応を学習に利用できます。
これらは、文書構造の手掛かりをモデルに学ばせる事前学習です。実務で新たなマニュアルを処理するときは、学習済みモデルが入力文書のブロックと関係を表現します。その表現を検索、分類、文書整理のいずれに利用するかにより、後段の処理が変わります。
二段組みの点検マニュアルで対応関係を考える
架空のマニュアルを想定します。上部に大きく「定期点検」とあり、左側に点検手順、右側に機器の図と短い説明が置かれています。領域を先に分けることで、見出し、手順の段落、図、図の下の説明をそれぞれ扱えます。
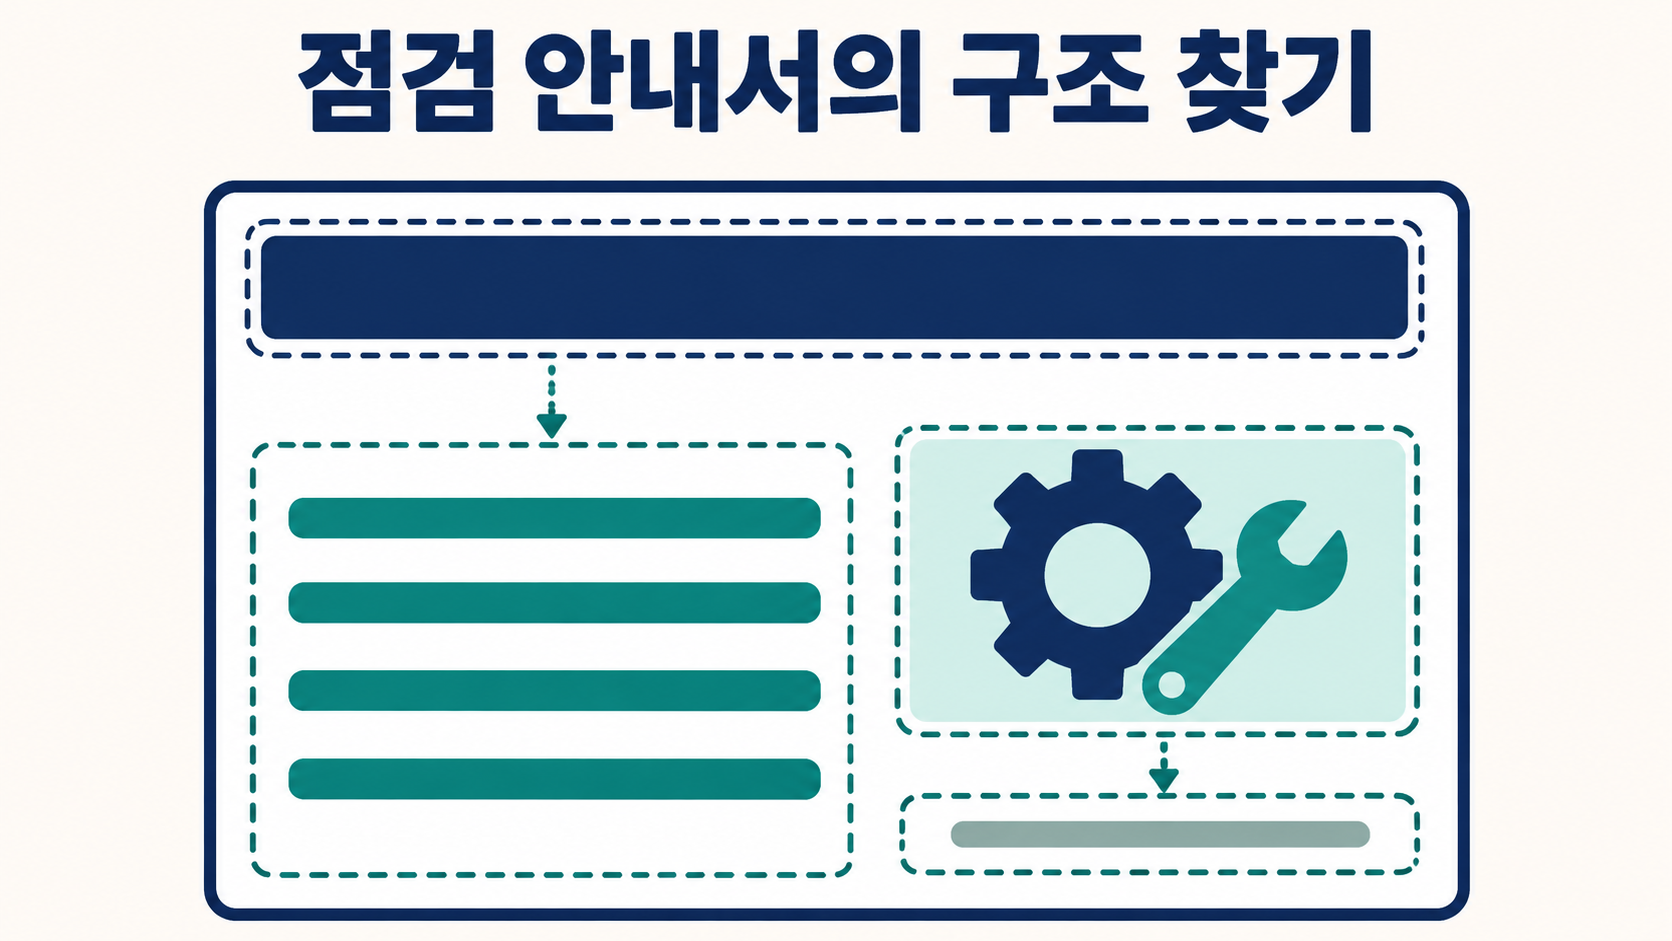
ブロック単位では、見出しは大きな文字と短い語句、手順は複数行の作業内容、図は機器の外観を含みます。文書単位では、見出しと手順、図と説明のつながりが意味を持ちます。左側の手順と右側の説明が同じ高さにあっても、それぞれが属する領域を考慮できます。
検索に利用するなら、「カバーを確認」という一文とともに、その節の見出しや関連する図の説明も返す方法が考えられます。これは構造情報の利用例であり、一文だけを示すより、どの作業手順の一部なのかを読者が把握しやすくなります。
Document AIが返す文書構造を区別する
Google Cloudの公式資料は、複数の文書処理機能を説明しています。Enterprise Document OCRは、文字、行、単語、段落などのテキストと配置情報を抽出します。スキャンしたマニュアルを検索可能にする処理などで利用できる出力です。
Document AIのLayout Parserでは、PDFの見出し、表、リスト、図などの要素を識別し、文書の階層を構造として返す機能が説明されています。検索用に小さな単位へ分割する際には、その単位に対応する上位の見出しを付加することもできます。こうした文脈付きの単位がチャンクです。
設備文書を集めて検索する場合、節の見出しと段落の関係を残したチャンクを利用できます。特許明細書はブロックと関係を数値表現として処理する考え方を示し、製品資料は文書構造や見出しの文脈を保った出力の利用方法を説明しています。両者は区別して読む必要があります。
文字の精度に加え、要素間の対応も評価する
評価では、まず出力をどの業務に使うかを定めます。見出しと手順の関係が重要なら、文字を正しく認識したかだけでなく、手順が適切な見出しの下に置かれているかを確認します。図も表示する場合には、説明が対応する図に結び付いているかも重要です。
比較する文書も具体的に選びます。同じ文章が異なる見出しの下に現れるマニュアル、二段組みのページ、写真と説明が離れている文書などが候補です。入力で残した配置情報、中間段階のブロック、検索結果に添えられる根拠を順に記録すると、誤りの箇所を追いやすくなります。
技術説明でも、文字の読み取り、ブロックの形成、関係の処理、最終的な業務利用を分けて整理すると有用です。どの情報をどの段階で加え、次の計算へどう渡すかを明らかにするほど、文書処理方式の相違を具体的に説明できます。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
点検マニュアルは説明用の架空例です。本稿の技術概要は請求項全体の要約ではありません。請求項1には画像候補の提案と、別文書の画像への置換を判定する予測に基づく学習条件も含まれ、請求項14・19は学習システム・記録媒体の構成を規定しています。製品資料だけを根拠に、Document AIが特許の全構成を実施しているとは断定しません。
Google Cloud Layout Parser公式資料
Google Cloud Enterprise Document OCR公式資料
ネイバーの画像翻訳特許を読む―動くカメラ映像に訳文を重ねる仕組み
モデル回答と検索知識が食い違うとき――BaiduのRAG処理を読む
文書処理の仕組みと技術的な相違を特許の観点から整理する際は、IPLEXのAI分野の取り組みと相談準備資料をご覧ください。