
Публикация и техническая задача
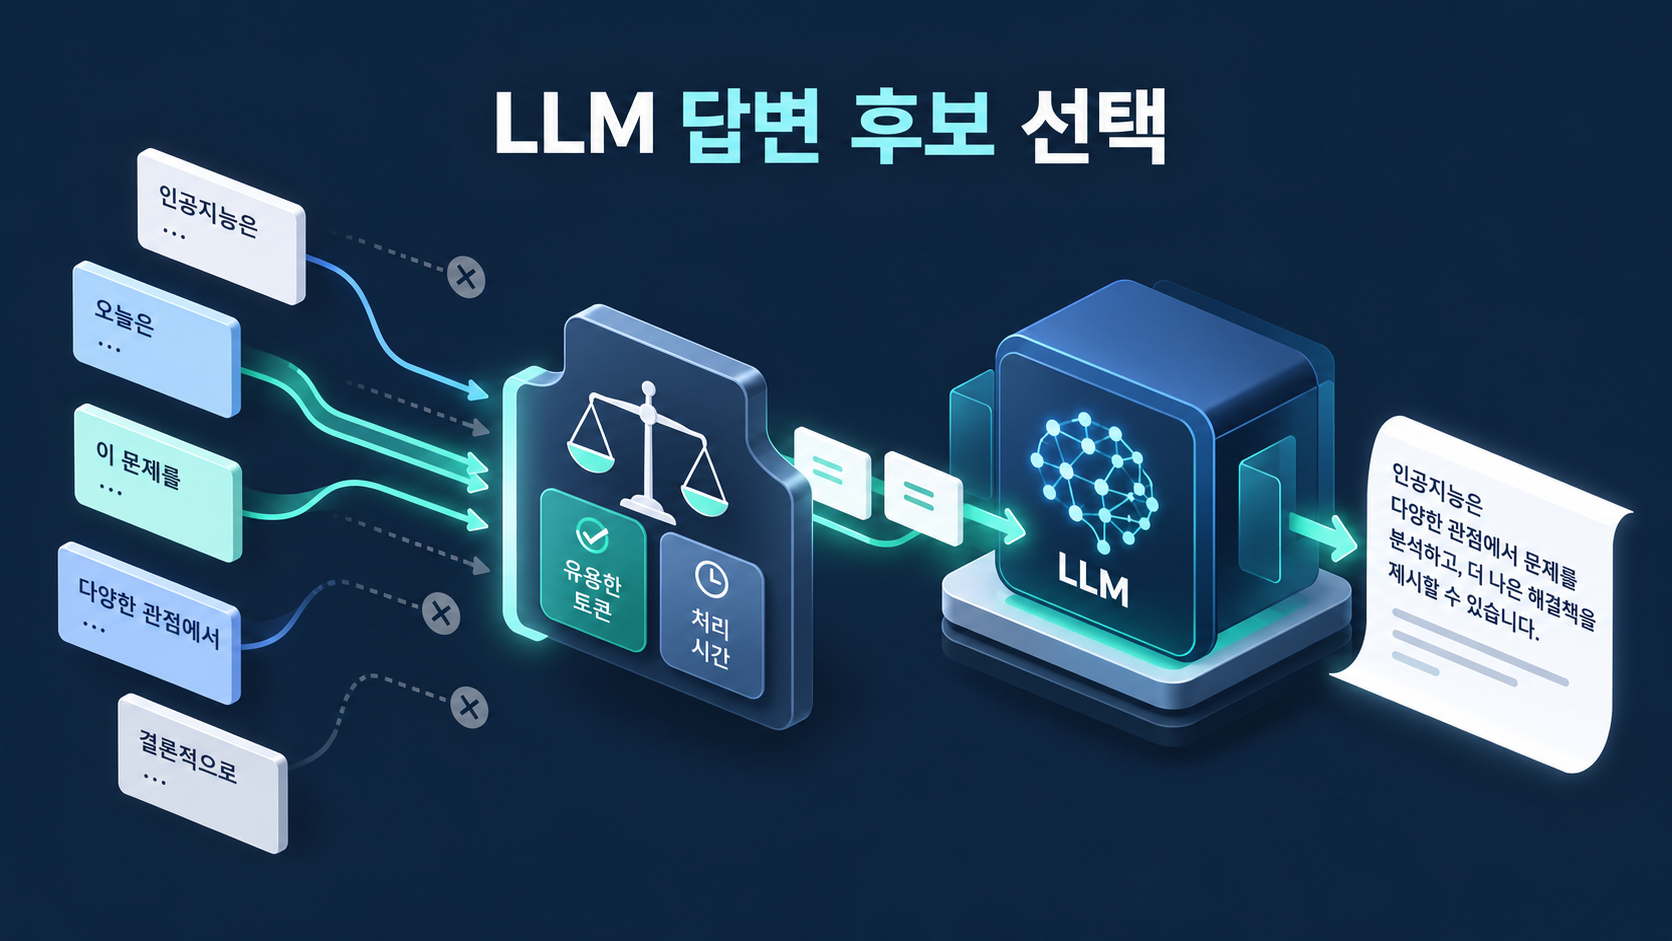
US20260236763A1 компании NVIDIA опубликована 13 августа 2026 года. Это публикация заявки, а не подтверждение выдачи патента. В ней описан выбор наборов черновых токенов по сведениям о времени обработки и числе принятых токенов. Анализ касается этого механизма и не утверждает, что NIM реализует все признаки формулы.
Языковая модель обычно последовательно добавляет очередной токен в контекст. Предварительная подготовка продолжений может сократить последовательную работу, если целевая модель принимает их. Длинные черновики, которые постоянно отбрасываются, напротив, расходуют время и память. Вопрос в том, какой объём опережающих вычислений оправдан.
Токены, черновики и целевая модель
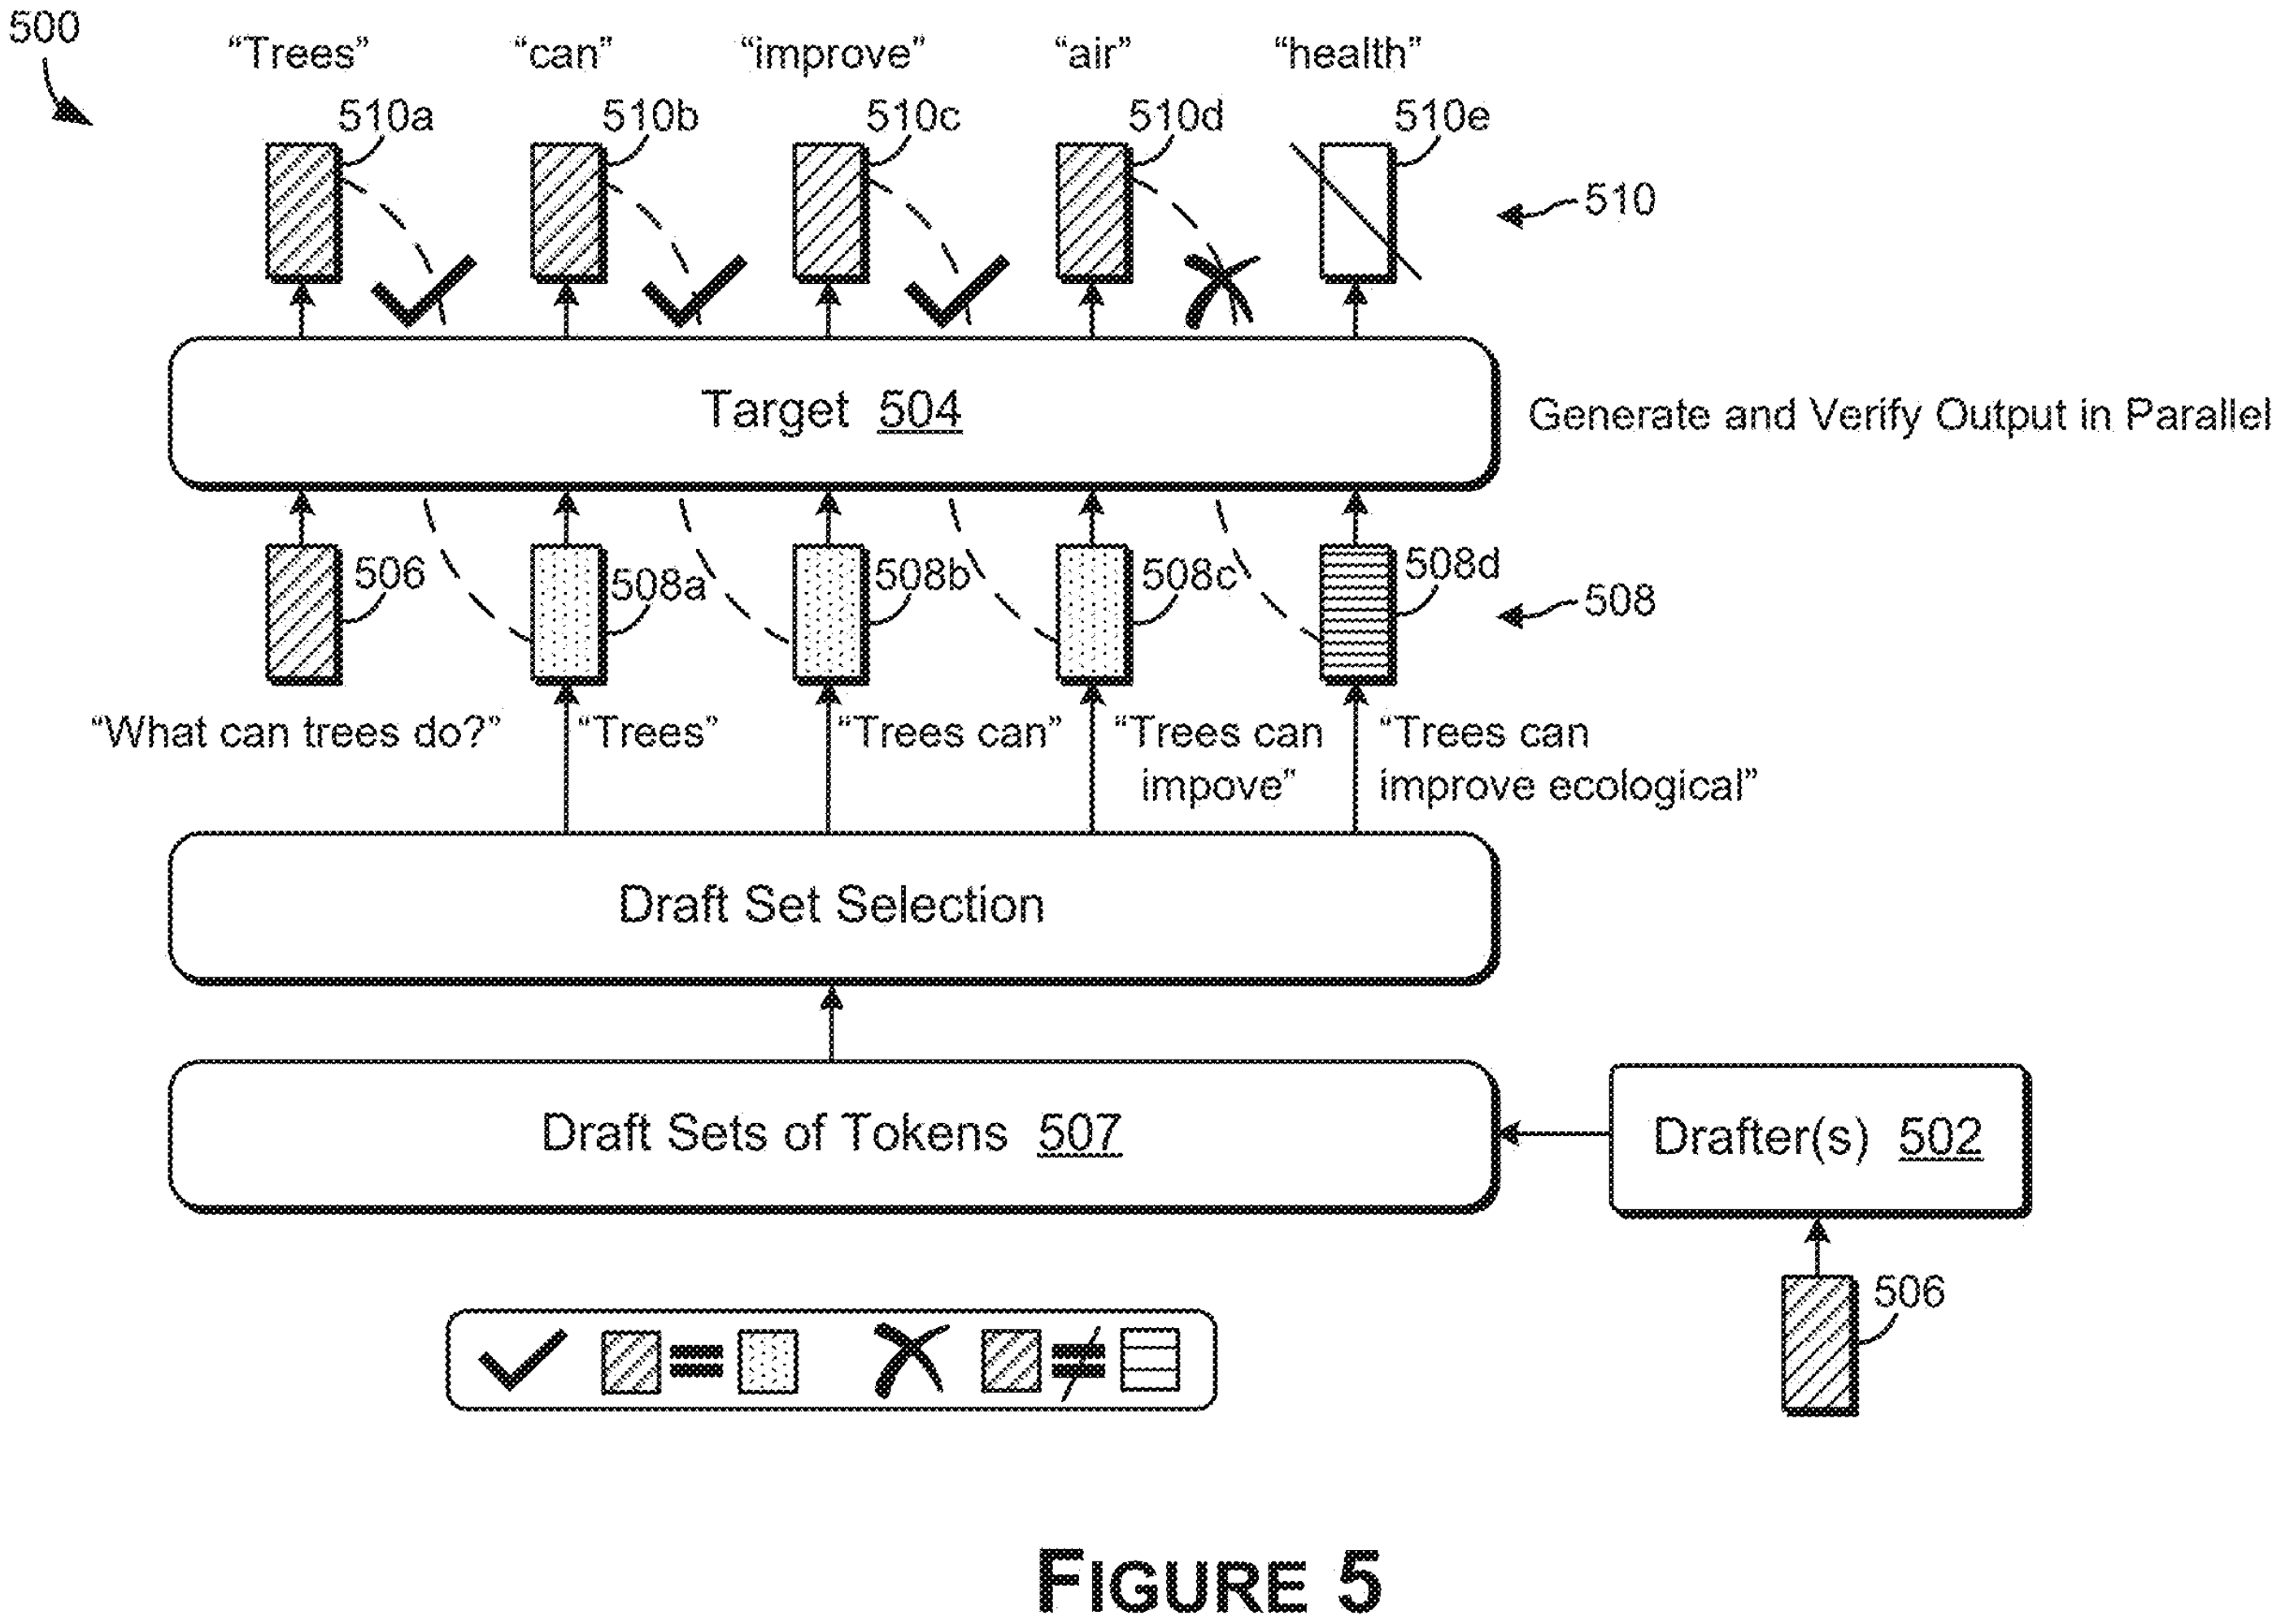
Токен может соответствовать слову, его части или знаку препинания. Генератор черновиков предлагает продолжения, а целевая модель совместно проверяет выбранные позиции. Генератором не обязательно служит отдельная малая модель: эту функцию может выполнять иной процесс или компонент той же модели.
Принятый начальный фрагмент добавляется в контекст, но расхождение в одной позиции не позволяет автоматически сохранить весь остаток. Фигура 5 показывает генерацию, отбор и параллельную проверку. Принятие относится к правилу генерации модели, а не к достоверности даты доставки или другого факта.
Почему длина кандидата не решает задачу
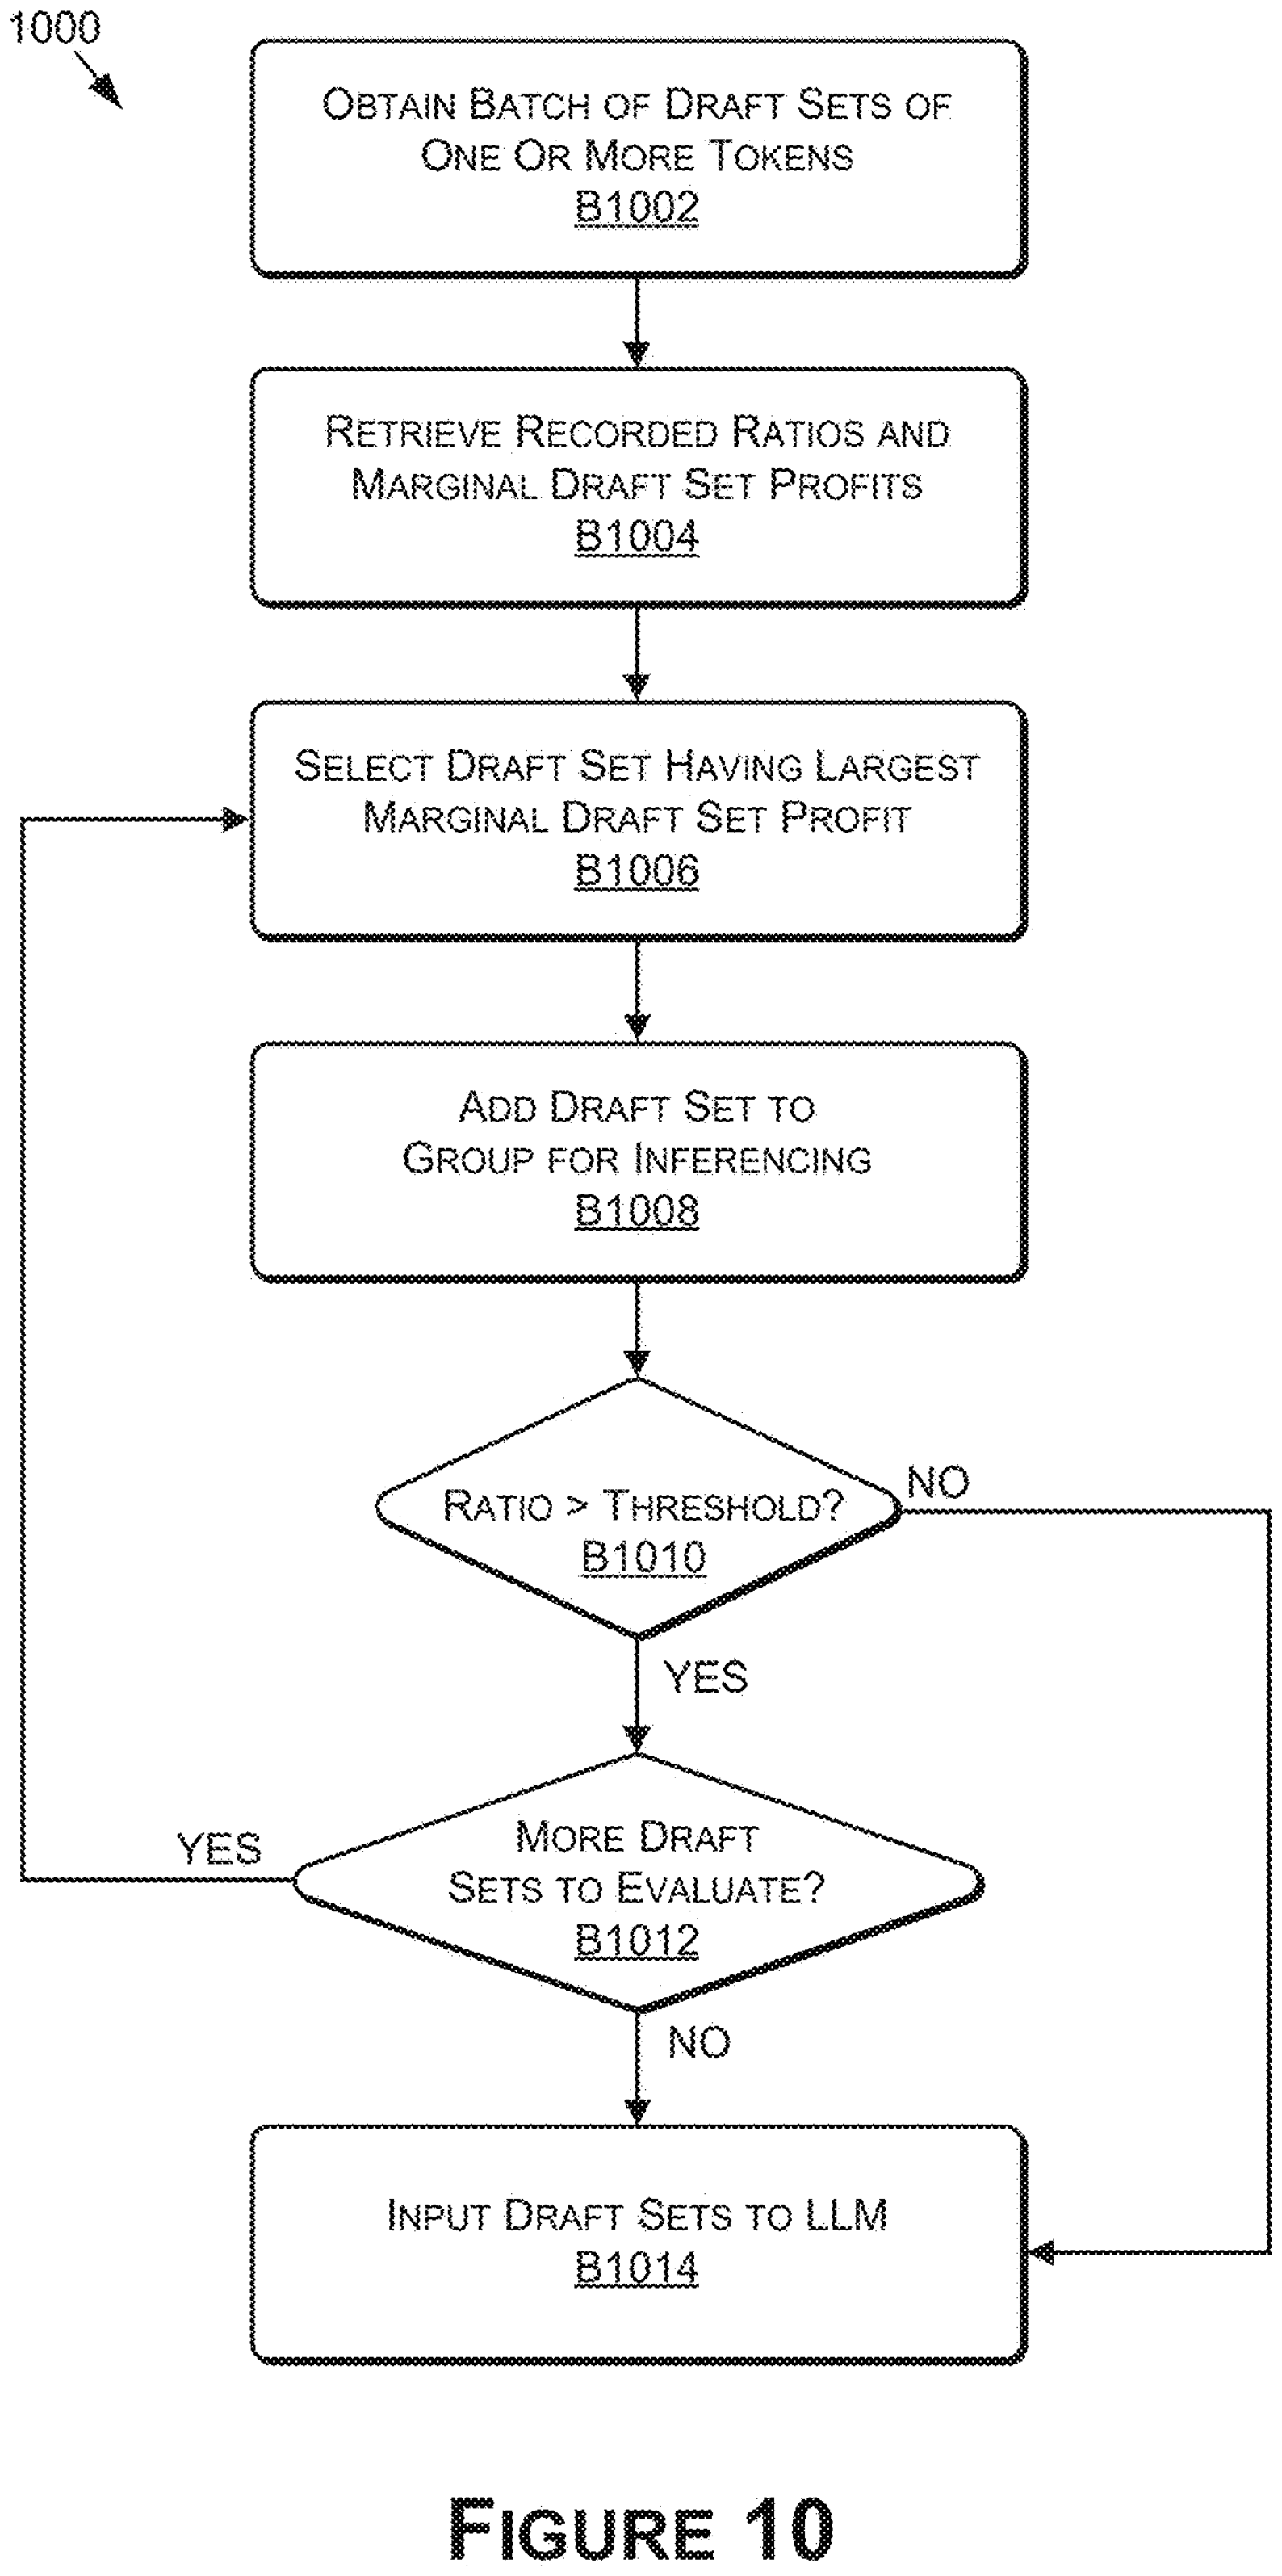
Селектор оценивает ожидаемый прирост принятых токенов при расширении кандидата и дополнительное время обработки. Под выгодой понимается прирост результата генерации, а не выручка. Для оценки используются прежние записи о принятии и длительности; одной общей длины недостаточно.
На фигуре 10 из оставшихся наборов выбирается имеющий наибольшую предельную выгоду и добавляется в группу для инференса. Затем отношение выгоды к дополнительным затратам сравнивается с порогом: при выполнении условия и наличии кандидатов выбор продолжается. Группа передаётся модели. Это не просто сортировка всех кандидатов по отношению и не выбор самого длинного; порог может учитывать вычислительные ресурсы и память.
Условная консультация о доставке
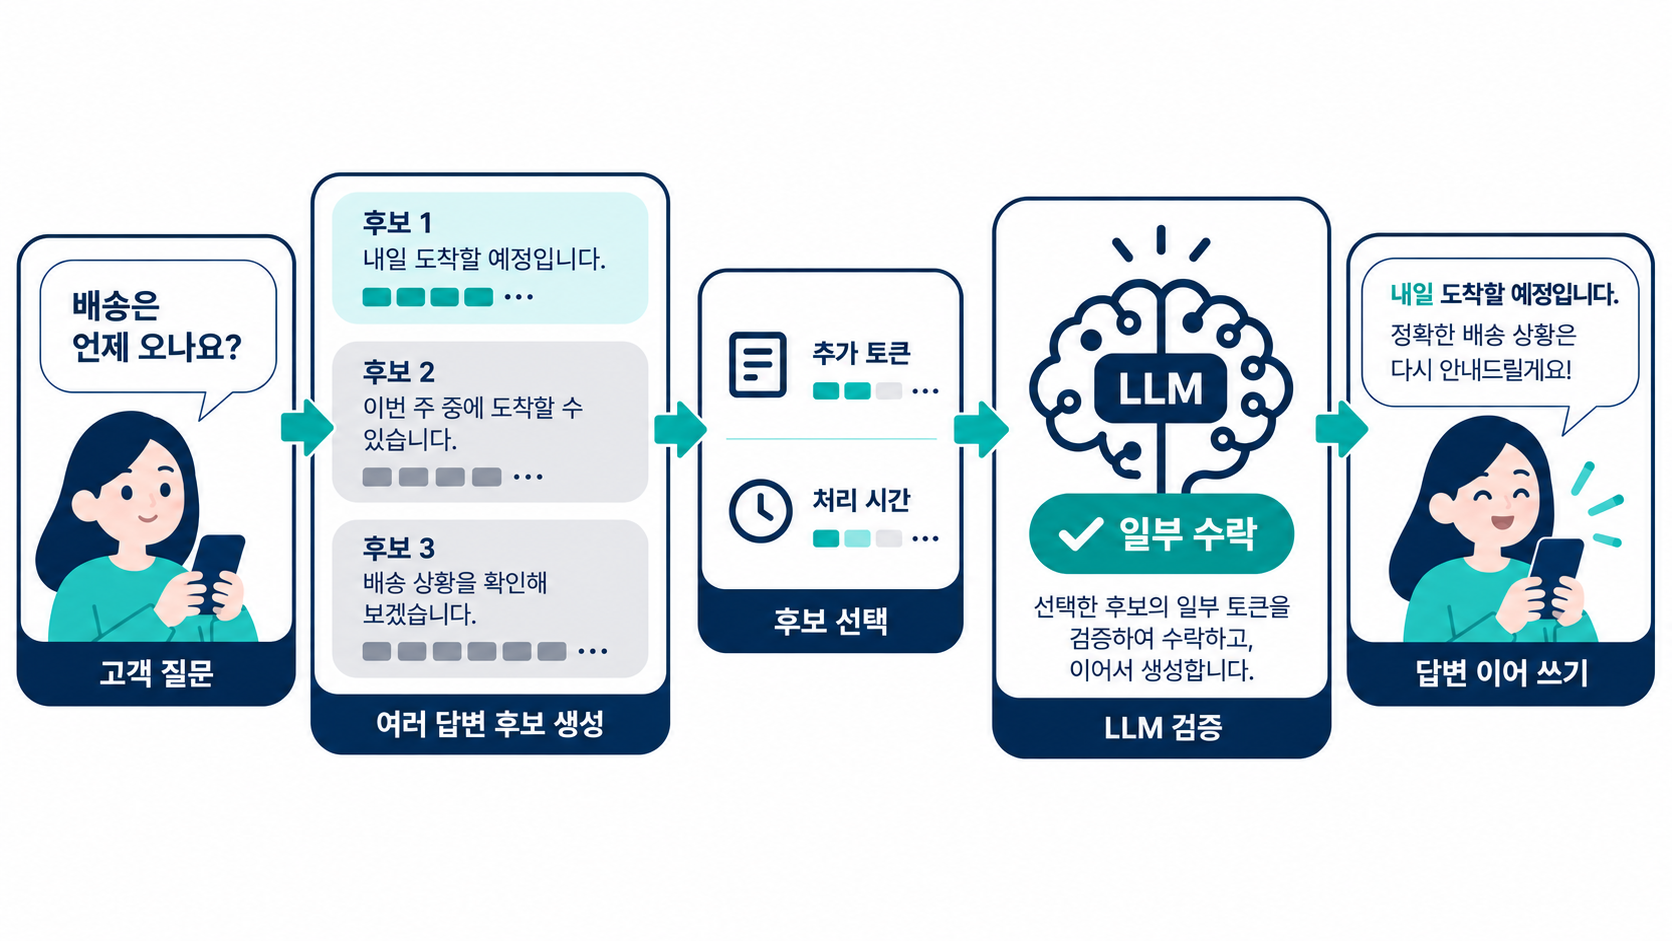
Представим продолжения «Ваш заказ», «Ваш заказ будет» и «Ваш заказ будет отправлен сегодня». Это удобные для чтения фрагменты, а не реальные границы токенов. Если принято лишь начало, неподходящий конец отбрасывается и генерация продолжается по результату целевой модели. Настоящий статус доставки должен поступать из данных заказа и бизнес-логики.
Время обработки и принятая длина записываются для следующего отбора. Часто отвергаемые окончания могут оправдывать короткие черновики; предсказуемый текст — более длинные. Обновление этих рабочих записей отличается от переобучения весов. Иллюстрация доставки является вымышленной, а не примером внедрения или измерением производительности.
Контекст продукта NVIDIA NIM
NVIDIA NIM предоставляет микросервисы инференса, вызываемые приложениями для запуска моделей. Документация NIM for Large Language Models 2.0.10 описывает спекулятивное декодирование с бэкендом vLLM: EAGLE3, встроенное предсказание нескольких токенов MTP и поиск повторяющихся n-грамм во входном контексте. Требования к моделям и памяти различаются.
Следует разделять способ получения черновика и объём чернового материала для проверки целевой моделью. Селектор из заявки помогает понять второй вопрос. Наличие спекулятивного декодирования в продукте само по себе не доказывает реализацию конкретных пунктов опубликованной формулы.
Задержка ответа и пропускная способность
Время ожидания одного ответа и общий объём обработки сервером — разные показатели. При низкой или умеренной параллельной нагрузке свободные ресурсы GPU могут сделать проверку черновиков полезной. При насыщении дополнительные вычисления и память способны устранить выигрыш или снизить пропускную способность. Несколько быстрых ответов не характеризуют весь сервис.
Измеряйте реальные длины запросов, параллельность, долю и длину принятого текста, использование памяти и время, сохраняя условия сравнения. Раздельное описание генерации, отбора и обратной связи помогает оценить техническое улучшение и сопоставить его с раскрытием заявки.
Что подготовить для обсуждения с IPLEX
Для патентного анализа ИИ и программного обеспечения полезны допустимая к раскрытию схема системы, правила генерации и отбора черновиков, а также временные сравнения с условиями измерения. Техническое отличие может заключаться в порядке и выборе вычислений, а не только в размере модели или оборудовании.
IPLEX рассматривает такие конкретные различия при подготовке заявок и стратегии охраны. Этот материал не устанавливает нарушение, выдачу патента или гарантированное ускорение. Реализация и применимые пункты формулы требуют самостоятельного анализа.
По теме: обновление весов во время тестирования
По теме: анализ Attention Residuals