
La publicación y la pregunta técnica
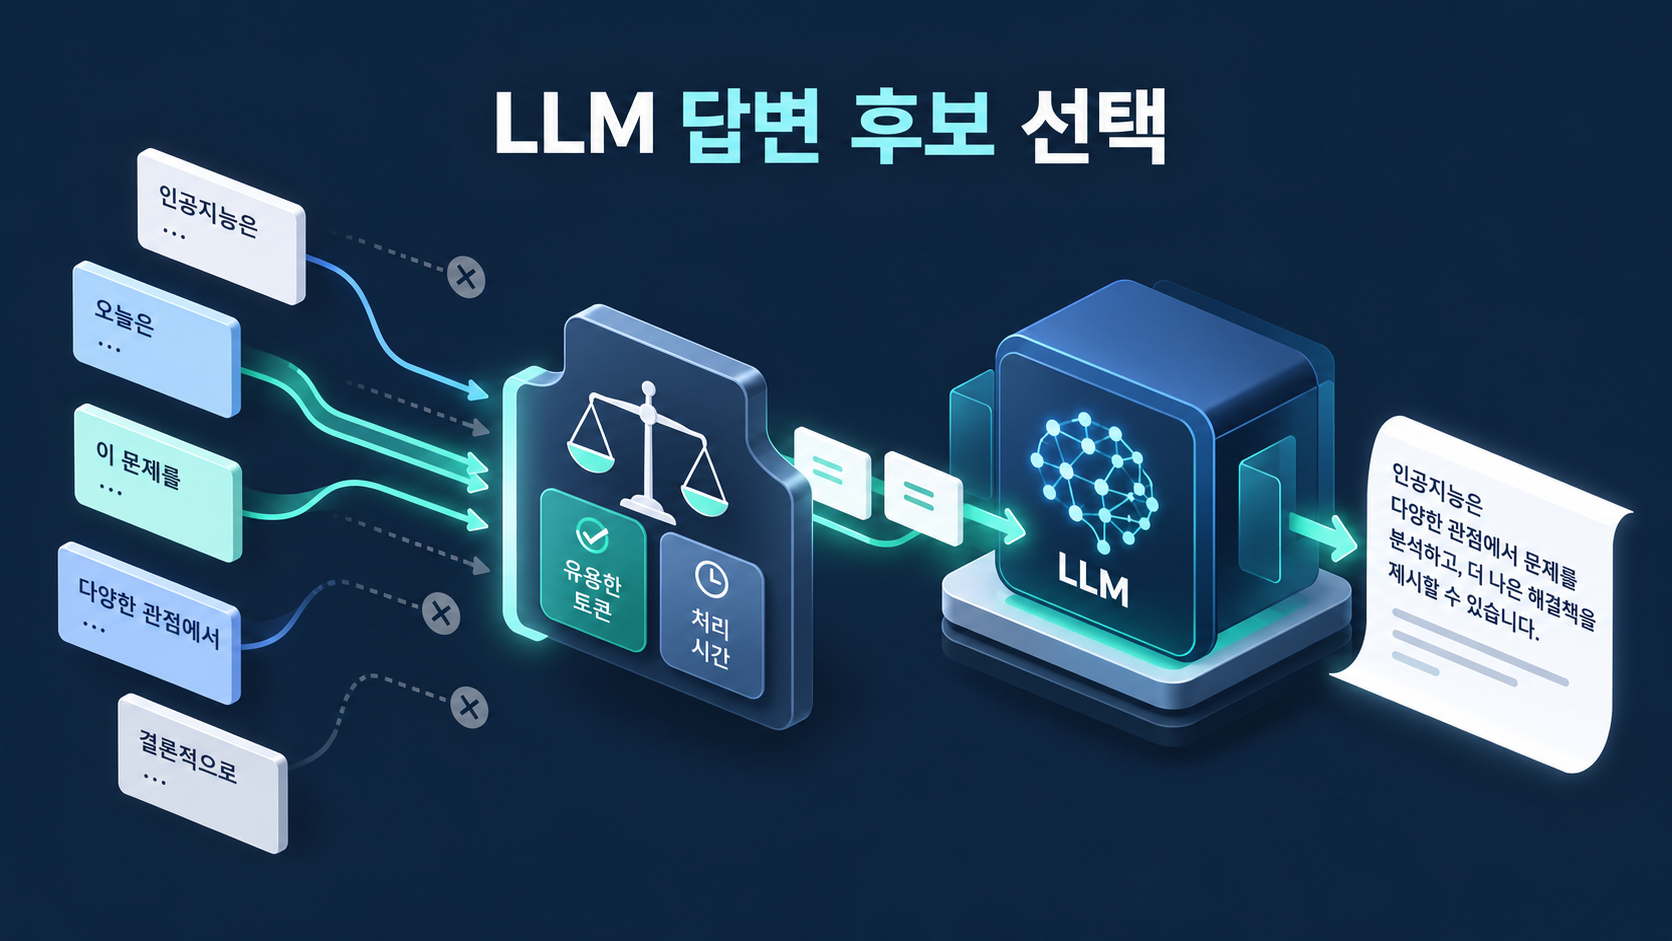
US20260236763A1, de NVIDIA, se publicó el 13 de agosto de 2026. Es una solicitud publicada, no prueba de una patente concedida. Describe la selección de conjuntos de tokens preliminares utilizando tiempos de procesamiento y cantidades aceptadas. Aquí se estudia ese mecanismo sin afirmar que NIM implemente todas sus reivindicaciones.
Un modelo de lenguaje suele añadir sucesivamente el siguiente token al contexto. Preparar continuaciones por adelantado puede reducir pasos secuenciales si el modelo objetivo las acepta. Los borradores largos que se descartan reiteradamente consumen tiempo y memoria. La cuestión es cuánto trabajo anticipado compensa realizar.
Tokens, borradores y modelo objetivo
Un token puede ser una palabra, un fragmento o un signo de puntuación. El generador preliminar propone continuaciones y el modelo objetivo verifica conjuntamente las posiciones seleccionadas. El generador no tiene que ser siempre un modelo pequeño independiente: puede ser otro proceso o una parte del mismo modelo.
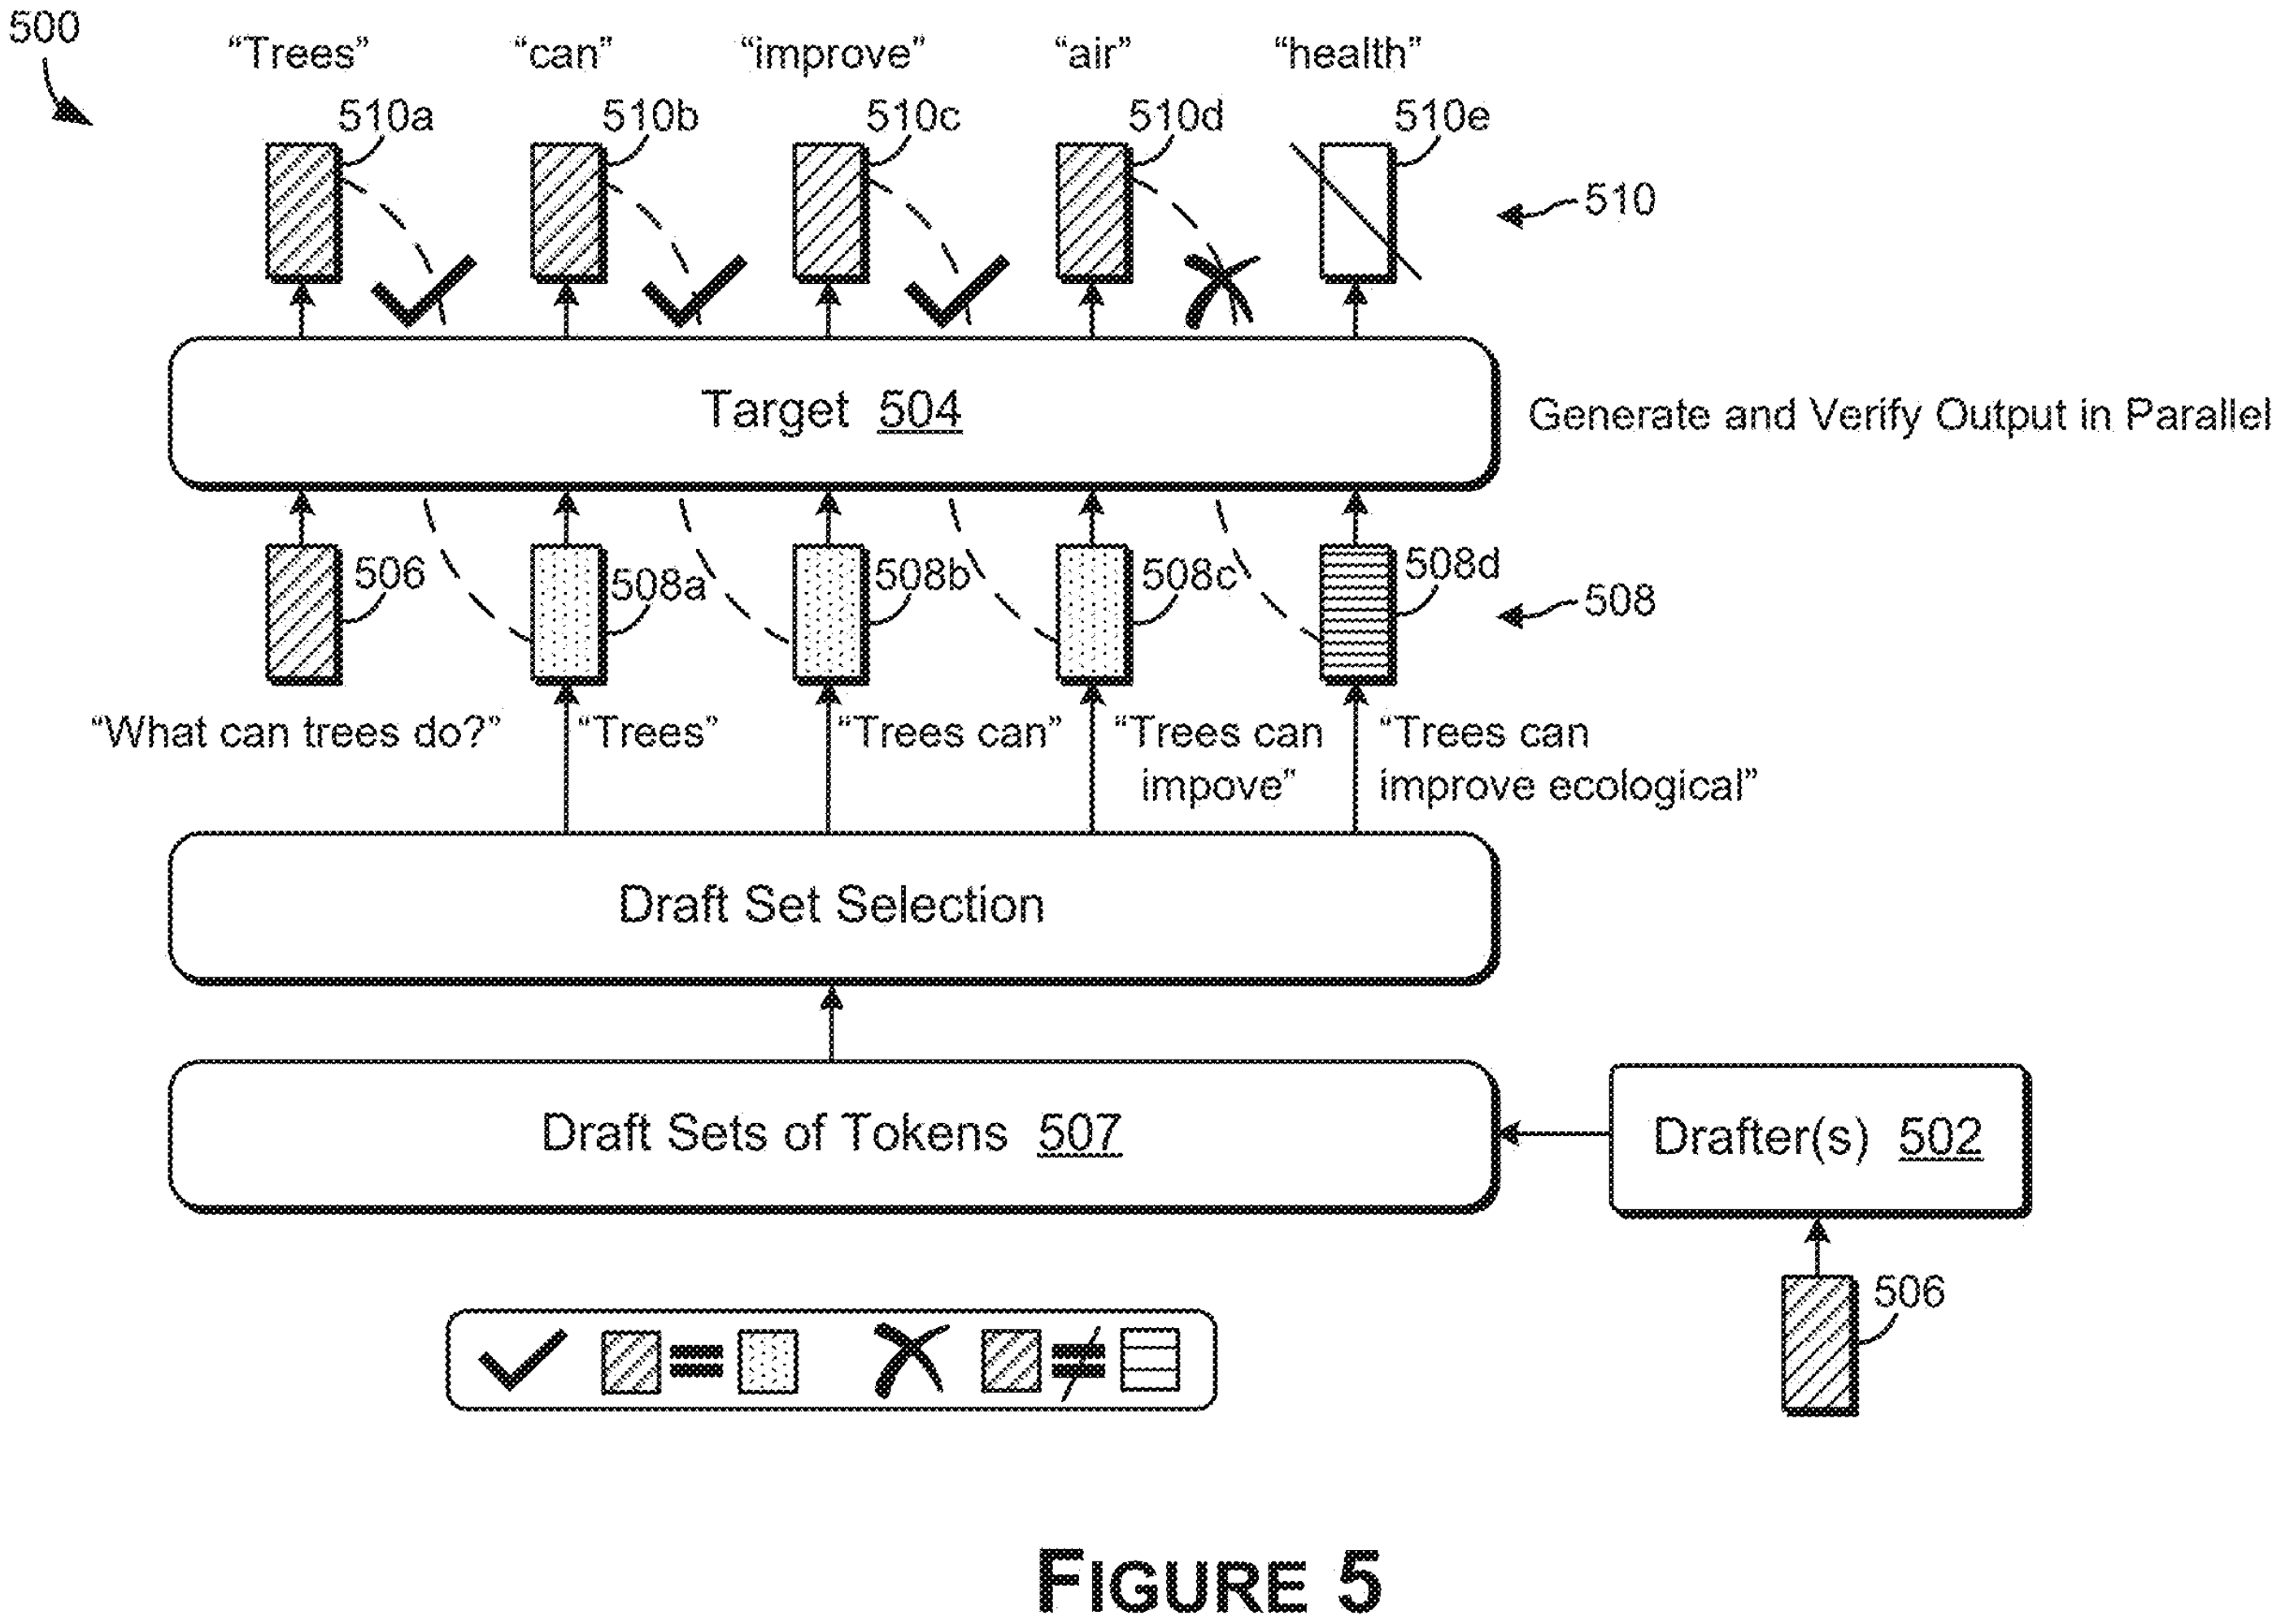
El prefijo aceptado se incorpora al contexto; una discrepancia no autoriza a conservar todo el resto del borrador. La figura 5 representa generación, selección y verificación paralela. Aceptar un token significa cumplir el criterio de generación del modelo, no confirmar la veracidad de una fecha de entrega u otro dato.
Por qué no basta elegir el borrador más largo
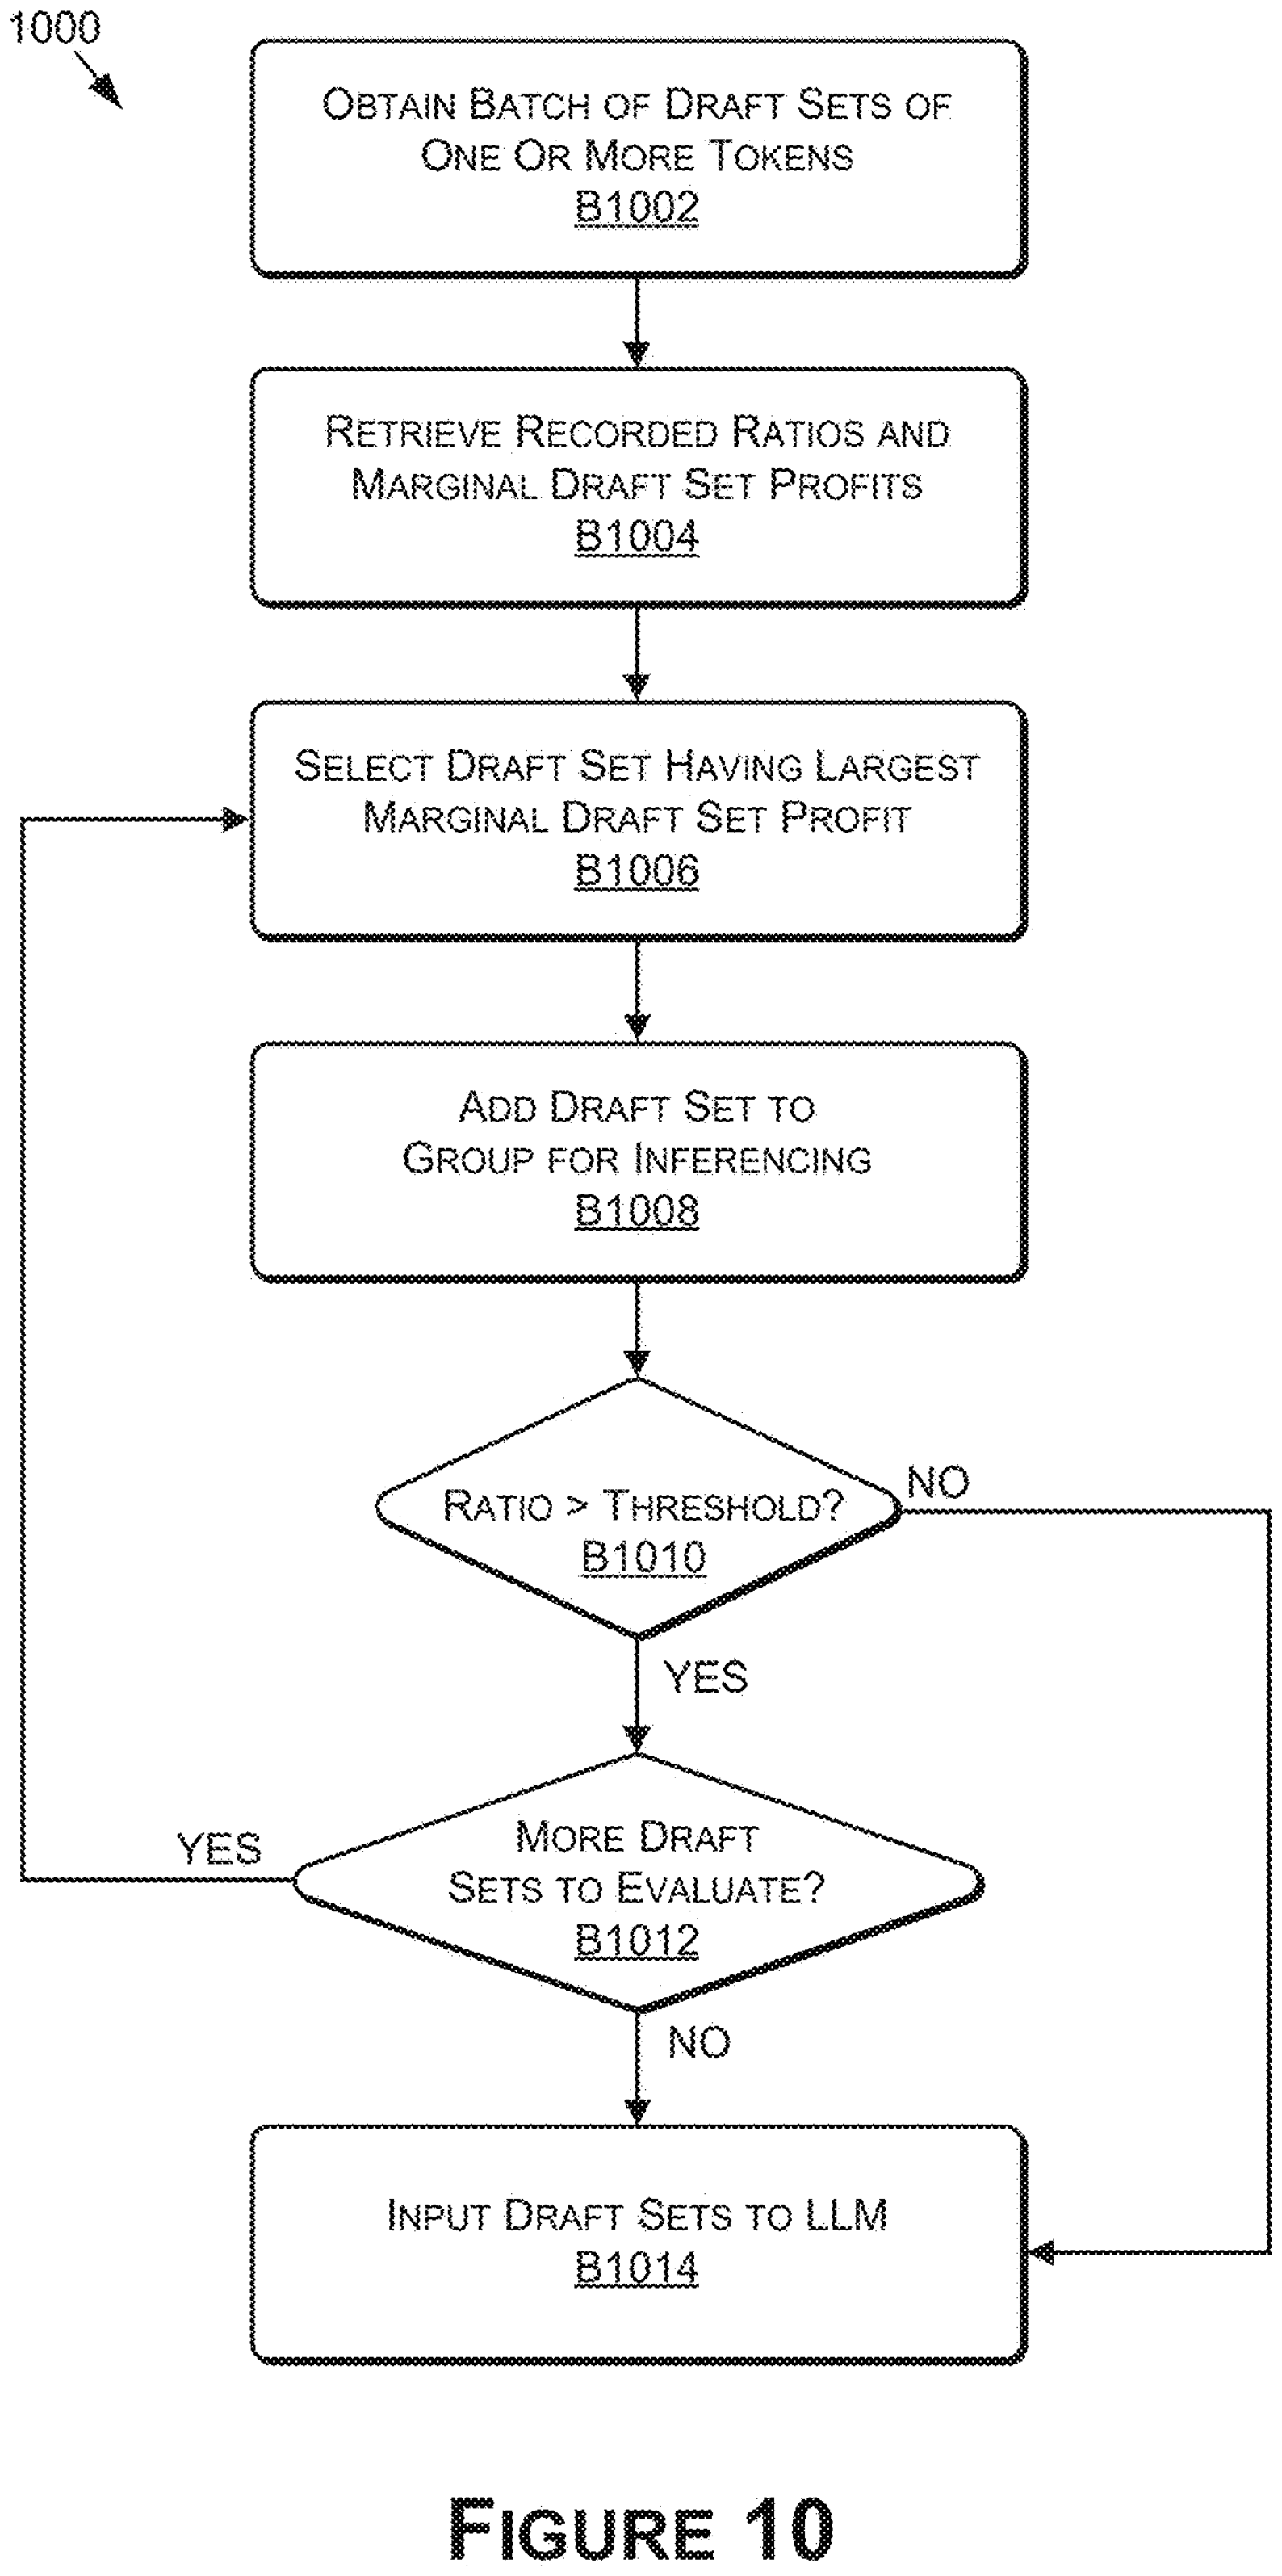
El selector considera el incremento esperado de tokens aceptados al ampliar un candidato y el tiempo adicional necesario. El beneficio es una ganancia de generación, no ingresos comerciales. Los registros anteriores de aceptación y tiempo permiten estimar ambas magnitudes; la longitud total no basta.
En la figura 10 se incorpora al grupo el conjunto restante con mayor beneficio marginal. Después se compara su relación entre beneficio y coste marginal con un umbral para decidir si continúa la selección, siempre que queden candidatos. El grupo resultante se envía al modelo. No equivale a ordenar todos los borradores por su cociente ni a elegir siempre el más largo; el umbral puede considerar recursos y memoria.
Una consulta de entrega hipotética
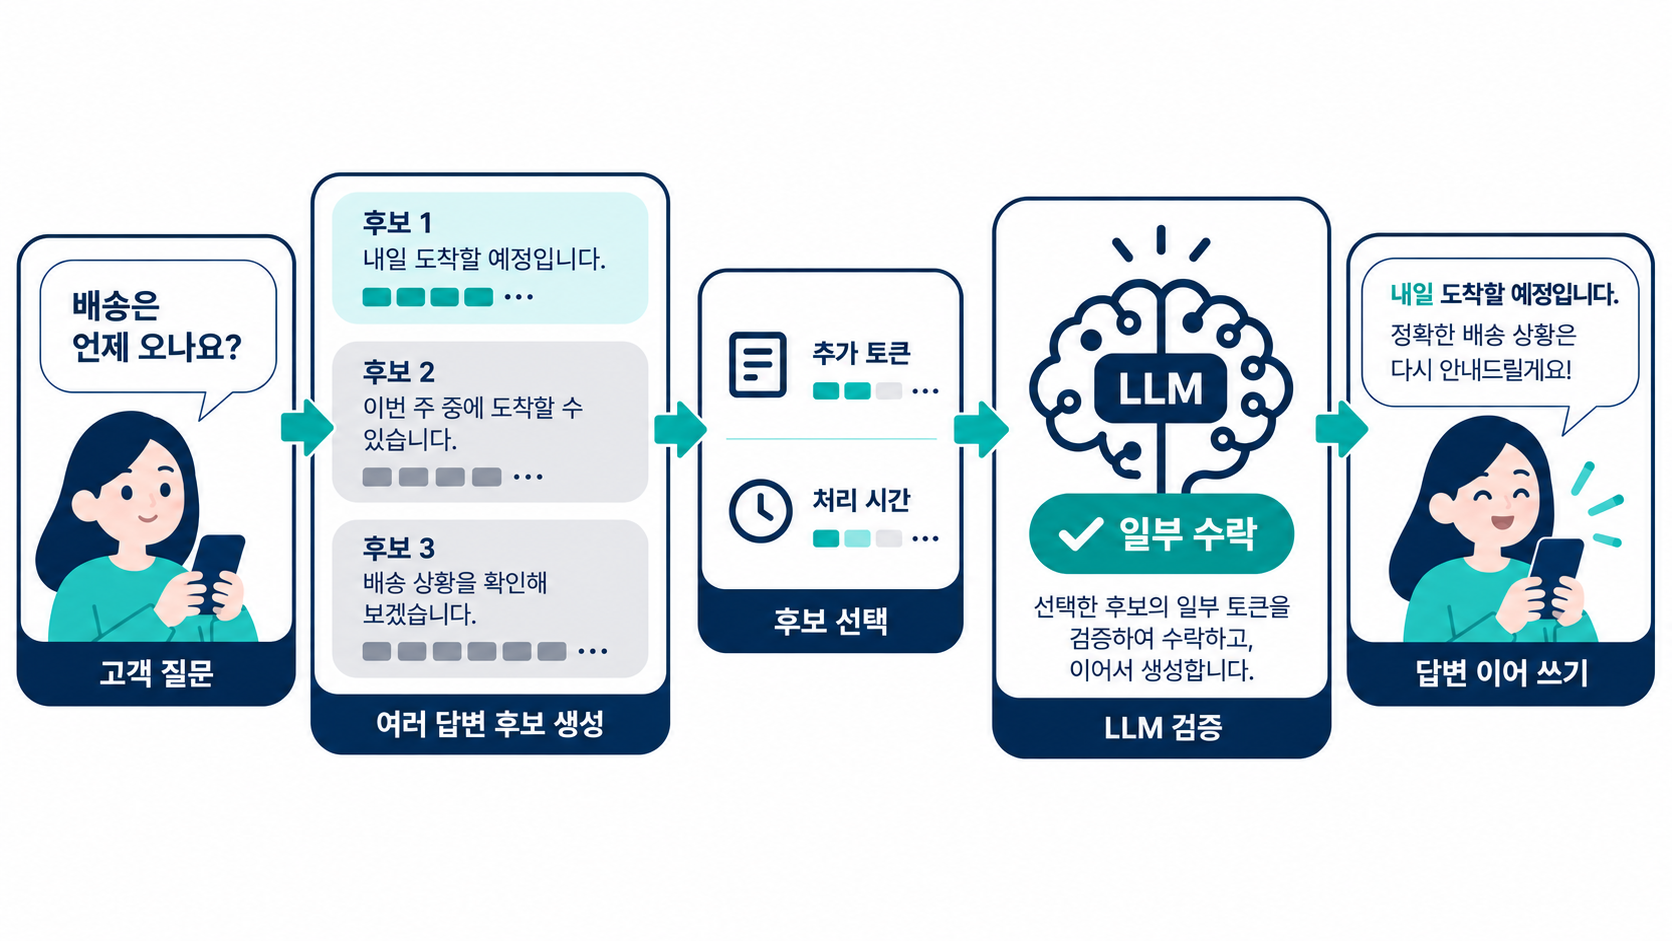
Imagine candidatos que amplían «Su pedido» a «Su pedido se enviará» y «Su pedido se enviará hoy». Son fragmentos legibles para ilustrar el proceso, no divisiones reales en tokens. Si el modelo solo acepta el inicio, descarta el final propuesto y continúa con su propio resultado. Los datos logísticos reales deben obtenerse de los sistemas del servicio.
Se registran tiempo y longitud aceptada para orientar la siguiente selección. Los finales rechazados con frecuencia pueden favorecer borradores cortos; un lenguaje previsible puede justificar otros más largos. Actualizar estos registros de ejecución no es reentrenar los pesos. La ilustración no representa una implantación comercial ni una medición de rendimiento.
NIM como contexto de producto
NVIDIA NIM ofrece microservicios de inferencia que las aplicaciones pueden invocar. La documentación de NIM for Large Language Models 2.0.10 describe decodificación especulativa en su backend vLLM, con EAGLE3, predicción de múltiples tokens integrada —MTP— y búsqueda de secuencias n-gram en la entrada. Sus requisitos de modelo y memoria difieren.
Conviene separar cómo se genera un borrador de cuánto contenido preliminar debe procesar el modelo objetivo. El selector de la solicitud ayuda a entender la segunda cuestión. Que un producto incorpore decodificación especulativa no demuestra, por sí solo, la implementación de estas reivindicaciones concretas.
Latencia y capacidad total del servicio
La espera de una respuesta y el volumen total procesado por el servidor son métricas distintas. Con capacidad de GPU disponible y concurrencia baja o moderada, la verificación paralela puede ser útil. En saturación, el trabajo y la memoria adicionales pueden anular la mejora o reducir el rendimiento global. Unos pocos ejemplos rápidos no bastan.
Mida longitudes reales de entrada y salida, concurrencia, tasas y longitudes de aceptación, memoria y tiempos, conservando las condiciones de comparación. Diferenciar generación, selección y realimentación facilita evaluar la mejora técnica y contrastarla con lo divulgado.
Preparar una consulta técnica con IPLEX
Para examinar patentes de IA o software, organice el flujo del sistema que pueda compartir, las reglas para generar y seleccionar borradores y las comparaciones temporales con sus condiciones. La diferencia técnica puede residir en el orden y la selección de cálculos, además del modelo y del hardware.
IPLEX estudia esas diferencias para preparar solicitudes y estrategias de protección. Este análisis no determina infracción, concesión ni una aceleración garantizada; la implementación y las reivindicaciones pertinentes requieren un examen específico.
Análisis relacionado: actualizar pesos durante la prueba
Análisis relacionado: Attention Residuals