
公开申请及其技术问题
NVIDIA的US20260236763A1于2026年8月13日公开,是专利申请公开文件,并非专利已获授权的证明。其说明根据处理时间及已接受词元数量选择草稿集合的技术。本篇聚焦该选择机制,不据此断言NIM实现了全部权利要求。
语言模型通常逐步计算下一个词元并加入上下文。预先准备多个续写候选,若目标模型接受,就可能减少串行步骤;但长候选反复被丢弃,也会浪费时间和内存。因此,问题在于值得提前计算多少内容。
词元、草稿与目标模型
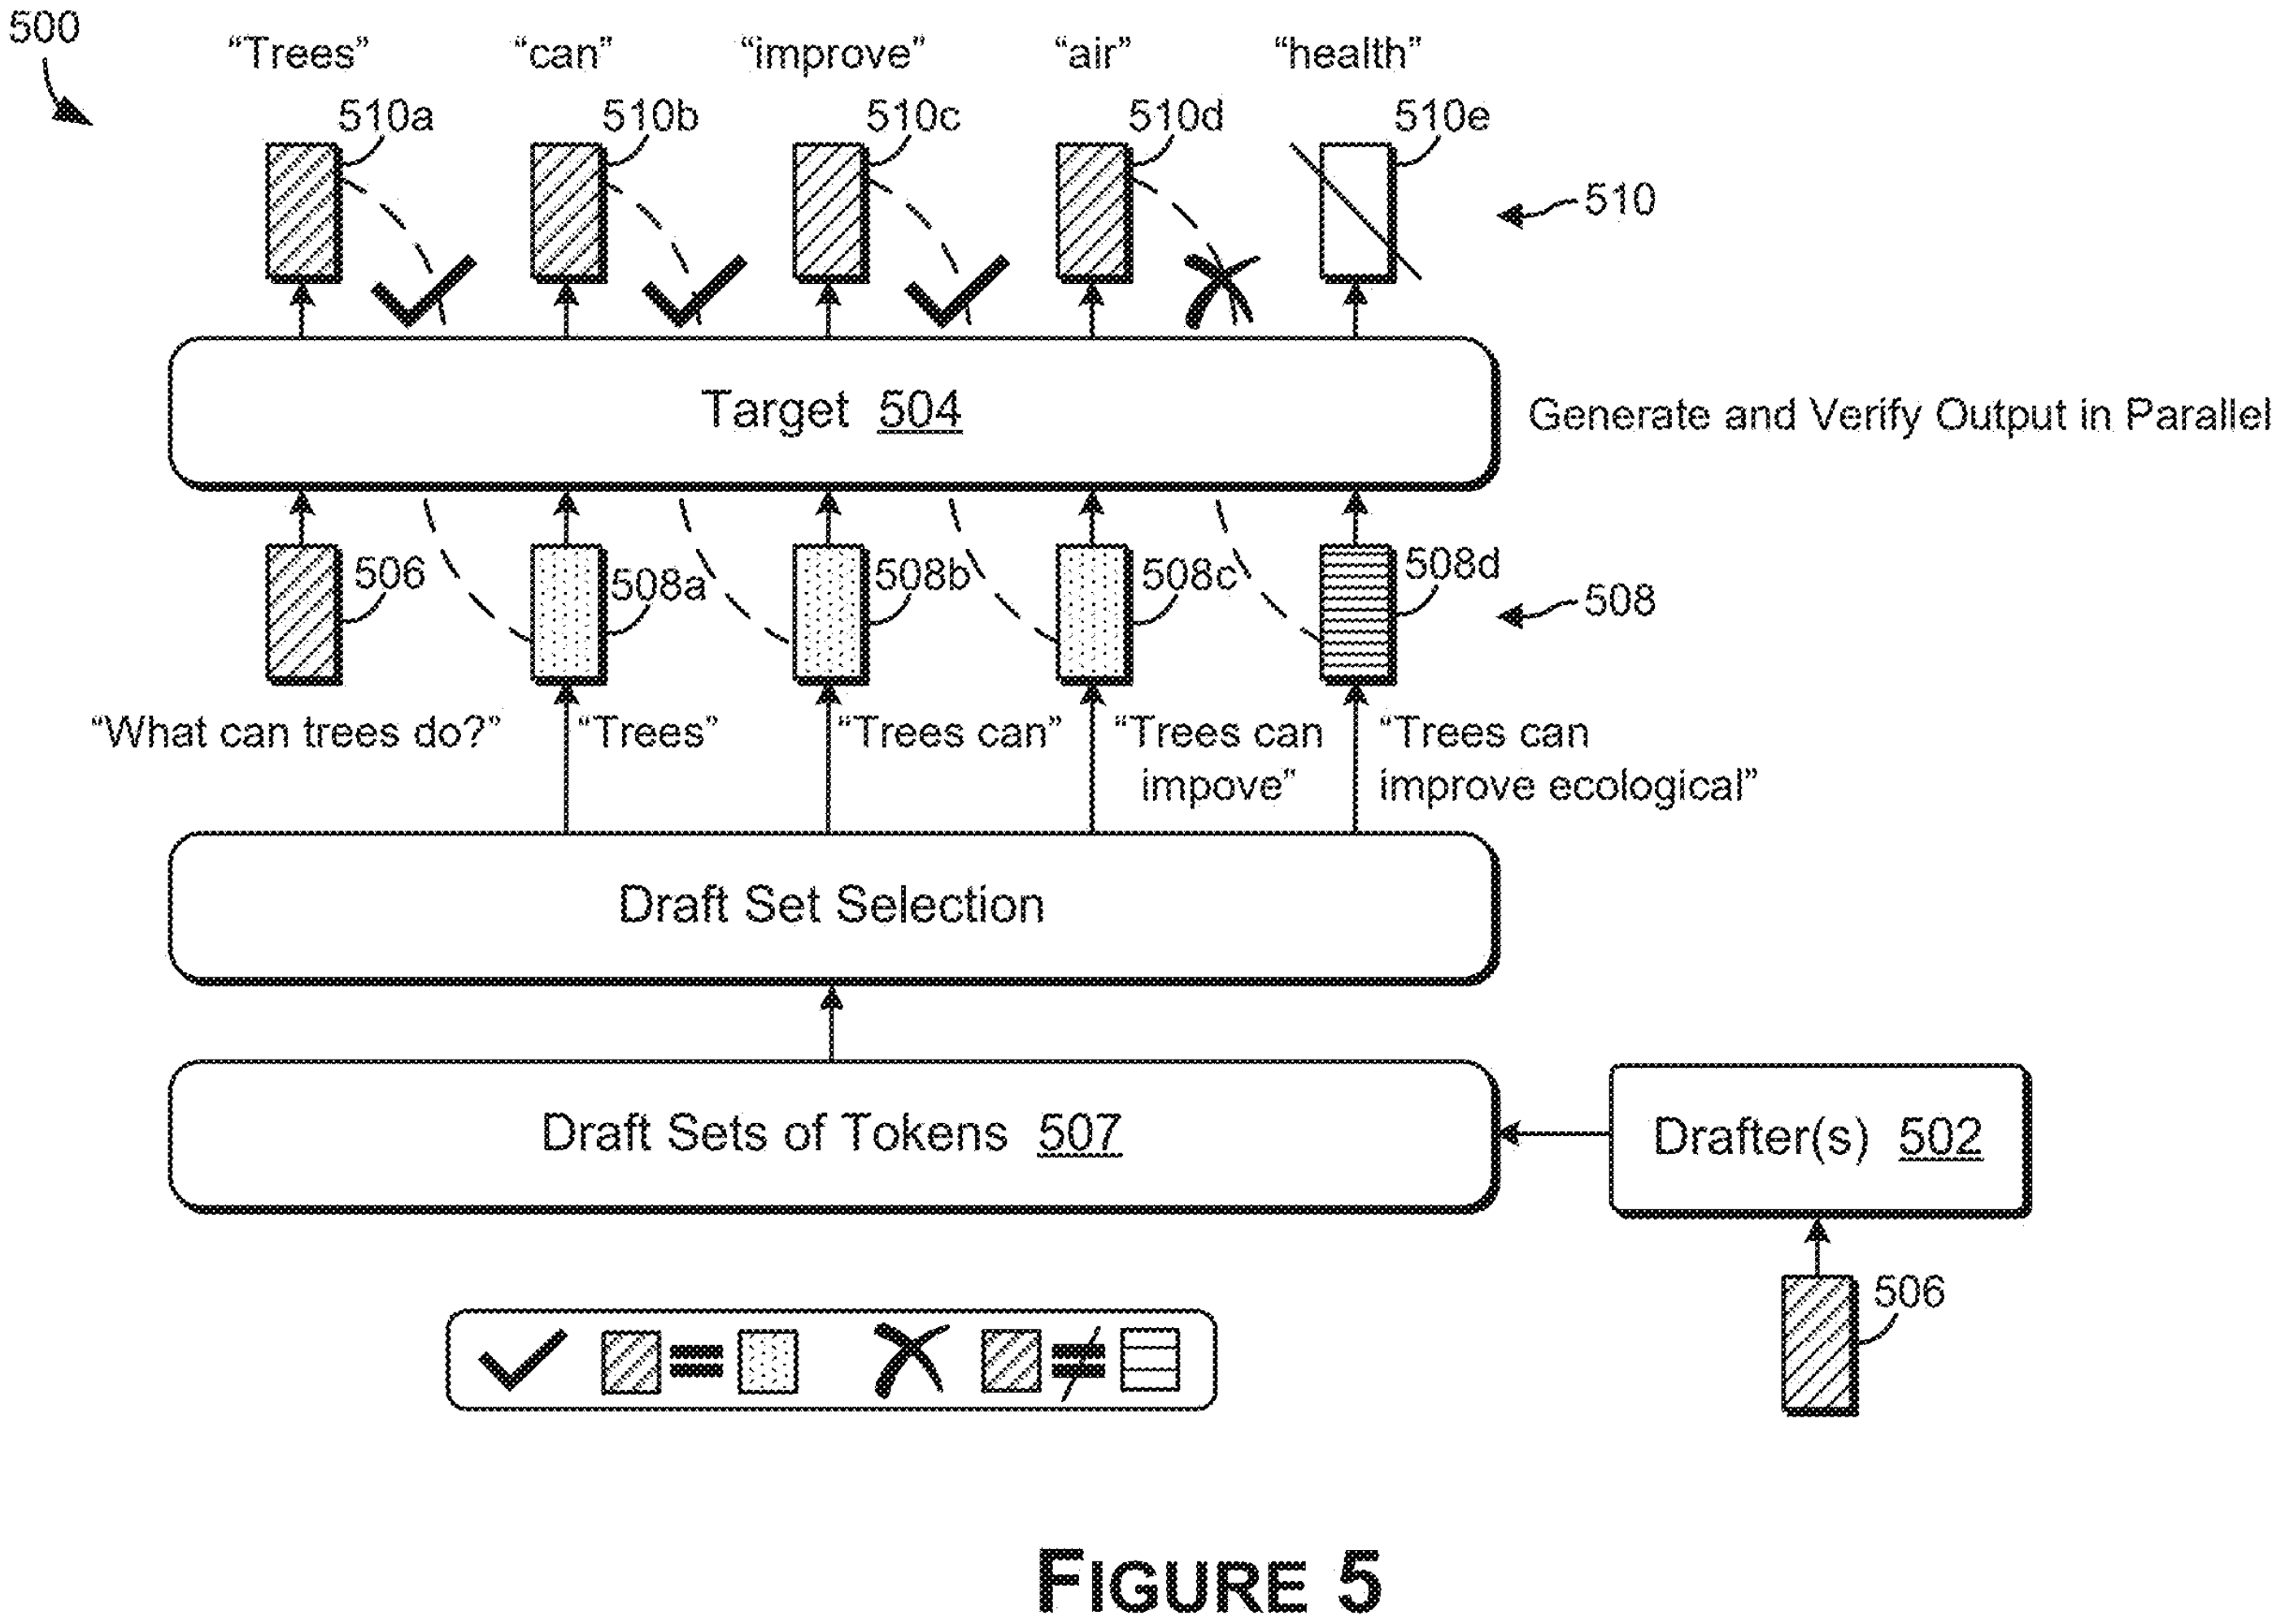
词元可能对应完整单词、词的一部分或标点,并不总与可见文字单位一致。草稿生成器提出续写,目标模型对选中的候选位置进行批量验证。草稿生成器不一定是独立的小模型,也可以是其他处理过程或同一模型内的组成部分。
可接受的连续前缀被加入下一轮上下文;中途不一致后,不能将其余候选直接沿用。图5展示生成、选择及并行验证的流程。接受候选仅意味着符合模型生成规则,不意味着配送日期等陈述已经过事实核验。
候选越长并不一定越有效
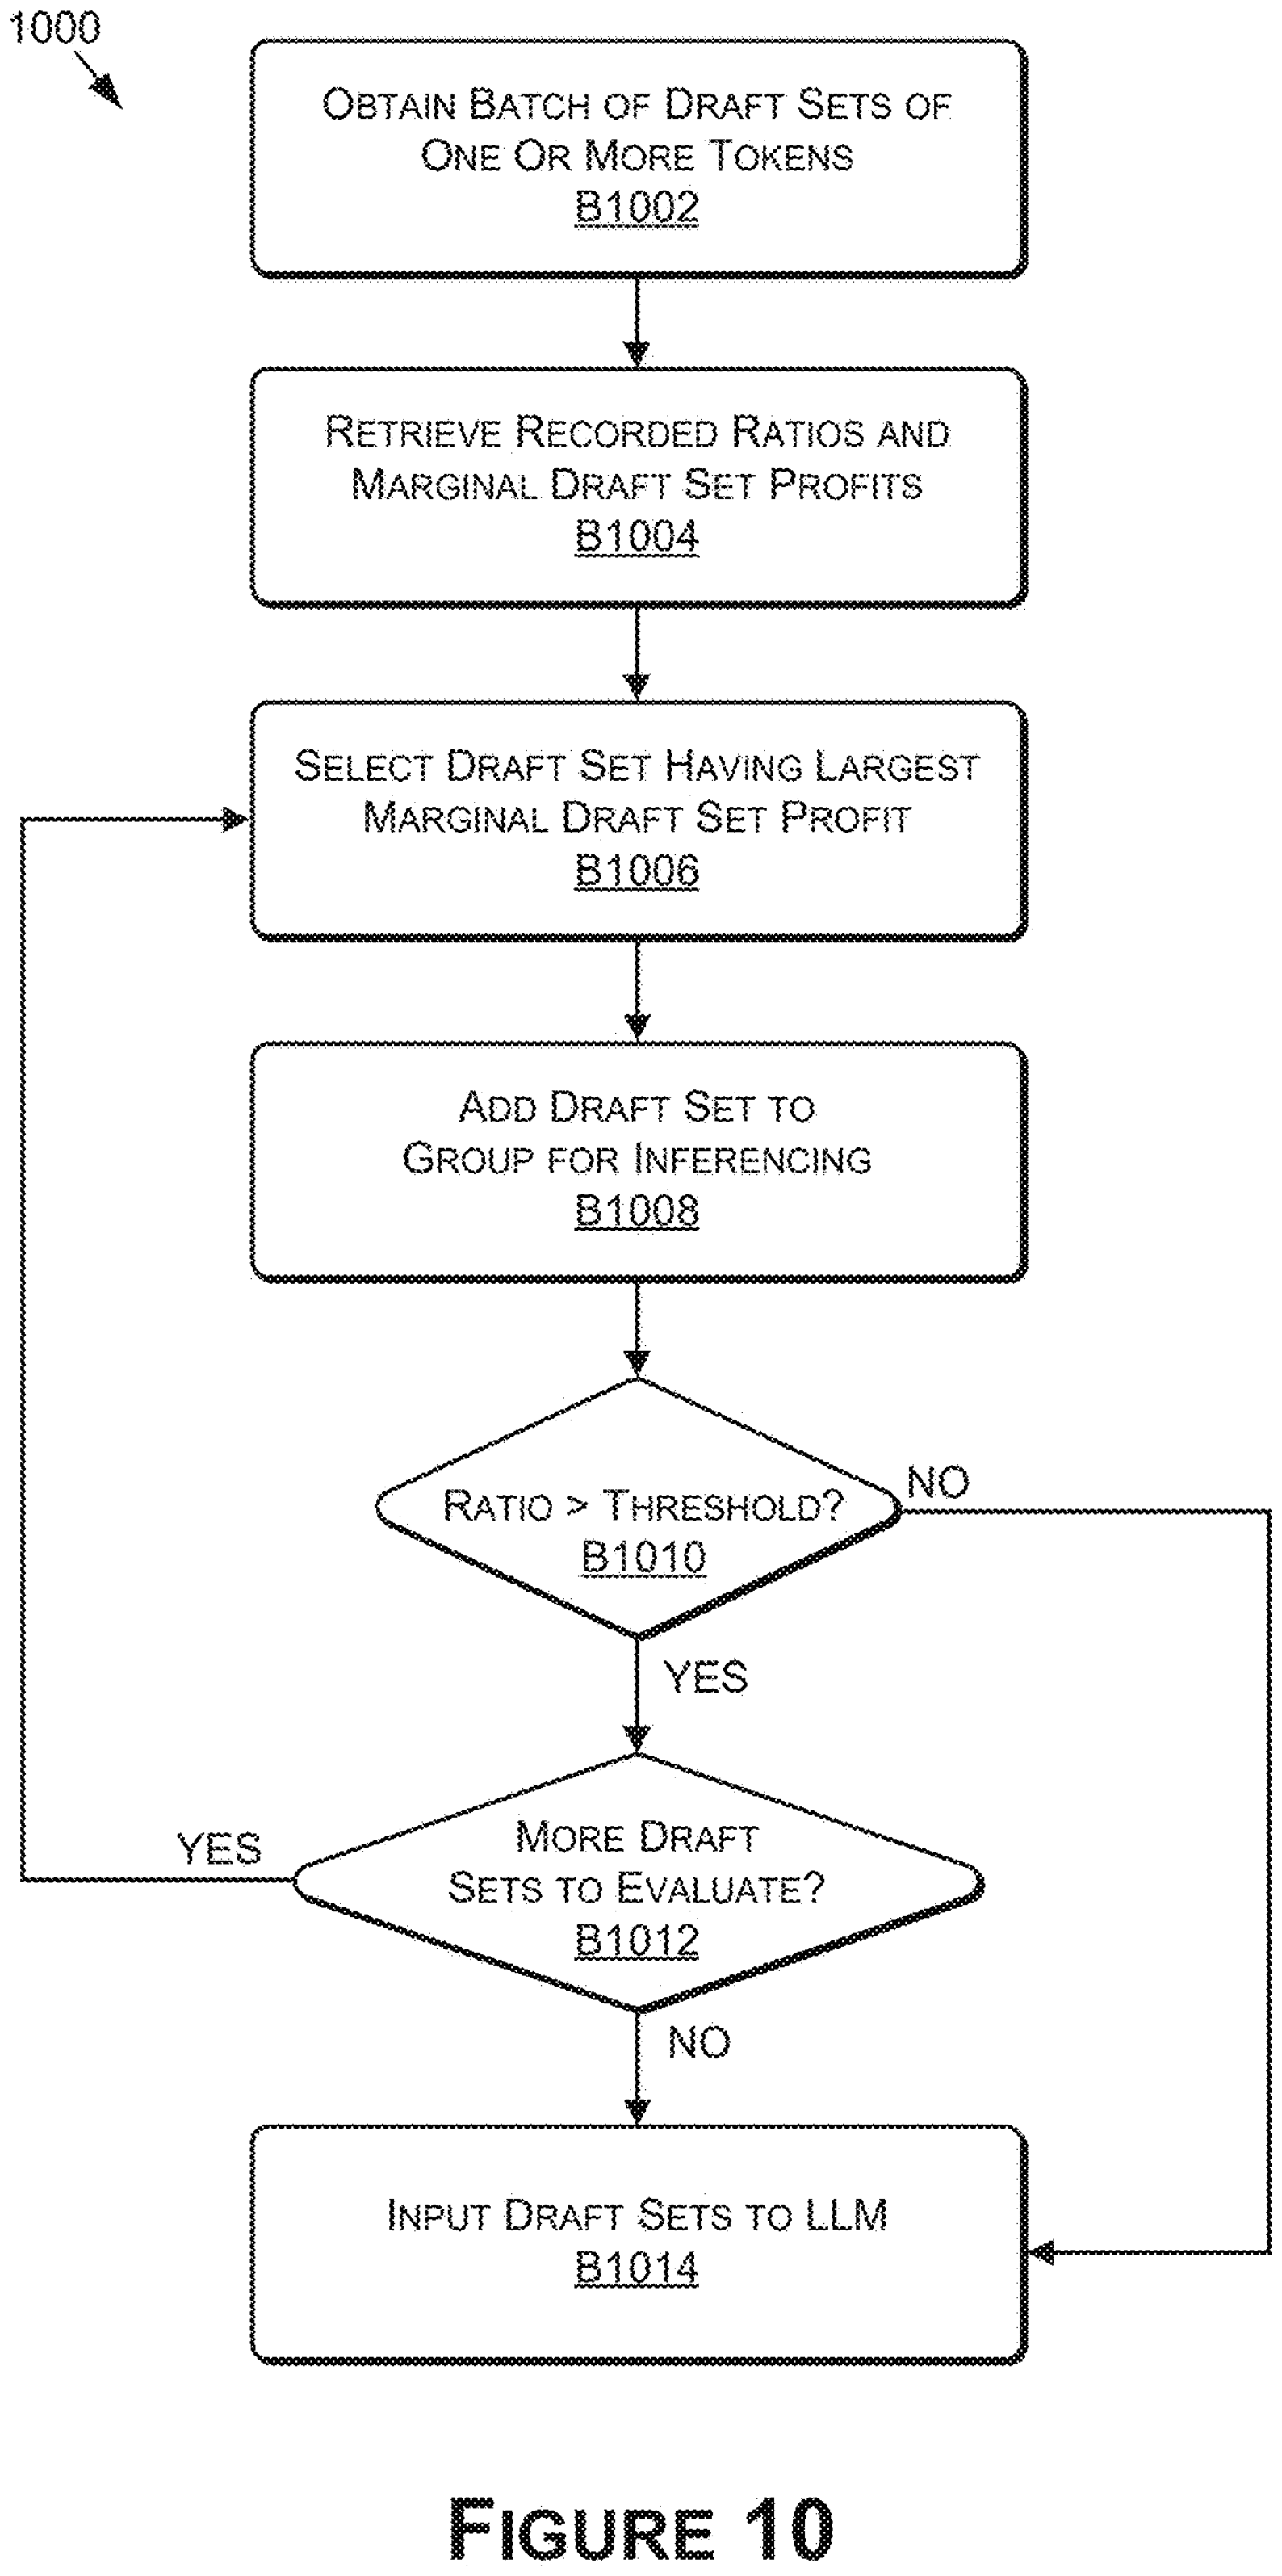
选择器考虑延长候选后预期增加的已接受词元,以及相应的额外处理时间。这里的收益是生成增量,而不是销售收入。以往的接受情况与耗时记录用于估计两者,不能仅依据候选总长度作出判断。
图10先从剩余集合中选择边际收益最大的候选加入推理组,再将收益与边际成本的比率同阈值比较,以决定是否继续选择;候选耗尽或停止后,将选定组交给模型。因此,它不等于简单按比率排序,也不等于总选最长候选。阈值还可结合计算资源和内存约束调整。
假设配送客服中的循环
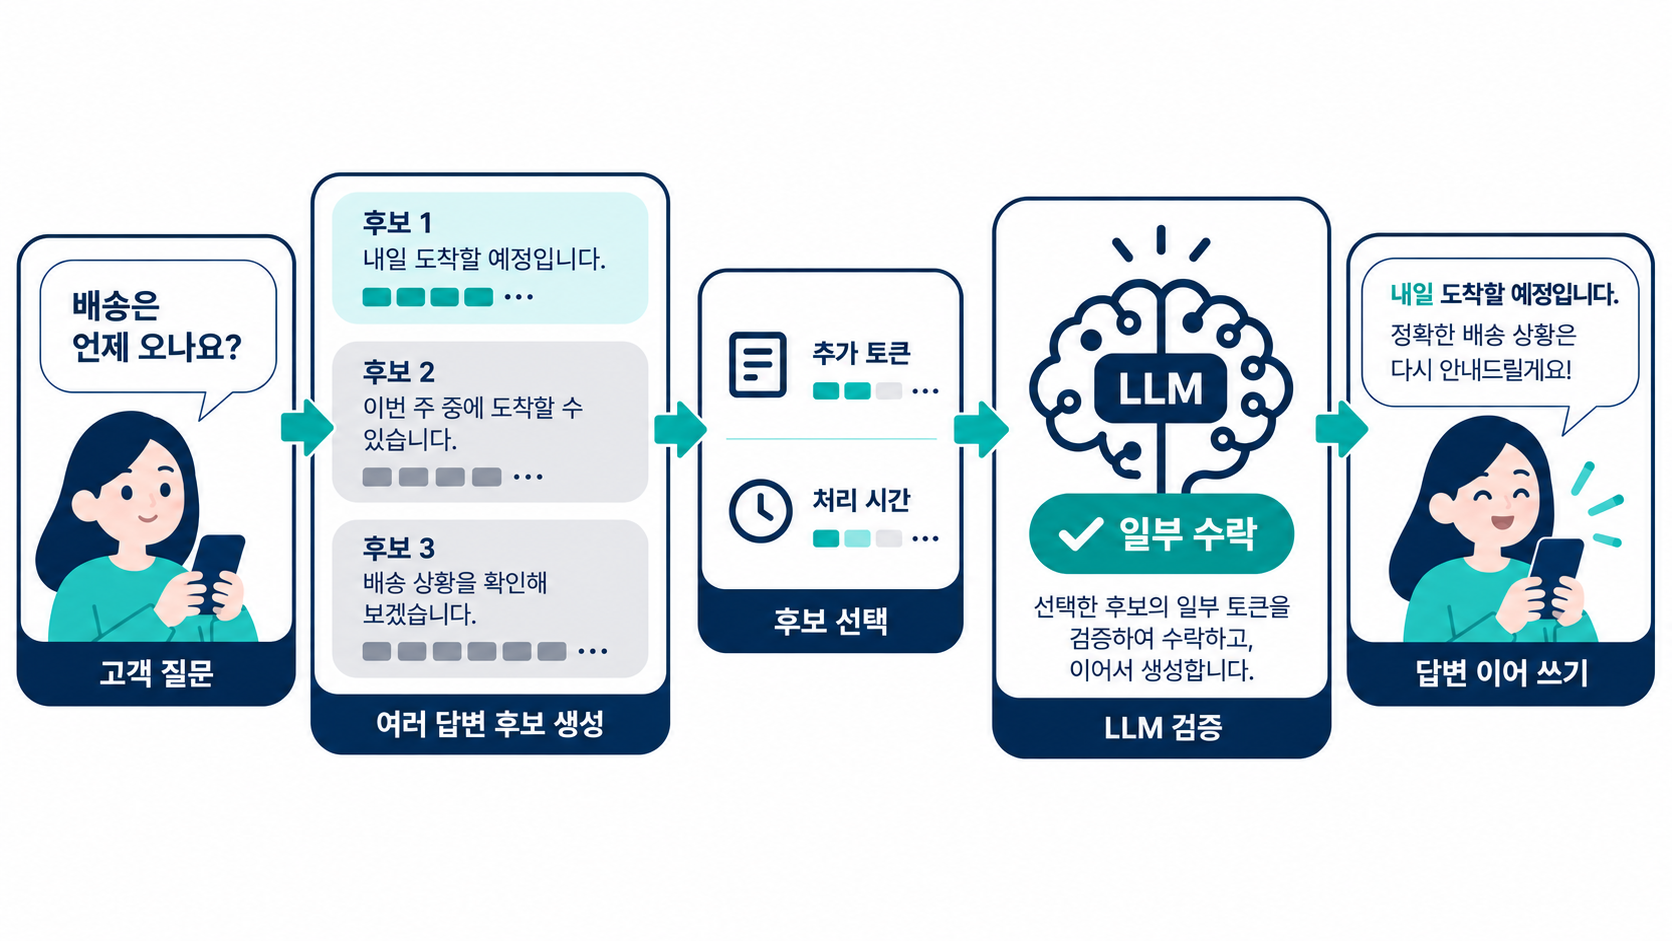
可以设想从“您的订单”延伸为“您的订单将于”和“您的订单将于今天发出”的不同草稿。这些是便于理解的语句片段,不是实际分词结果。若目标模型只接受前缀,就丢弃不合适的后缀,从模型结果继续生成。真实物流状态仍须由订单数据及业务逻辑提供。
系统记录处理时间与接受长度,再用于下一轮选择。结尾经常改变的请求未必适合长草稿,而可预测的表达可能适合提前准备更长内容。更新运行记录与重新训练权重是不同操作。配送示意属于假设场景,并非客户实施案例或性能实验。
以NIM理解产品背景
NVIDIA NIM提供可供应用调用的推理微服务。NIM for Large Language Models 2.0.10文档介绍其vLLM后端的推测解码,包括EAGLE3草稿、模型内多词元预测MTP及从输入查找重复片段的n-gram方式。模型条件和内存需求因方式而异。
应区分两个设计问题:如何生成草稿,以及让目标模型处理多少草稿。该公开申请的选择器主要有助于理解后者。产品具备推测解码功能,并不能单独证明采用了这组具体的公开权利要求。
区分延迟与吞吐量
单次回答的等待时间与服务器总体吞吐量不是同一指标。并发较低或中等、GPU尚有余量时,并行验证可能有益;负载饱和时,额外计算和内存开销可能抵消收益,甚至降低吞吐量。几个回答更快,不能代表整项服务得到改善。
应记录真实请求长度、并发量、接受率与接受长度、内存使用、处理时间及对照条件。将候选生成、选择和反馈分别设计并说明,既有助于工程评估,也方便与公开技术内容进行比对。
向IPLEX说明技术方案时可准备什么
开展AI及软件专利评估时,可整理允许公开的系统流程、候选生成与选择规则,以及注明评价条件的耗时对比。技术差异不仅可能在模型规模或硬件,也可能在计算顺序和选择过程。
IPLEX结合这些具体处理差异支持申请撰写与权利布局。本篇不作侵权、专利授权或必然加速的结论;具体实现及有关权利要求仍需单独分析。