Без формулы два проекционных пути закрытого MLP объединяются для создания промежуточного значения активации Z, и текущий Wdown применяется к Z для получения вывода O. После этого сумма обновления ΔWdown из Wdown рассчитывается с использованием целевых выражений V и Z. Упрощенная форма, представленная в статье, - ΔWdown = η · VT · Z.
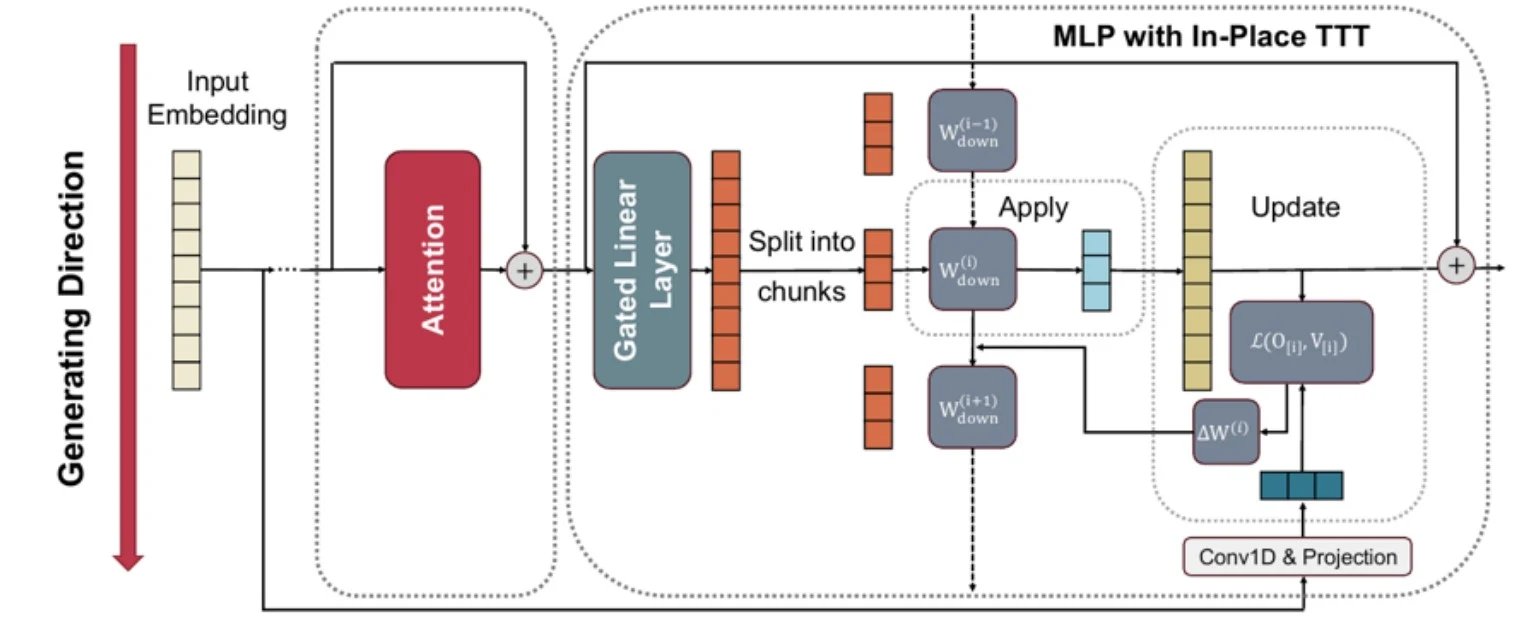
Рисунок 1. Общая структура TTT. Внимание сохраняется и только Wdown MLP обновляется быстрыми весами. Источник: Feng et al., paper p. 6, рисунок 1.
Практическое преимущество этой конструкции заключается в том, что структурные изменения незначительны. Вместо того, чтобы вставлять новый большой модуль памяти со случайной инициализацией, мы берем выходную матрицу MLP, которая уже имеет языковые возможности в качестве отправной точки. В газете это называется повышением качества.
Следует отметить, что выражение drop-in не означает, что дополнительное обучение не требуется. В эксперименте Qwen3-4B было проведено непрерывное обучение примерно 20 B токенам в 32k-контекстах и примерно 15 B токенам в 128k-контекстах. Другими словами, ключ заключается в том, что вы можете начать с существующей контрольной точки, не заменяя полностью структуру модели или предварительное обучение с нуля.
3. Основной принцип 2: сначала нанесите кусочки и обновите позже
На месте TTT делит входную последовательность на несколько кусков. В каждом куске текущие быстрые веса сначала применяются для создания вывода, а затем Wdown обновляется промежуточными значениями активации и целевыми значениями, полученными из этого куска. Обновленная матрица используется начиная со следующего фрагмента. Эта последовательность является прикладной, затем обновляемой. Диссертация pp. 4-5.
Порядок работы таков: первый кусок обрабатывается как предварительно обученный начальный Wdown, а следующий состояние Wdown создается с использованием Z и цели V, полученной из этого фрагмента. Вторая часть обрабатывается с помощью этого обновленного Wdown, а затем обновление, которое будет использоваться для третьей части, вычисляется снова. Важно то, что выход текущего куска всегда производится из его предварительного состояния. Сохранение этого порядка позволяет избежать утечек, когда текущая часть предварительно отражает информацию о правильном ответе.
Существующий слой TTT также играл роль токена-миксера, заменяющего внимание, поэтому требовались небольшие куски. С другой стороны, в In-Place TTT внимание отвечает за детальное взаимодействие токенов внутри куска, а быстрые веса MLP отвечают за состояние адаптации за пределами куска. В статье объясняется, что благодаря такому разделению ролей производительность была хорошей даже для больших кусков, таких как 512 или 1024.
4. Основной принцип 3: предсказывать токен, а не восстанавливать токен
Существующие ТТТ обычно используют цель восстановления представления текущего входного токена. Тем не менее, то, что языковая модель должна делать хорошо, это не воспроизводить сам текущий токен, а прогнозировать следующий токен на основе контекста. В статье это несоответствие рассматривается как основная проблема.
Целевое представление получают применением одномерной свертки и обучаемой проекции Wtarget к эмбеддингам токенов X0: V̂ = Conv1D(X0) · Wtarget. Настройка ядра позволяет включить следующий токен или сочетание ближайших будущих токенов. Обновление упрощается до ΔWdown = η · V̂ᵀ · Z. См. страницу 5 статьи.
Например, в шаблоне А, за которым следует В, А, за которым следует В, может появиться раньше в контексте, а затем А может появиться снова позже в контексте. Цели реконструкции, как правило, работают, глядя на A и сохраняя представление самого A, в то время как цели, выровненные по LM, смотрят на A и хранят представление B, которое следует за ним. Поэтому быстрые веса могут работать в направлении увеличения лоджита В при повторном появлении А.
5. Теоретический анализ: почему повышается логит правильного токена ответа?
Теорема 1 статьи анализирует упрощенную ситуацию в виде индукционной головки. Токен ключа и следующий токен значения появляются один раз в передней части, и когда тот же ключ появляется снова в задней части, вы должны угадать следующий токен значения. При предположении, что встраивания токенов почти ортогональны друг другу и что средние активации одного и того же ключа выровнены, LM-выровненные цели значительно увеличивают ожидаемый логит правильного токена и едва меняют логит других токенов. С другой стороны, цель реконструкции не гарантирует увеличения правильного лоджита. Статья, с. 5-6, Приложение А.
Эти теоретические результаты следует читать ограниченно. Теорема 1 не является гарантией для всех LLM и всех входных данных, но представляет собой анализ ожидаемой стоимости, основанный на предположениях, таких как примерная ортогональность встраивания и выравнивание ключевых запросов. Поэтому, хотя он и имеет значение в качестве теоретической основы для объяснения экспериментальных результатов, он не должен интерпретироваться как общая гарантия эффективности.
6. Контекстный параллелизм: как вычислить последовательные обновления параллельно
Хотя обновления по частям концептуально последовательны, дельты обновления в статье являются аддитивными и ассоциативными. Исследователи используют это свойство для вычисления ΔW каждого куска параллельно, получения кумулятивного обновления непосредственно перед каждым куском с использованием эксклюзивной суммы префикса, а затем вычисляют эффективный Wdown и выход, необходимый для каждого куска параллельно. Статья, с. 6-7, алгоритм 1.
В реализации промежуточное значение активации Z и обновление дельты ΔW во всех кусках сначала вычисляются параллельно, а затем выполняется сканирование префикса для суммирования только дельт до текущего куска. Затем эта накопленная дельта добавляется в начальный Wdown, чтобы создать быстрые веса, которые будут использоваться каждым куском, и выход каждого куска рассчитывается параллельно.
Границы кусков управляют набивкой и границами, чтобы гарантировать, что генерирующая цель свертка не извлекает будущую информацию из других кусков. Когда независимый документ закончен, быстро весы сбрасываются в состояние предварительного обучения, чтобы предотвратить утечку информации между документами.
При долгосрочной оценке Qwen3-4B численная устойчивость обеспечивалась ограничением дельты обновления нормой Фробениуса до порога 1е-5. Добавление С.2.
В нашей реализации вместо того, чтобы применять TTT к каждому уровню MLP, мы применяем его к каждому шестому блоку MLP для управления размером состояния и вычислительной стоимостью. Целевая экспрессия была построена таким образом, чтобы содержать сигнал прогнозирования токенов ближайшего будущего с использованием глубинного Conv1D и Wtarget размера ядра 5. Conv1D инициализируется до 0, а Wtarget инициализируется до разреженной диагональной формы, так что начальные обновления начинаются примерно с 0. Кроме того, на границах документов, Wdown был возвращен в состояние предварительного обучения, чтобы предотвратить утечку контекста между независимыми последовательностями, а для предотвращения наводнений в длинных последовательностях использовалась нормальная обрезка обновления.
7. Результаты эксперимента: насколько улучшилась долгосрочная контекстная производительность LLM?
7.1 Непрерывное обучение для Qwen3-4B
Исследователи обучили Qwen3-4B-Base и модели, к которой применялся In-Place TTT, используя ту же непрерывную учебную программу. Мы использовали около 20B токенов длиной 32k, около 15B токенов длиной 128k и расширили RoPE с YaRN на 128k шагов. Метрика оценки - это средняя точность RULER, которая измеряет использование длинного текстового контекста. Диссертация pp. 7-8.
Глядя на результаты RULER Qwen3-4B по длине контекста в 4k, TTT In-Place был на 96,1, на 0,5 пункта ниже базового уровня 96,6. Однако в 8к она улучшилась на 1,5 балла с 94,1 до 95,6, в 16к улучшилась на 0,6 балла с 92,1 до 92,7, а в 32к улучшилась на 0,6 пункта с 88,7 до 89,3.
Улучшение было более значительным в более длинных контекстах. Наибольшее улучшение было замечено на 64k с увеличением на 4,4 пункта с 74,3 до 78,7, на 128k это было на 2,2 пункта выше с 74,8 до 77,0, а на 256k за пределами длины обучения это было на 2,2 пункта больше с 41,7 до 43,9. Поэтому вместо того, чтобы говорить, что он всегда превосходит в коротких контекстах, более точно интерпретировать его как тенденцию к увеличению преимущества по мере того, как контекст становится длиннее.
Наибольшее улучшение составляет +4,4 балла при 64 тыс. Он поддерживал +2,2 балла на 128к и 256к за пределами продолжительности обучения, соответственно. Однако в 4К она была на 0,5 пункта ниже. Поэтому, вместо того, чтобы обобщать этот документ как метод, который всегда превосходит даже в коротких контекстах, более точно читать его как тенденцию, в которой преимущество увеличивается по мере того, как контекст становится длиннее.
7.2 Улучшения в LLaMA-3.1-8B и Qwen3-14B
Когда та же идея была применена к другим семействам моделей и размерам, производительность 64k была улучшена. LLaMA-3.1-8B поднялся с 81,6 до 83,7, а Qwen3-14B поднялся с 67,9 до 70,6. Даже в 64-километровой установке, где YaRN применялся к Qwen3-14B, он улучшился с 81,3 до 82,5, показывая, что его можно использовать параллельно с технологией расширения встраивания местоположения. Бумага п. 8, Таблица 2.
Улучшения были подтверждены и в других базовых моделях. Оценка RULER 64k для LLaMA-3.1-8B увеличилась на 2,1 пункта с 81,6 до 83,7, а Qwen3-14B увеличилась на 2,7 пункта с 67,9 до 70,6. Даже в 64-километровой установке, применяющей YaRN к Qwen3-14B, наблюдалось улучшение на 1,2 пункта с 81,3 до 82,5.
7.3 Сравнение при обучении с нуля
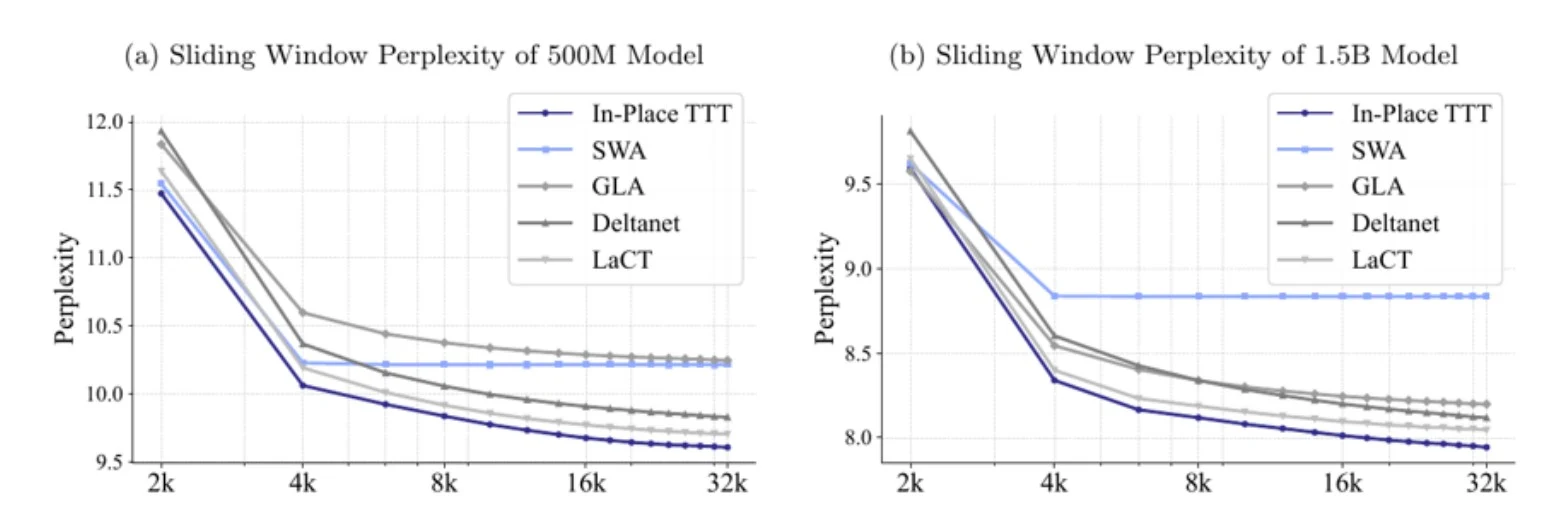
По шкале 500M и 1,5B мы сравнили его с Sliding Window Attention, Gated Linear Attention, DeltaNet и LaCT. Скользящее оконное недоумение на рисунке 2 является показателем того, насколько уменьшается сложность прогнозирования последнего блока, когда предоставляется длительный предшествующий контекст, и чем ниже, тем лучше. На месте TTT была самая низкая сложность для обеих моделей от 2k до 32k. Бумага п. 9.
В модели 4B к Full Attention и Sliding Window Attention добавляется In-Place TTT. Изменения в задаче рассуждения здравого смысла, как правило, были небольшими, но значительные улучшения были замечены на длинном RULER.
Эксперимент, изучавший с нуля в масштабе 4B, также показал улучшение производительности RULER. При полном внимании 4k увеличился на 4,21 пункта с 45,77 до 49,98, 8k увеличился на 5,73 пункта с 38,09 до 43,82, а 16k увеличился на 13,41 пункта с 6,58 до 19,99.
В Sliding Window Attention были некоторые области, где улучшение было более значительным. RULER 4k улучшился на 13,56 пункта с 14,77 до 28,33, 8k улучшился на 16,89 пункта с 9,91 до 26,80, а 16k улучшился на 2,50 пункта с 5,07 до 7,57. Ключевой момент этого эксперимента заключается в том, что, хотя изменения в задаче рассуждения в здравом смысле, как правило, были небольшими, в RULER было явное улучшение, которое требует длительного текстового контекста.
7.4 Абляция: что действительно имеет значение
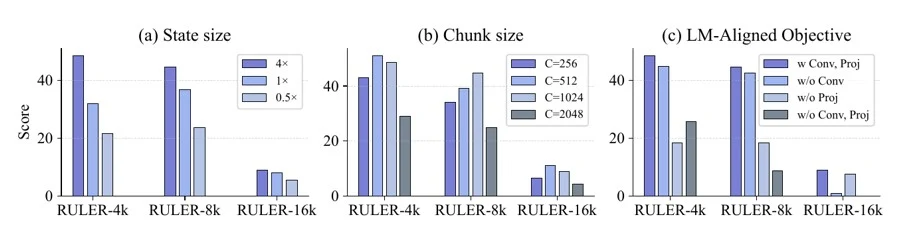
Рисунок 3. Результаты сравнения производительности при удалении размера состояния, размера куска и компонентов LM-выровненной цели. Источник: Paper p. 10, рисунок 3.
Результаты абляции показывают, что чем больше размер состояния быстрых весов, тем выше производительность RULER, что подтверждает преимущество дизайна повторного использования большой матрицы MLP в качестве динамического состояния. Размеры кусков 512 и 1024 были наиболее конкурентоспособными, и статья оценивает 1024 как выгодный выбор при рассмотрении эффективности. Кроме того, наилучшая производительность была достигнута при использовании Conv1D, который создает информацию о будущих токенах, и проекции Wtarget, которая преобразует представление вместе. Conv1D играл особенно важную роль в длинных контекстах, а проекция — в коротких.
7.5 Эффективность: Невелики ли накладные расходы по сравнению с повышением производительности?
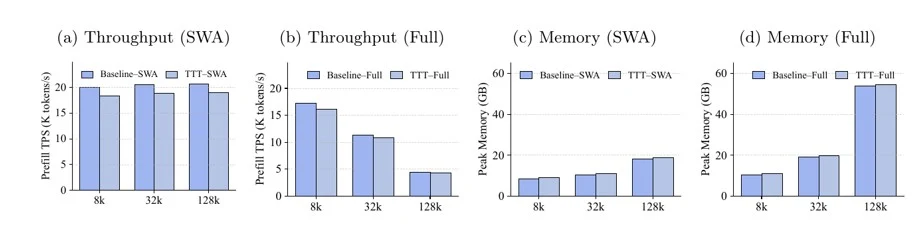
Рисунок 4. Сравнение пропускной способности предварительного заполнения и пиковой памяти в контексте 8k·32k·128k в среде H800. В статье оценивается, что практические накладные расходы невелики. Источник: Paper p. 10, рисунок 4.
Глядя на график, при применении In-Place TTT пропускная способность немного уменьшается и память немного увеличивается, но разница невелика по сравнению со стоимостью самого внимания, особенно в длинных контекстах. Тем не менее, этот вывод является предварительным измерением в конкретных условиях Nvidia H800, размера партии 1, и бумажной реализации. Результаты не обобщаются на стоимость многопользовательского обслуживания, этапов декодирования и различного оборудования.
8. Что на самом деле доказывает газета и чего она еще не доказала
Необходимо провести различие между областью применения, показанной в документе, и областью применения, которая еще не была показана. Несмотря на то, что в долгосрочном контексте мы наблюдали улучшения в RULER и скольжение оконной путаницы, мы не можем гарантировать, что производительность автоматически улучшится во всех долгосрочных задачах. Совместимость моделей также была подтверждена путем непрерывного обучения по шкале от 4B до 14B Qwen3 и LLaMA, что не означает, что она может быть немедленно применена к произвольным контрольно-пропускным пунктам без дополнительного обучения.
Кроме того, быстрые веса продолжают изменяться в документе или последовательности, но сбрасываются, когда документ заканчивается, поэтому они не сохраняют постоянных знаний во время сеансов. С точки зрения эффективности, пропускная способность и накладные расходы на память были небольшими в среде предварительного заполнения H800, но общая стоимость этапа декодирования, крупномасштабного развертывания и многопользовательской среды не оценивалась. Несмотря на то, что численная стабильность обновлений с длинным текстом обеспечивается за счет обрезания норм, нет никакой проверки на наличие вредоносных подсказок, повреждения данных или быстрого отравления. Теоретический анализ также находится на уровне объяснения влияния LM-выровненной мишени на логит в индукционной установке и не является универсальной теоремой, которая охватывает все ситуации в реальности.
Наиболее важным критическим моментом является то, что, хотя статья направлена на непрерывное обучение, фактическая реализация инициализирует быстрые веса на каждой границе документа. Таким образом, более точно рассматривать TTT на текущем этапе как адаптивное устройство сжатия памяти или контекста, которое работает в течение сеанса, а не постоянное обновление знаний.
9. Центр настоящего изобретения с точки зрения патентного поверенного, специализирующегося на патентах ИИ
В этом разделе изложена интерпретация с точки зрения патентной практики, которую следует отличать от экспериментальных выводов авторов статьи. Для оценки новизны и изобретательского уровня необходим отдельный поиск уровня техники, охватывающий патентную и непатентную литературу.
9.1 Комбинированные отношения важнее отдельных элементов
Для быстрых весов (fast weights), обучения во время тестирования (Test-Time Training), обновления по блокам (chunk-wise update), представления FFN трансформера как памяти, предсказания будущих токенов и префиксного сканирования уже существуют соответствующие направления предшествующих исследований. Поэтому формула, построенная лишь на идее обновления весов во время инференса, может оказаться широкой по охвату, но уязвимой с точки зрения патентоспособности.
Относительно сильной концепцией изобретения в этой статье является комбинация следующих трех слоев:
В этой статье относительно прочная концепция изобретения может быть найдена в комбинации трех слоев. С точки зрения архитектуры, последняя выходная проекция из блока предварительного обучения трансформера была выбрана в качестве быстрых весов, чтобы обеспечить теплый старт без замены конструкции. С точки зрения функции цели, вместо восстановления текущего токена, мы создали целевое представление, содержащее информацию об одном или нескольких последующих токенах, чтобы выровнять направление обновления с предсказанием следующего токена языковой модели. В плане исполнения матрица предварительного обновления наносится на текущий фрагмент, а дельта, вычисленная в текущем фрагменте, отражается только в последующих фрагментах, параллелизируя его с эксклюзивным префиксным сканированием.
9.2. Признаки формулы изобретения и технический эффект
При составлении формулы изобретения важно связать технический эффект с сочетанием признаков, а не только с каждым признаком отдельно. Например, использование выходной проекции блока прямого распространения (feed-forward block) в качестве быстрых весов позволяет подчеркнуть динамическую адаптацию с сохранением предварительно обученной структуры. При подходе apply-then-update приращение, рассчитанное после получения выхода текущего блока, формирует состояние для последующих блоков. Это позволяет связать решение с сохранением причинности и предотвращением утечки информации.
Выровненные LM-мишени могут быть организованы в конструкции, которые генерируют целевое представление, содержащее последующую информацию токена из встраивания текущего фрагмента, тем самым сохраняя полезный контекст для прогнозирования следующего токена. Кузовный метод, который обновляет матрицу несколькими токенами, а не токеном, связан с параллелизмом GPU и улучшенной пропускной способностью, а префиксное сканирование, которое вычисляет дельту каждого куска параллельно, а затем накапливает его до предыдущего куска, можно рассматривать как конфигурацию, которая одновременно поддерживает последовательный смысл и контекстный параллелизм. Объединив это с сбросом границ документа, обрезанием норм и почти нулевой инициализацией, мы можем дополнительно продемонстрировать эффекты предотвращения утечки перекрестных документов, численной стабильности и сохранения исходного поведения.
9.3 Стратегия применения и перспективы осуществления прав
В стратегии патентования метод непрерывного обучения, обеспечивающий обучение быстрых весов, можно рассмотреть в отдельном независимом пункте формулы наряду с независимым пунктом на способ инференса. Реализация с параллелизмом по контексту обеспечивает самостоятельный технический эффект — повышение эффективности использования аппаратных ресурсов — и может быть охвачена отдельными пунктами на способ параллельной обработки или систему. Пункты на устройство, серверную систему и машиночитаемый носитель позволяют учесть различных субъектов использования и возможности защиты права. Однако изменение весов только внутри сервера затрудняет доказывание нарушения извне. Поэтому целесообразно учитывать признаки, которые можно выявить по файлам модели, журналам выполнения, API состояния обновления, открытому исходному коду и показателям производительности или памяти. Результаты статьи, показывающие улучшение обработки длинного контекста при небольших накладных расходах, могут подтверждать технический эффект программного изобретения. При этом описание должно содержать достаточные воспроизводимые примеры осуществления и диапазоны параметров.
10. Промышленные последствия: где это может быть полезно
In-Place TTT особенно привлекателен для задач с длинным контекстом, повторяющимися закономерностями в одном документе или сеансе и высокой стоимостью повторной обработки всех токенов механизмом внимания. Примеры — анализ длинных договоров и патентных описаний, работа с крупными репозиториями кода, длительными журналами действий агента и потоковыми журналами, а также адаптация к предпочтениям пользователя в рамках сеанса.
И наоборот, тот факт, что быстрые веса обновляются непосредственно с помощью ввода, также означает, что поверхность атаки может увеличиваться. Загрязняет ли вредоносный ввод временную память, как изолировать несколько запросов пользователей, когда сбрасывать статус обновления и как оставлять журналы аудита, являются важными проблемами проектирования в реальных службах. Эти предметы не были экспериментально протестированы в газете.
11. Часто задаваемые вопросы
Q1. Является ли In-Place TTT такой же, как и общая настройка?
Это не одно и то же. Точная настройка обычно включает в себя долгосрочные изменения модели с использованием отдельных данных и процедур обучения. На месте TTT временно обновляет некоторые Wdowns при обработке входной последовательности и возвращает их на границах документа. Тем не менее, для того, чтобы этот механизм работал хорошо, требуется постоянная подготовка.
Q2. Все ли модели изменяются во время вывода?
Нет. Бумага фиксирует Wup и Wgate закрытого MLP и использует Wdown в качестве быстрых весов. В крупномасштабных модельных экспериментах мы применяли его на каждом шестом слое.
Q3. Является ли эта технология заменой внимания?
Нет. Ключевой отличительной чертой этой статьи является то, что внимание поддерживается, а адаптация MLP дополняет его. Поскольку Attention обрабатывает отношения токенов внутри кусков, In-Place TTT может использовать более крупные обновления.
Q4. Является ли длина контекста практически неограниченной?
Ты не можешь быть так уверен. 128-километровая модель была лучше базовой на 256-километровой RULER, но абсолютный балл составил 43,9. Это свидетельство улучшенного использования и экстраполяции длинных предложений, но не доказательство идеальной памяти для неограниченного контекста.
Q5. Какая самая важная линия с точки зрения патента?
Это комбинированное соотношение, которое использует существующую проекцию вывода MLP пре-обучающегося трансформера в качестве быстрых весов, применяет состояние перед обновлением к текущему фрагменту и отражает обновление, рассчитанное как цель, включая последующую информацию о токене, из следующего фрагмента.
12. Заключение
In-Place Test-Time Training не предлагает полностью новую архитектуру, чтобы привнести динамические адаптивные возможности в LLM. Мы переосмысливаем существующую MLP-версию Wdown в быстро меняющемся состоянии и разрабатываем фрагментарное сканирование, подходящее для целей языковой модели и параллельного аппаратного обеспечения. Это самая интересная часть, как с технической точки зрения, так и с точки зрения патентов.
Эксперименты показывают существенное улучшение результатов на задачах длинного контекста RULER и по метрике перплексии. Однако возможность встраивания в существующую модель не означает отсутствия дополнительного обучения: использовалось непрерывное обучение на 35 млрд токенов, а быстрые веса сбрасывались на границах документов. Применение в реальных агентных системах, требования безопасности и среда с несколькими арендаторами пока не проверены.
В конечном счете, эта статья ближе к практическому дизайну, который преобразует внутренний MLP предварительно обученного LLM в адаптивную память, а не завершает постоянно самообучающийся LLM. С точки зрения патента целесообразно сосредоточиться на отношениях, которые сочетают в себе адаптацию Wdown на месте, LM-ориентированную цель, прикладную, а затем обновленную причинность и контекстно-параллельное сканирование, а не отдельные элементы.
Материал отражает ситуацию на дату публикации. Обратитесь в IPLEX, чтобы обсудить обстоятельства вашего дела.