
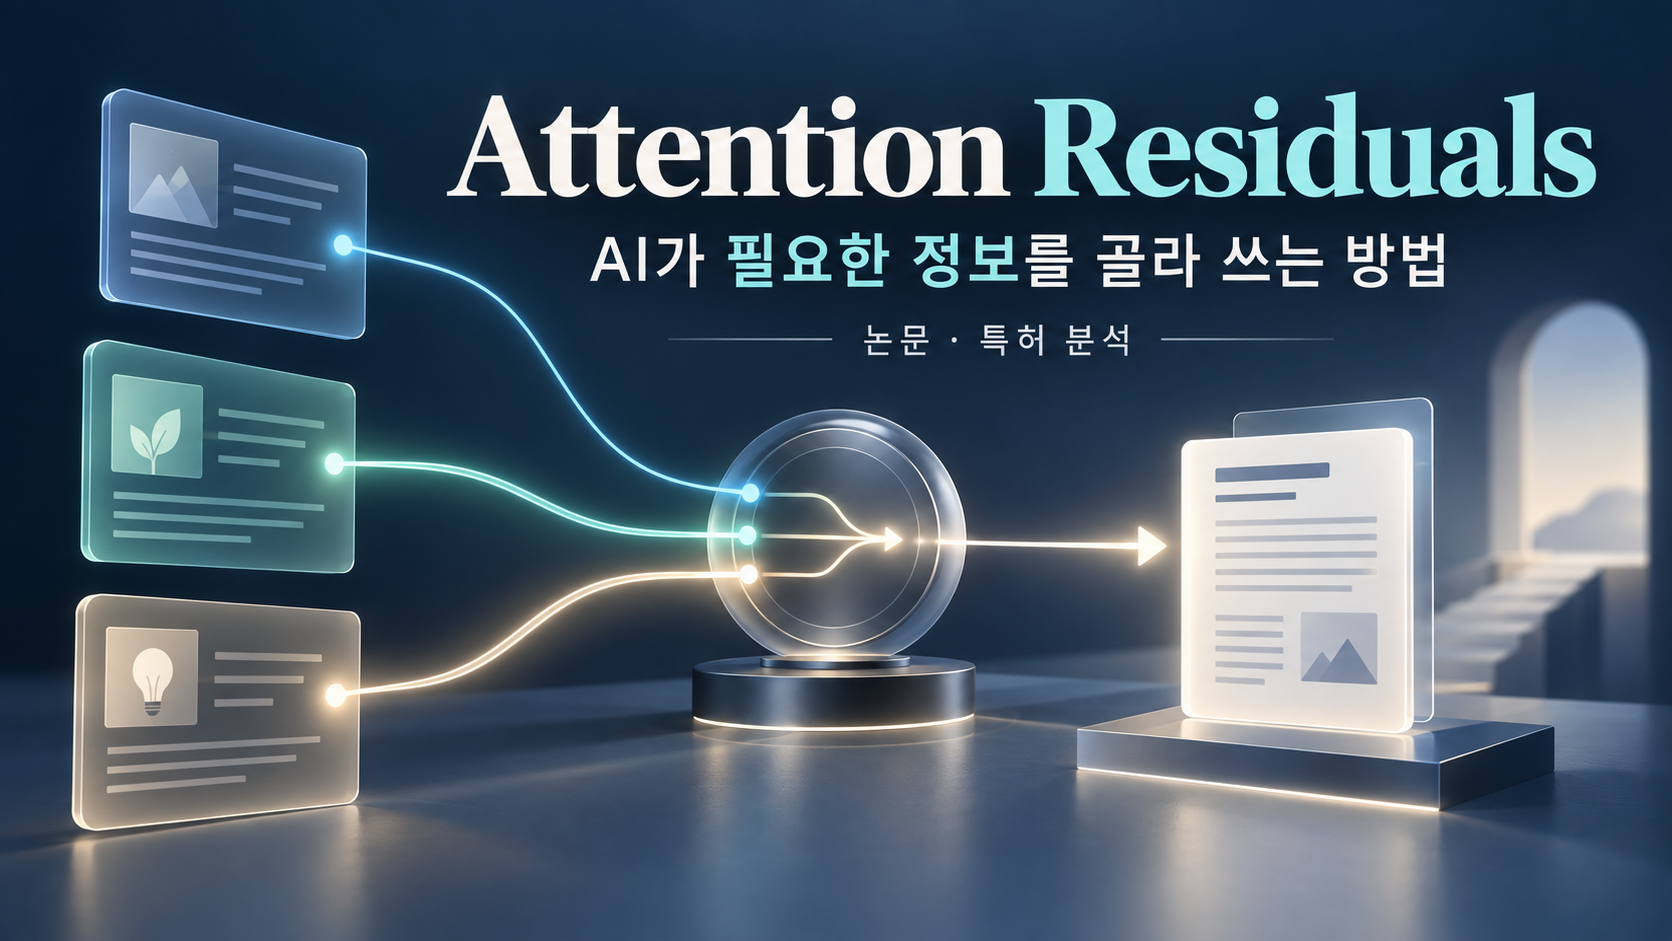
Attention Residuals меняет способ передачи информации между слоями ИИ-модели. Вместо сложения предыдущих выходов с одинаковыми весами метод определяет вклад каждого представления по обученному критерию с учётом входных данных. Ниже мы объясняем этот принцип на простом примере, а затем рассматриваем конкретные особенности реализации с точки зрения подготовки патентной заявки.
Объект анализа: работа Kimi Team «Attention Residuals», версия arXiv v1 от 16 марта 2026 года.
Зачем пересматривать остаточные связи?
Модель обрабатывает входные данные последовательно, слой за слоем. Слой — это отдельный этап обработки, а остаточная связь добавляет новый результат к информации, поступившей с предыдущих этапов, и передаёт сумму дальше.
При обычном остаточном накоплении предыдущие выходы суммируются с одинаковыми коэффициентами. Авторы рассматривают размывание вклада отдельных слоёв по мере увеличения глубины модели. Attention Residuals сопоставляет предыдущие представления и объединяет их с весами, зависящими от входных данных.
Механизм внимания сопоставляет информацию и определяет её вес. Здесь сравниваются представления одного и того же токена на разных слоях. Токен — небольшая единица, на которые делится текст для обработки; в данном случае отбор происходит по глубине модели.
Пример с заметками к отчёту
Представим, что три коллеги оставили заметки к отчёту. Редактор может уделить больше внимания той, которая полезнее для редактируемой фразы. Аналогичным образом модель сочетает результаты предыдущих этапов в пропорциях, соответствующих входным данным.
Условный пример: заметка A учитывается с весом 10%, B — 20%, C — 70%; полученная комбинация используется на следующем этапе. Эти проценты приведены только для пояснения и не являются результатами экспериментов из статьи.
В реальной модели результаты представлены наборами чисел, а веса вычисляются по обученному критерию сравнения. Человек не назначает каждой «заметке» степень важности вручную.
Три этапа работы механизма
Сначала собираются предыдущие выходы и нормализуются представления, используемые для расчёта весов. Нормализация приводит сравниваемые величины к согласованному масштабу.
Затем по критерию, обученному для каждого слоя, вычисляются оценки. Функция softmax преобразует их в веса с суммой 100%. Наконец, с этими весами объединяются исходные представления, а не только нормализованные величины для сравнения; результат поступает на следующий этап.
Раздельное хранение всех предыдущих выходов увеличивает затраты памяти и обмена данными. В Block AttnRes несколько слоёв объединяются в блок: внутри него выходы складываются, а механизм внимания определяет вклад представлений разных блоков. Это снижает нагрузку, связанную с хранением и передачей выхода каждого слоя.
Что подтверждают эксперименты и где проходят границы
Авторы сообщают об улучшениях в тестах на общие знания, математику, программирование и другие задачи после обучения моделей на основе Kimi Linear. Выводы относятся к описанным архитектуре и условиям обучения и оценки. Они не доказывают, что одна лишь замена связей в уже существующей модели даст тот же эффект.
В качестве возможного применения можно рассмотреть систему подготовки кратких версий корпоративных отчётов. При оценке реализации следует измерять не только качество резюме, но и память для предыдущих выходов, объём межустройственного обмена и время обработки. Это пример потенциального применения, а не утверждение об использовании метода в конкретном коммерческом продукте.
От технической идеи к подготовке патентной заявки
Ниже изложен независимый взгляд на опубликованную работу с позиции патентной практики. Это не толкование объёма охраны конкретного выданного патента и не заключение о патентоспособности. Формула изобретения определяет испрашиваемую охрану, поэтому цель «отбирать информацию» необходимо раскрывать через конкретные средства и этапы обработки.
Объект отбора: определить, используются ли выходы отдельных слоёв или представления групп слоёв. Расчёт весов: установить, как сочетаются обученный критерий сравнения, нормализация и взвешивание, в том числе в какой последовательности.
Хранение и передача: описать устройство и последовательность обработки, обеспечивающие сохранение предыдущих результатов и сокращение повторных передач. Технический результат: зафиксировать влияние изменений на производительность, память и объём обмена вместе с условиями сравнения.
Для патентного анализа ИИ-решения подготовьте схему обработки, отличия от известных подходов, данные сравнительных испытаний и план раскрытия технологии. IPLEX оценивает технические отличия при разработке стратегии охраны, опираясь на опубликованный опыт анализа ИИ-патентов, проектов IP-R&D и профильные книги. Подробности приведены в профессиональном профиле патентного поверенного Ёндука Кима.
Анализ по состоянию на 3 октября 2026 года, на основе arXiv v1. Независимое воспроизведение экспериментов не проводилось.