
対象論文と解説の位置付け
韓国弁理士の金容徳が取り上げるのは、AppleのLuca Moschella、Laura Manduchi、Ozan SenerによるLearning to Evict from Key-Value Cacheです。ICML 2026の正式論文集版、Proceedings of the 43rd International Conference on Machine Learning、PMLR 306:90470–90496を分析対象とします。金容徳は本解説の執筆者であり、論文の著者ではありません。
arXiv番号は2602.10238で、初公開は2026年2月10日、v2は同年6月26日です。DOI 10.48550/arXiv.2602.10238はarXivの記録を示し、PMLR版の別個のDOIとして扱うものではありません。KVPの要点は、各KVキャッシュに残すトークンの優先順位を学習し、容量が変わっても将来参照される情報を優先することです。
キャッシュを減らすと何が失われるか
Transformerは過去のトークンのキーと値を保存し、新たなトークンを処理するたびに再計算することを避けます。このKVキャッシュは文脈が長くなるほど増えます。単に古い情報から削除すると、後の質問に必要な手掛かりも失われます。限られた机に資料を広げる場面と同じく、直近で使った資料が次にも必要とは限りません。
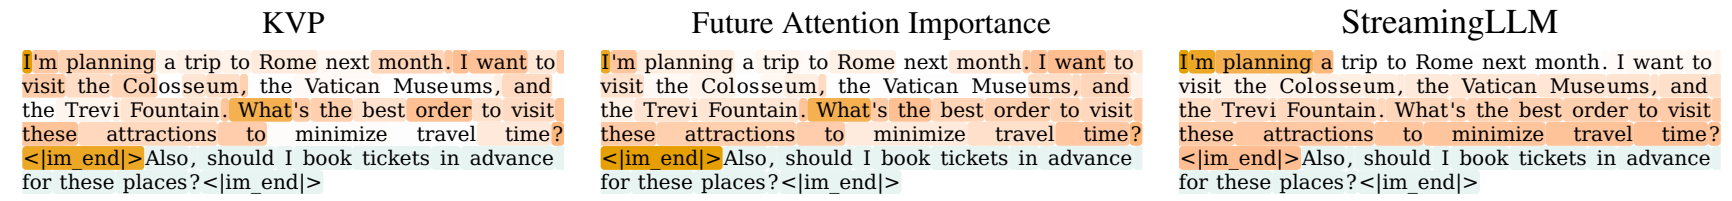
従来の削除規則は位置、過去のアテンション、キーの性質などを利用します。KVPは将来の有用性を学習して予測します。図1は旅行の会話について、KVP、実際の将来アテンションに基づく理想的な評価、StreamingLLMを比較しています。将来アテンションは事後的に作る学習用の基準であり、運用時に未来の質問を見ているわけではありません。
容量ごとの削除判断ではなく順位を学習する
KVPは全トークンにスコアを付け、キャッシュ予算がb個なら上位b個を残します。同じ順位を500個や1,000個など異なる容量に利用できます。目的関数は、特定の容量だけでなく、複数の容量で削除される将来アテンションの重要度をまとめて抑えるように設計されています。
論文の加算可能な効用の定義では、将来重要度順の並びが複数の容量に共通する最適順位になります。ただし、これは代理目的に関する性質です。あらゆる質問の正答率を常に最大化する証明ではなく、トークン間の相互作用や生成品質をアテンションの和だけで完全に表すものでもありません。
層・ヘッドごとの小さな方策ネットワーク
入力はトークンのキー、値、元の位置です。運用時にクエリベクトルやアテンション行列全体は不要で、層とKVヘッドごとに小さな多層パーセプトロンを用います。主実験のQwen2.5-7Bは28層、各層4KVヘッドなので、約65万パラメータの方策が計112個になります。
推論では現在のK・V・位置からスコアを求め、容量に応じた上位項目を選び、残したキャッシュでアテンション計算を続けます。評価実装では先頭4トークンと末尾16トークンを常に残します。容量は各ヘッドに等しく割り当てており、不均等な配分を学習した実験ではありません。
将来の参照を教師信号にするオフライン学習
まず元の言語モデルを実行し、Q・K・Vの実行記録を収集します。後続クエリが以前のキーに向けるアテンションを将来有用性の指標とすることで、方策を更新するたびに大規模モデル全体を再実行せず報酬を計算できます。ただし、最初の記録収集のコストは残ります。
スコアからPlackett–Luce順位分布を定め、Gumbelノイズを加えてソートし、複数の順位を並列に標本化します。REINFORCEと、他の順位標本の報酬を基準にするRLOOで更新します。複数の容量の損失を含めるため、小容量から大容量までを意識した学習になります。未来情報は学習目標に使い、運用時の判断は保存済みの特徴だけで行います。
実験条件を確認する
中心となるモデルはQwen2.5-7Bで、約4KトークンのRULER又はOASST2の会話を用いて方策を学習します。StreamingLLM、TOVA、SnapKV、LagKV、KeyDiff、K-Norm等と比較し、付録ではPhi-4-14Bも評価しています。学習データの違いを区別して結果を読む必要があります。
短い文脈では入力処理であるプリフィル後に一度キャッシュを圧縮して応答を生成します。長い入力はチャンクに分け、以前に残した項目と合わせて処理します。短文脈の一部はアテンションマスクで削除を模擬し、長文脈ではKVテンソルを実際に圧縮しています。そのため正確さの改善を、そのまま一般的な省メモリ率や遅延削減率に置き換えることはできません。
短文脈の結果は軸の意味を区別する
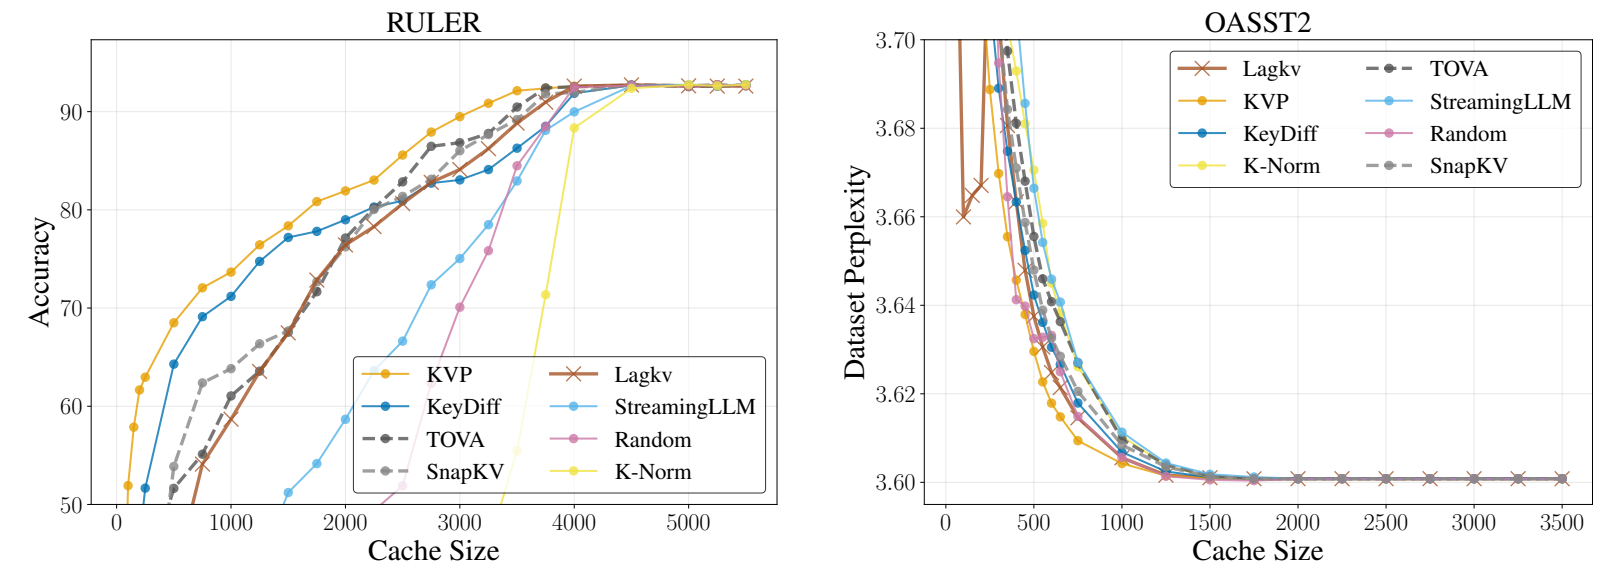
図2のCache Sizeは残すトークン数です。RULERは正答率が高いほどよく、OASST2はパープレキシティが低いほどよい指標です。KVPは広い容量範囲で良好な結果を示し、容量が十分になると手法間の差は縮まります。
OASST2の極小容量ではLagKVが上回る場合もあります。示されているのは実験条件内での品質と容量の良好な関係であり、すべての容量・タスクでKVPが最良という結論ではありません。
約4Kの学習から128Kの入力へ
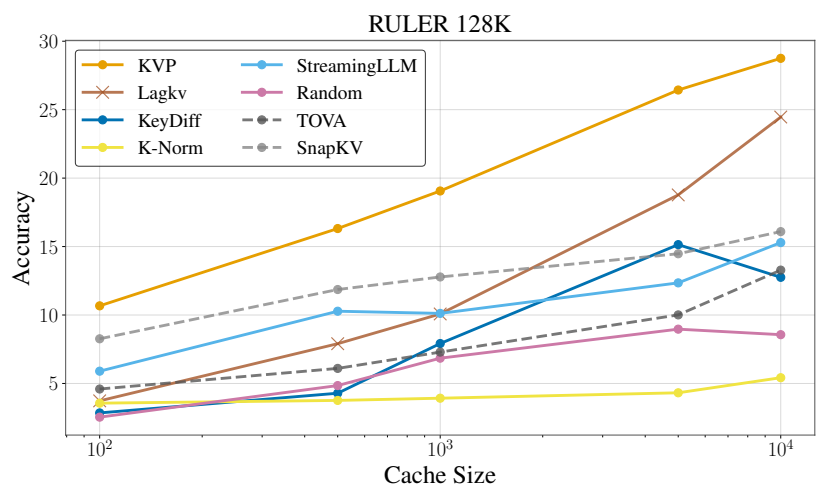
図3では約4Kで学習した方策をRULER-128Kに適用しています。表示された容量の範囲でKVPは比較手法を上回り、長い入力にも順位付けが移行し得ることを示します。
一方、キャッシュ10,000の正答率は図からおよそ29%と読み取れます。これは概数であって、128K文書をほぼ完全に記憶したことを意味しません。圧縮下での相対的な改善と、情報損失がなくなることは区別すべきです。
学習データで残す情報が変わる
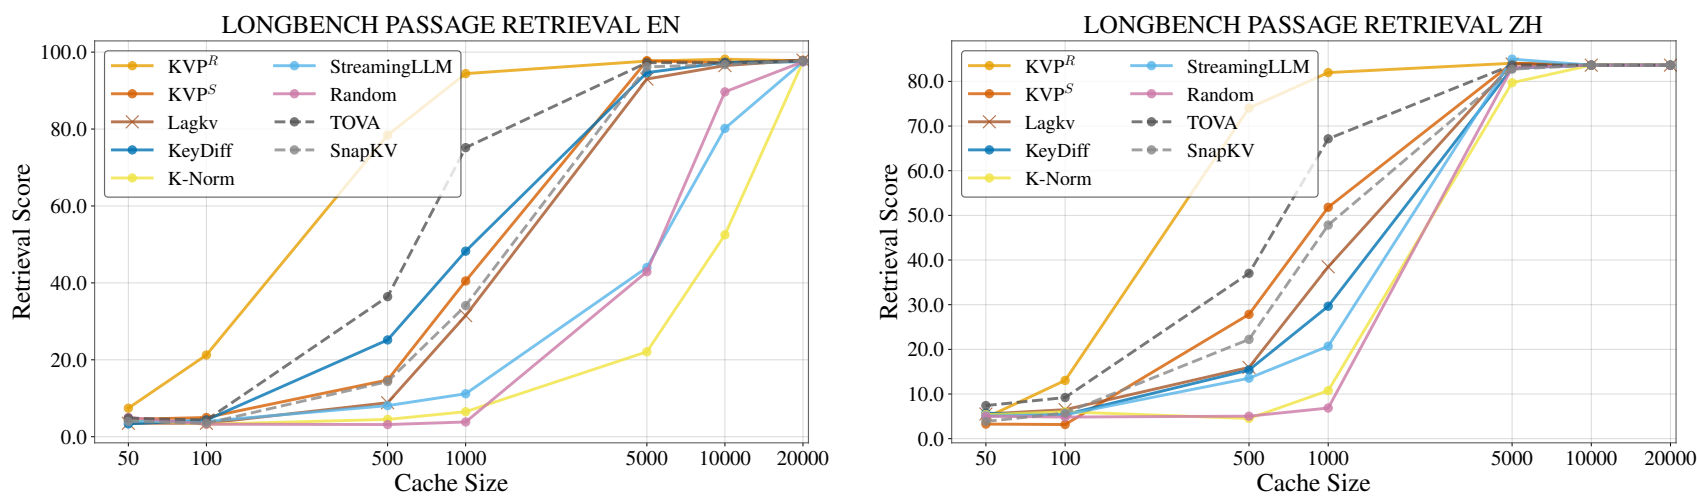
図5はRULERで学習したKVPᴿとOASST2で学習したKVPˢを、LongBenchの英語・中国語の段落検索で比較します。小容量では特にKVPᴿが有利です。英語のキャッシュ約1,000では、図上KVPᴿは90%台、KVPˢは約40%で、いずれもグラフからの概数です。
一方、BoolQやGovReportでは会話データの方策がより適合する傾向があります。検索支援、長い対話、要約では保持すべき手掛かりが異なり得ます。導入時には対象業務の情報を残せるか、品質・メモリ使用量・遅延を併せて検証する必要があります。
目的関数の比較から分かること
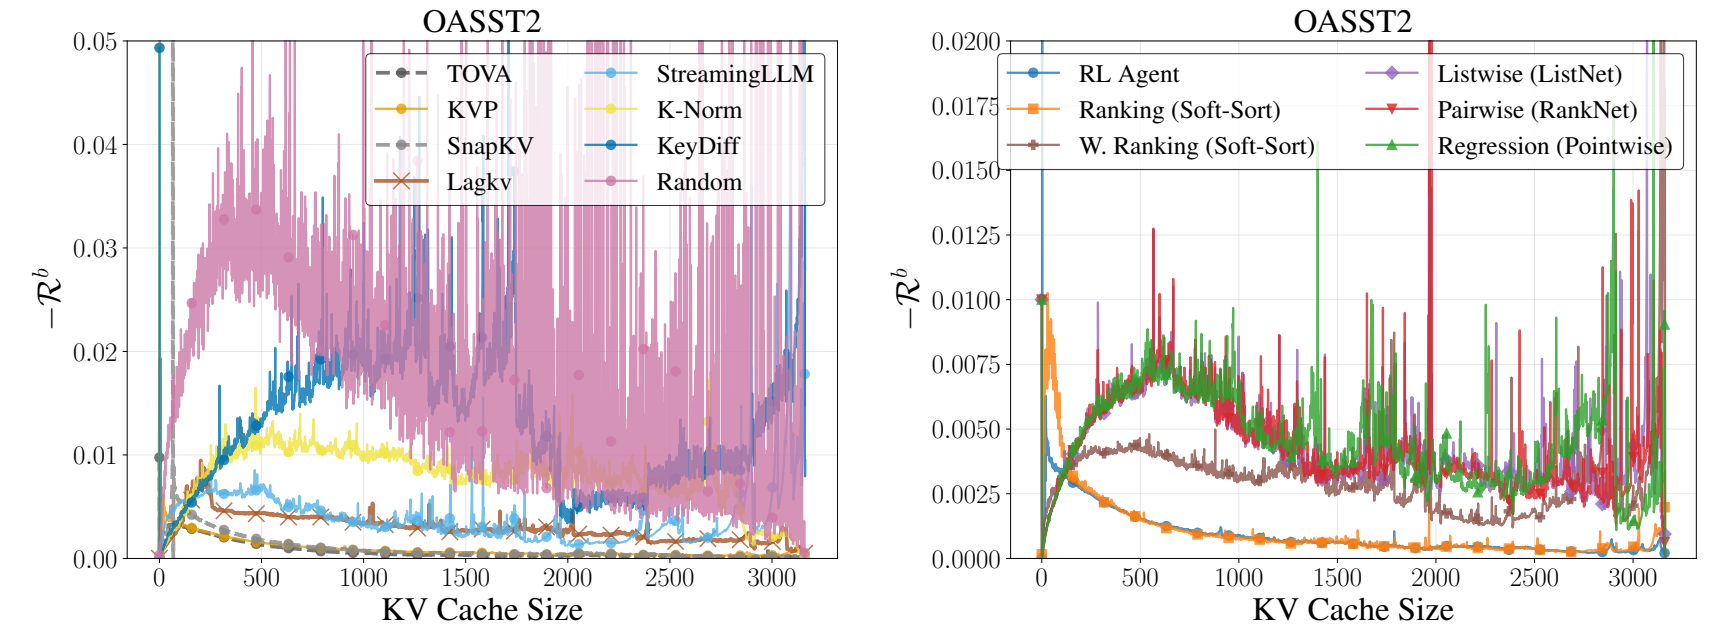
図6は回帰、ペア単位の順位学習、リスト単位の順位学習、強化学習を比較します。縦軸は正答率ではなく、順位ごとのトークンが正規化学習コストに与える寄与、すなわち報酬の負値で、低いほどよい指標です。大きなアテンションを受ける少数項目に偏ると、その他の順位を十分学習できない場合があります。
容量全体を考慮する報酬はその問題に対応します。ただし重みなしSoftSortも極小容量以外では競争力があります。これはOASST2の第10層・KVヘッド0のアブレーションであり、すべてのモデルやヘッドに強化学習だけが正解だと示すものではありません。
選択処理の軽さとサービス全体の高速化は別
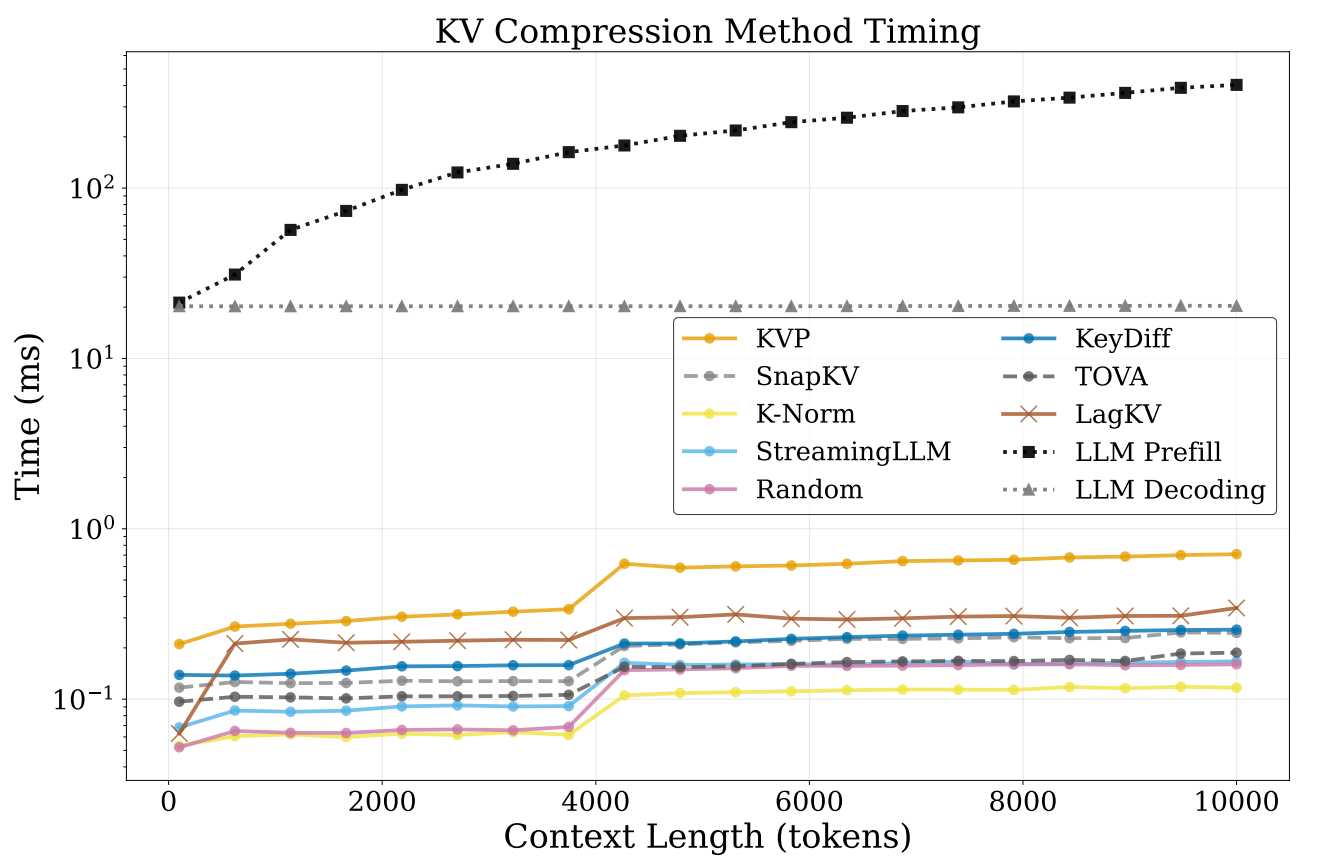
図7はNVIDIA B200で個別KVキャッシュの重要度評価と選択インデックス計算を測り、モデル全体のプリフィル・デコード時間を参照線として示します。TOVAとSnapKVのアテンション再計算費用は含まれません。10,000トークンではKVPの選択処理が約0.71ms、モデル全体のプリフィルが約404msです。
対象処理が異なるため、この比をサービス全体の数百倍の高速化と表現することはできません。112方策を含めたパラメータ数による演算量推定では、1トークン当たり約14から14.15GFLOPsへ、約1%増えます。これは理論上の演算量増分であり、遅延やメモリが実測で1%増えるという意味ではありません。最適化済みサービス全体の比較も示されていません。
準備コストと残る限界
OASST2の記録収集例では4,649会話に対し、8GPUを備えた7ノードを用い、約1.2TBの記録を保存しています。8基のH100を備えた1ノードで単一方策の学習が30分未満という数値は、112方策すべての収集・学習総時間ではありません。
将来アテンションはあくまで代理目標であり、層・ヘッドごとの独立学習は相互作用を十分扱わず、データ分布にも依存します。評価の中心はプリフィル前後の圧縮で、非常に長い連続生成の途中で常時削除する運用が同じように安定することまでは確認されていません。
弁理士の視点で技術の組合せを捉える
課題は、増大するKVキャッシュを限られたメモリに収めながら、後の推論に必要な情報の損失を抑えることです。K・V・位置を使う層・ヘッド別の方策、容量をまたいで共用する順位、削除損失を統合する報酬、収集済み記録によるオフライン学習を、効果に至る構成のつながりとして読むことが重要です。
学習時には将来の参照情報を用い、運用時には現在のキャッシュだけで判断する点が注目されます。確認された効果は所定条件での品質改善、長文脈への適用、選択処理の小さな負荷です。それ自体が特許性、特許取得又は権利範囲を示すわけではありません。KVPの可能性は、データ・目的関数・評価条件への依存性とともに検討すべきです。
図版:CC BY 4.0。原図の内容を保持し、ウェブ表示形式に変換