
论文来源与解读范围
韩国专利代理师金容德解读Apple研究人员Luca Moschella、Laura Manduchi和Ozan Sener的Learning to Evict from Key-Value Cache。分析依据为ICML 2026正式论文集版本:Proceedings of the 43rd International Conference on Machine Learning,PMLR 306:90470–90496。金容德是本文解读作者,并非论文作者。
arXiv编号为2602.10238,首次公开于2026年2月10日,v2更新于6月26日。DOI 10.48550/arXiv.2602.10238对应arXiv记录,不应表述为另一个PMLR DOI。KVP的核心是为各KV缓存学习保留优先级,使不同容量限制下都能优先留下之后可能有用的信息。
缓存容量与信息保留的矛盾
Transformer保存已处理token的键和值,避免每生成一个新token都重新计算历史信息。上下文越长,KV缓存越大;简单删除较早内容,可能同时丢掉回答后续问题所需的线索。就像面积有限的书桌,最近翻过的资料未必是接下来最需要的资料。
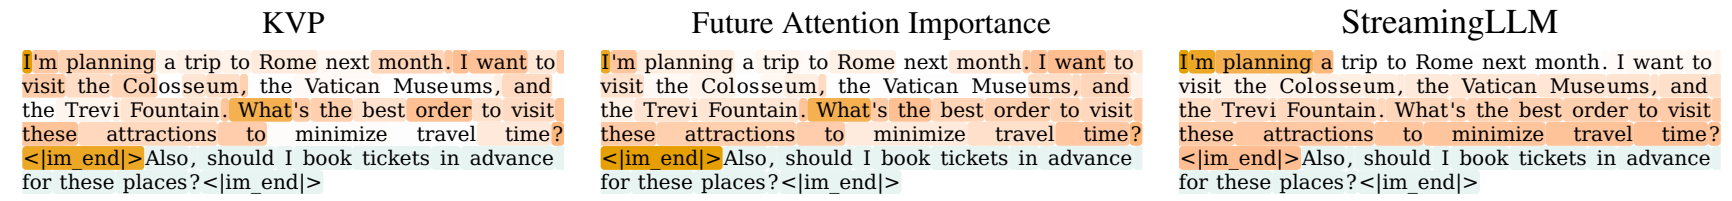
已有淘汰策略利用位置、历史注意力或键向量特征,KVP则学习预测未来效用。图1以旅行对话比较KVP、基于实际未来注意力的理想参照和StreamingLLM。未来注意力是事后计算的训练参考,并不意味着部署时的模型能够预先看到未来问题。
先学习排序,再按容量截取
KVP给所有缓存token打分;预算为b时,保留排名最高的b项。同一排序可以用于500、1,000等不同容量。目标函数综合考虑各个预算下被删除token的未来注意力重要度,而不是只针对某一个容量学习保留或删除。
在论文采用的可加效用定义下,按未来重要度排列可得到适用于多个预算的最优顺序。但这种性质针对的是代理目标,不是对任何问题的答案准确率都最优的证明。token间相互作用及生成质量,不能完全由注意力数值相加表示。
逐层、逐KV头的小型策略网络
策略输入为token的键向量、值向量和原始位置。部署时无需查询向量,也不需要完整注意力矩阵。每层每个KV头各有一个小型多层感知机。主要Qwen2.5-7B配置包含28层、每层4个KV头,共112个策略网络,每个约65万参数。
推理时读取当前K、V及位置,计算得分,按预算保留排名靠前的条目,再使用保留后的缓存继续注意力计算。实验实现始终保留最初4个及最后16个token。各头分配相同缓存容量;学习不同头之间的不均匀预算分配,不是本实验的内容。
用未来注意力训练,部署时只看当前缓存
首先运行基础语言模型,收集Q、K、V轨迹。后续查询对先前键的注意力可用于构造未来效用信号。此后策略更新可直接基于这些记录计算奖励,无需每次重新运行整个大模型;前期收集轨迹的成本并未消失。
策略得分定义Plackett–Luce排序分布,加入Gumbel噪声后排序,即可并行抽取多个候选顺序。训练采用REINFORCE与RLOO,以其他排序样本的奖励作为留一基线。跨预算奖励同时兼顾较小和较大容量。未来信息仅用于离线训练目标,实际部署决策只使用已经缓存的特征。
实验流程与比较条件
主模型为Qwen2.5-7B,策略在约4K token的RULER序列或OASST2对话上训练。比较方法包括StreamingLLM、TOVA、SnapKV、LagKV、KeyDiff和K-Norm;附录还报告Phi-4-14B结果。不同训练分布应分别评价,不能预设其效果相同。
短上下文实验在预填充即初始输入处理后压缩一次缓存,再生成响应;长输入按块处理,并结合此前保留的条目。部分短上下文测试通过注意力掩码模拟淘汰,长上下文测试则实际压缩KV张量。因此,准确率改善不能直接换算为适用于所有实现的显存或延迟节省比例。
短上下文结果要区分指标方向
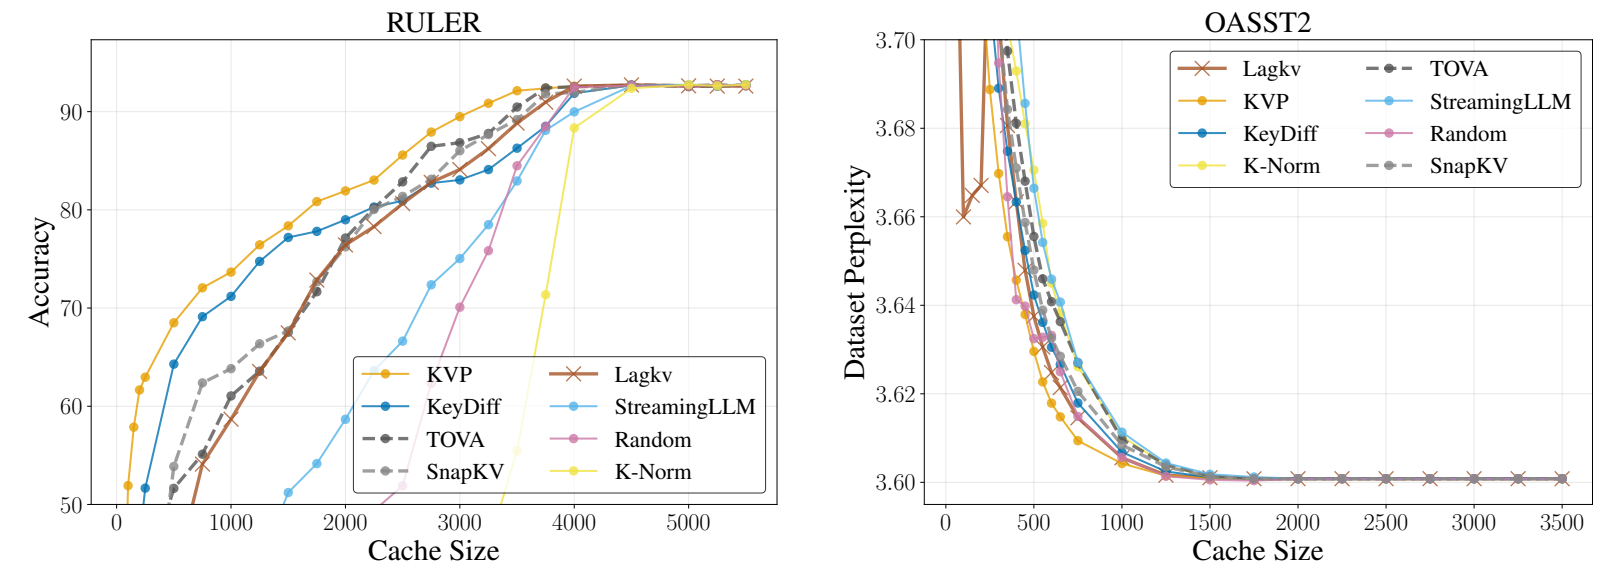
图2横轴Cache Size表示保留token数。RULER准确率越高越好,OASST2困惑度则越低越好。KVP在较宽容量范围内表现较好;当缓存充足时,不同方法的差距趋于缩小。
在OASST2的极小预算下,LagKV可能更优。结果支持的是所测条件下较好的质量与容量权衡,而不是KVP在任何预算、任何任务中都胜出。
从约4K训练迁移到128K输入
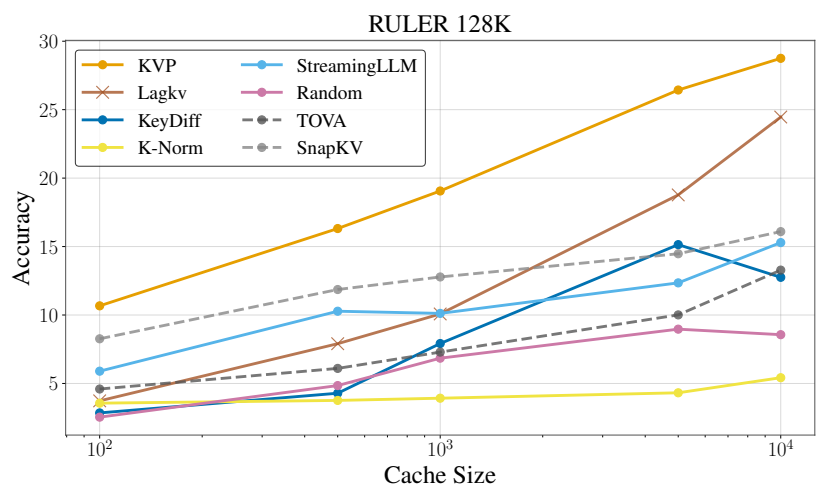
图3把约4K上下文上训练的策略用于RULER-128K。在展示的预算范围内,KVP均高于图中比较基线,表明学到的排序有机会适用于更长输入。
但还要看绝对准确率:缓存为10,000时,图中读数约为29%。这是图表近似值,并不意味着几乎完整记住128K文档。该实验展示压缩条件下的相对改善,不能据此宣称信息损失已经消除。
训练数据决定哪些信息更值得保留
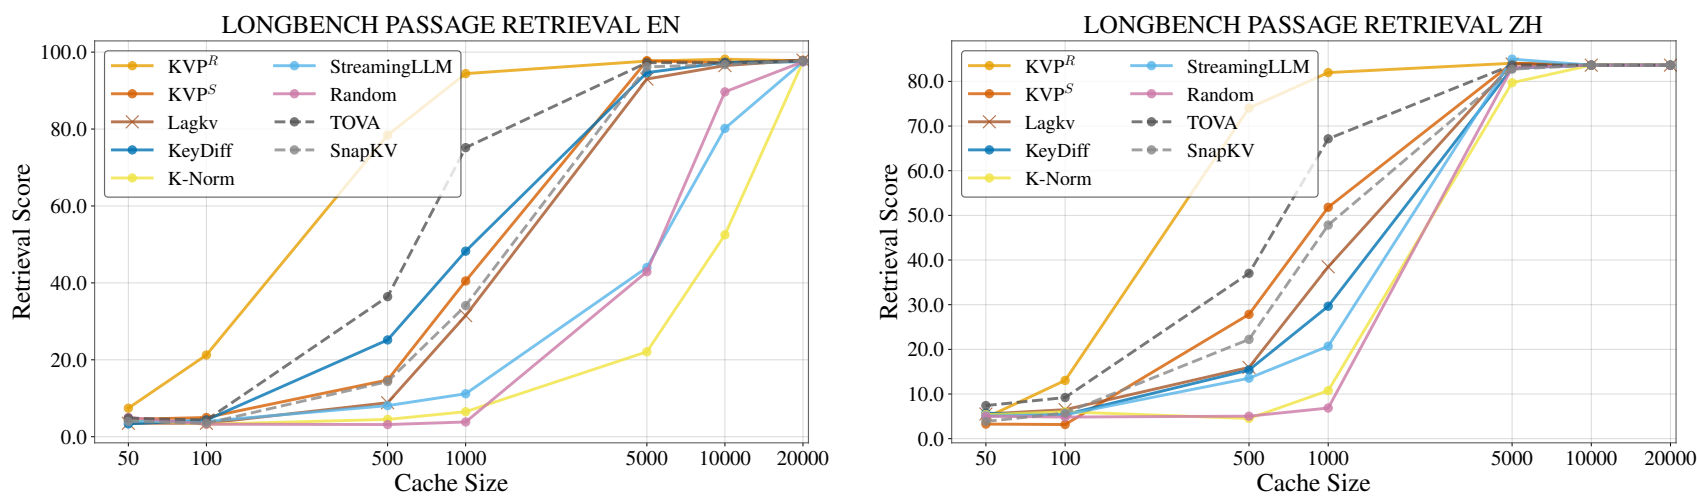
图5比较RULER训练的KVPᴿ与OASST2训练的KVPˢ,在LongBench英文、中文段落检索中的表现。小预算下KVPᴿ尤其占优。英文图中缓存约1,000时,KVPᴿ准确率在90%以上,而KVPˢ约40%;这些数字是对图表的近似读取。
论文中的BoolQ和GovReport评估则更适合对话数据训练的策略。检索辅助、长对话、摘要任务可能需要不同保留重点。实际采用时,应同时检验目标业务所需线索是否保留,以及质量、内存使用和延迟。
目标函数消融实验的含义
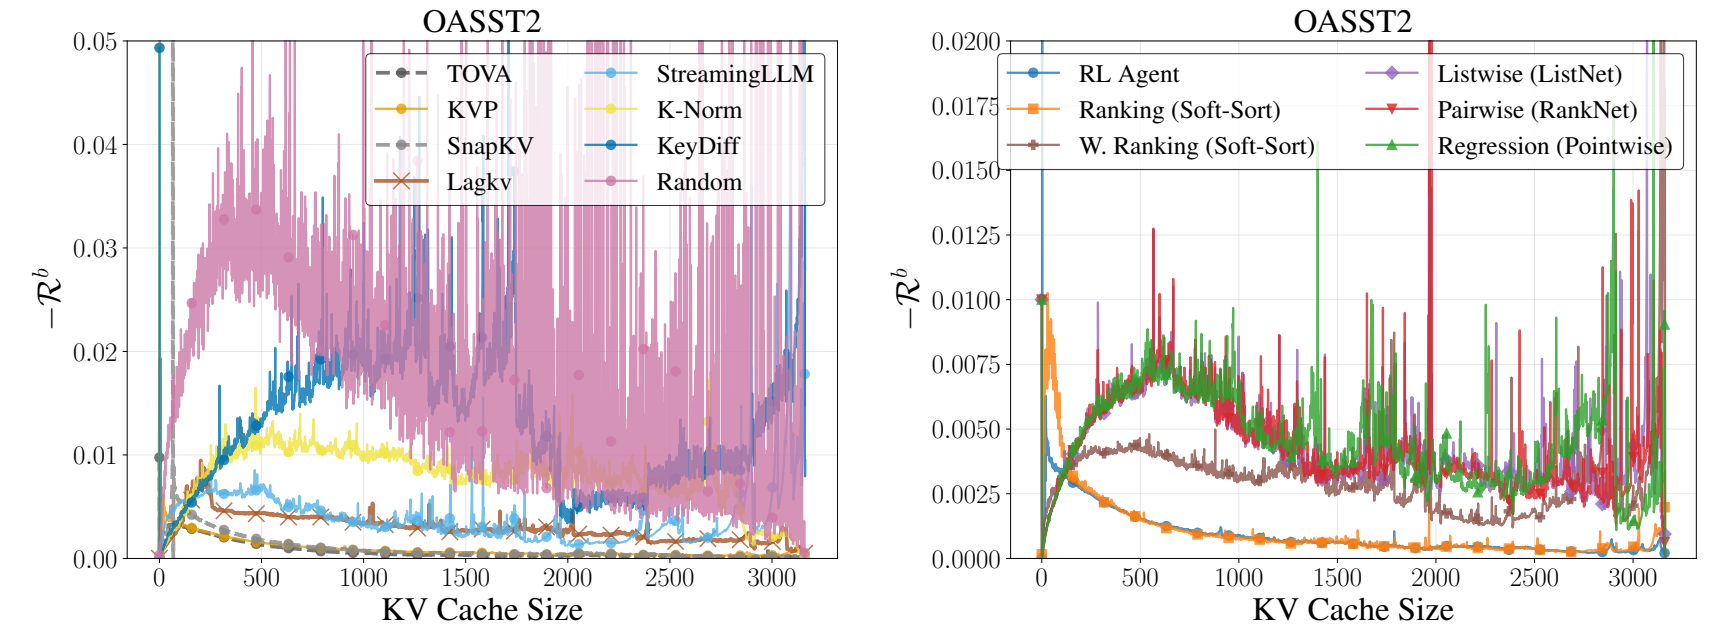
图6比较回归、成对排序、列表排序与强化学习。纵轴不是准确率,而是奖励的负值,即各排名token对归一化训练成本的贡献,越低越好。如果只重视少数高注意力token,剩余token之间的顺序可能学得不充分。
覆盖多种预算的奖励有助于处理这一问题。不过,无权重SoftSort在最小容量以外也很有竞争力。该消融针对OASST2、第10层、第0个KV头,不能推论强化学习对所有模型、所有头都是唯一正确的目标。
选择开销小,不等于整体服务快数百倍
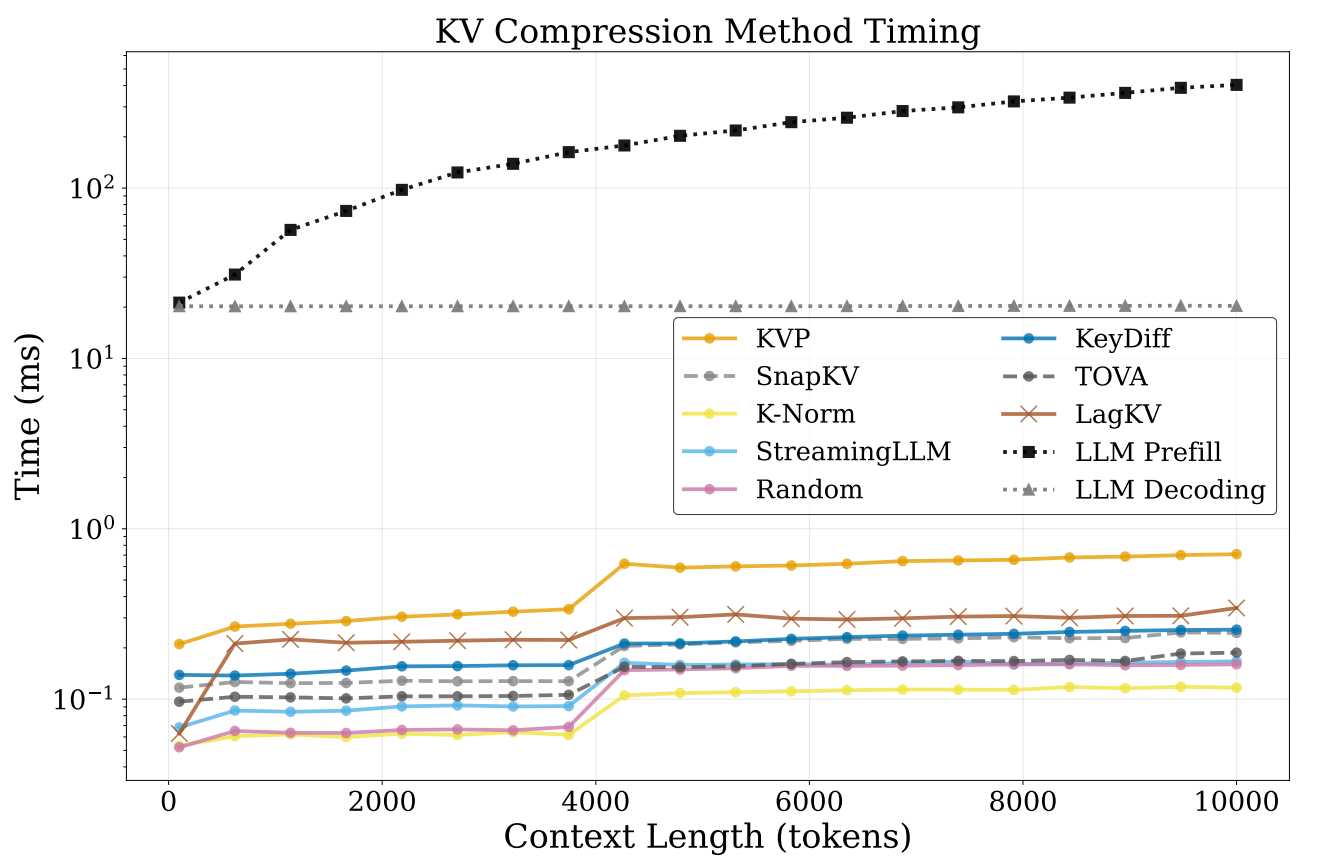
图7在NVIDIA B200上测量单个KV缓存的重要度计算与选择索引计算,以整个模型的预填充、解码时间作参考线。TOVA和SnapKV重新计算注意力分数的成本未计入。10,000 token条件下,KVP选择约0.71毫秒,整个模型预填充约404毫秒。
两者测量范围不同,不能将其比值宣传为整体服务加速数百倍。按参数量估算,纳入112个策略后,每token计算量从约14增加到14.15 GFLOPs,增量约1%。这属于理论运算量,不是实测延迟或内存只增加1%;论文也未给出充分优化后的端到端服务对比。
准备成本与尚未解决的问题
OASST2轨迹收集示例涉及4,649段对话,使用7个各含8块GPU的节点,产生约1.2 TB记录。文中在一个8块H100节点上训练单个策略不足30分钟,不是112个策略全部收集加训练的总时长。
未来注意力仍是代理目标;逐层逐头独立学习未充分建模相互作用,策略也依赖训练数据分布。验证主要围绕预填充阶段的压缩,尚不能据此确认在极长连续生成中持续淘汰缓存也同样可靠。
从专利实务角度看技术组合
技术问题是将不断增长的KV缓存控制在有限容量内,同时减少后续推理所需信息的损失。应整体理解逐层逐头的K、V、位置策略网络、跨预算共享排序、综合淘汰损失的奖励以及预收集轨迹的离线训练,如何共同产生所述技术效果。
值得关注的是,训练目标利用未来参照信息,而部署时只依赖当前缓存特征。已验证效果限于特定条件下的质量改善、向长上下文迁移及较小选择开销;这些本身并不证明可专利性、专利授权或权利保护范围。评价KVP时,应同时看到其潜力及对数据、目标函数和评估条件的依赖。