
Статья и предмет разбора
Корейский патентный поверенный Ён Док Ким анализирует Learning to Evict from Key-Value Cache, подготовленную Luca Moschella, Laura Manduchi и Ozan Sener из Apple. За основу взята версия ICML 2026: Proceedings of the 43rd International Conference on Machine Learning, PMLR 306:90470–90496. Ким — автор этого комментария, а не исследовательской статьи.
Идентификатор arXiv — 2602.10238, первая публикация датирована 10 февраля 2026 года, версия v2 — 26 июня 2026 года. DOI 10.48550/arXiv.2602.10238 относится к записи arXiv, а не обозначает отдельный DOI PMLR. Идея KVP состоит в обучении приоритетов сохранения элементов каждого KV-кэша с учётом будущей полезности при разных ограничениях памяти.
Почему сокращать кэш непросто
Transformer сохраняет ключи и значения предыдущих токенов, чтобы не пересчитывать их при обработке каждого нового токена. KV-кэш растёт с длиной контекста. Его сокращение может удалить подсказку, которая понадобится в последующем вопросе. Как с документами на небольшом столе, недавно использованный материал не обязательно окажется самым полезным дальше.
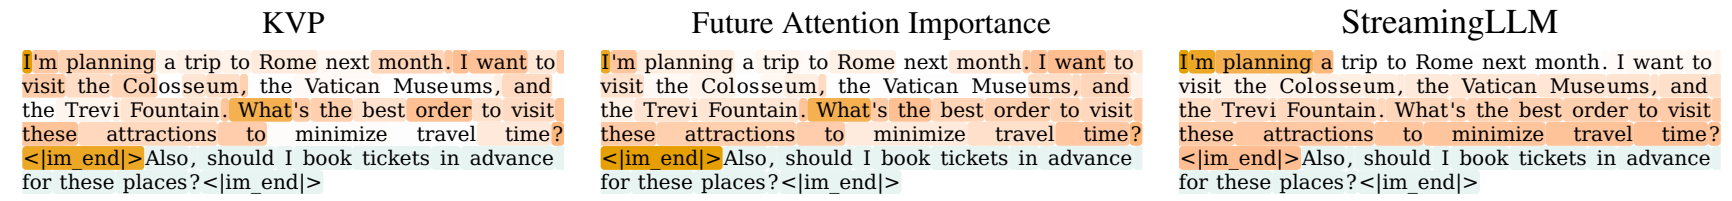
Обычные стратегии вытеснения используют позиции, прошлое внимание или свойства ключей. KVP учится прогнозировать будущую полезность. Рисунок 1 сравнивает выделенные токены диалога о путешествии для KVP, эталона на основе фактического будущего внимания и StreamingLLM. Эталон рассчитывается ретроспективно для обучения: при применении политика не видит будущих вопросов.
Сначала ранжирование, затем выбор размера
KVP оценивает все элементы кэша и при бюджете b сохраняет b позиций с наивысшим приоритетом. Один порядок подходит, например, для 500 и 1 000 элементов. Цель обучения объединяет будущую важность удалённых токенов при разных бюджетах, а не сводится к бинарному решению для одной ёмкости.
При принятой в статье аддитивной полезности сортировка по будущей важности даёт общий оптимальный порядок для этого суррогатного критерия. Это не доказывает максимальную точность ответа на любой вопрос. Взаимодействие токенов и качество текста не исчерпываются суммой значений внимания.
Небольшая политика для каждого слоя и KV-головы
На вход подаются ключ, значение и исходная позиция токена. При применении не нужны ни вектор запроса, ни полная матрица внимания. Для каждого слоя и KV-головы используется небольшой многослойный перцептрон. В основном варианте Qwen2.5-7B имеются 28 слоёв по четыре KV-головы: всего 112 политик примерно по 650 тысяч параметров.
При инференсе читаются текущие K, V и позиции, вычисляются оценки, отбираются лучшие элементы в пределах бюджета, и внимание продолжает работать с оставшимся кэшем. В экспериментах всегда сохраняются первые четыре и последние шестнадцать токенов. Бюджет одинаков для всех голов; обучение неравномерному распределению ёмкости здесь не исследуется.
Офлайн-обучение на будущем внимании
Сначала запускают базовую модель и собирают трассы запросов, ключей и значений. Внимание последующих запросов к более ранним ключам даёт сигнал будущей полезности. Затем по этим данным можно вычислять вознаграждение без повторного запуска всей языковой модели на каждом шаге обновления политики. Первоначальный сбор трасс при этом не становится бесплатным.
Оценки задают распределение Plackett–Luce по перестановкам. Добавление шума Гумбеля и сортировка позволяют параллельно выбирать несколько вариантов ранжирования. Политики обновляются методом REINFORCE с базовой оценкой RLOO по вознаграждениям остальных вариантов. Вознаграждение учитывает потери при малых и больших бюджетах. Будущая информация используется только для обучающей цели, а рабочее решение — только из уже имеющихся признаков кэша.
Условия экспериментов
Основная модель — Qwen2.5-7B; политики обучаются на последовательностях RULER либо диалогах OASST2 длиной около 4K токенов. Среди сравнений — StreamingLLM, TOVA, SnapKV, LagKV, KeyDiff и K-Norm; в приложении есть результаты Phi-4-14B. Результаты разных обучающих распределений необходимо рассматривать отдельно.
Для короткого контекста кэш сжимается один раз после prefill — первичной обработки входа, — затем генерируется ответ. Длинный вход обрабатывается блоками с ранее сохранёнными элементами. Некоторые короткие тесты имитируют вытеснение масками внимания; длинные физически уплотняют KV-тензоры. Поэтому рост точности нельзя напрямую превращать в универсальный процент экономии памяти или задержки.
Результаты на коротком контексте
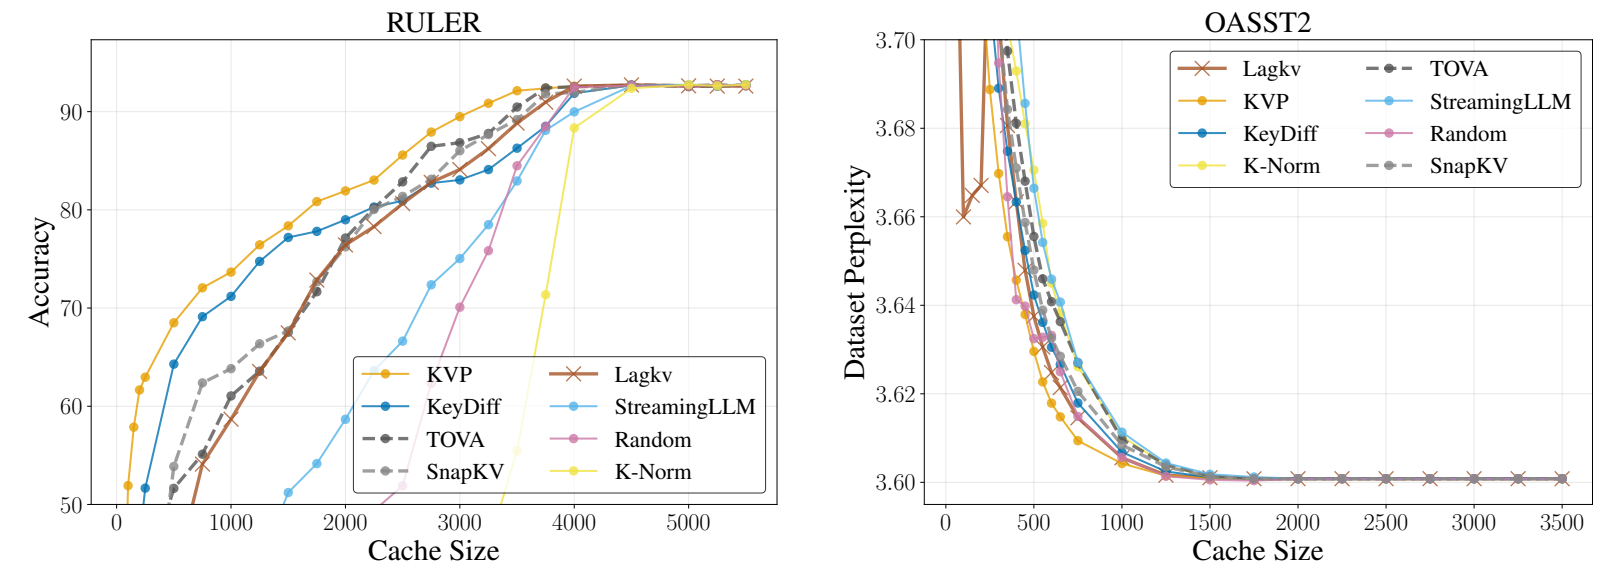
В рисунке 2 Cache Size — число сохранённых токенов. Для RULER лучше более высокая точность, для OASST2 — более низкая перплексия. KVP хорошо работает в широком диапазоне ёмкостей; при достаточном объёме кэша различия между методами уменьшаются.
При крайне малом бюджете на OASST2 LagKV иногда оказывается лучше. Исследование подтверждает удачное соотношение качества и ёмкости в проверенных условиях, но не превосходство KVP при любом размере кэша и на каждой задаче.
Перенос с обучения на 4K на вход 128K
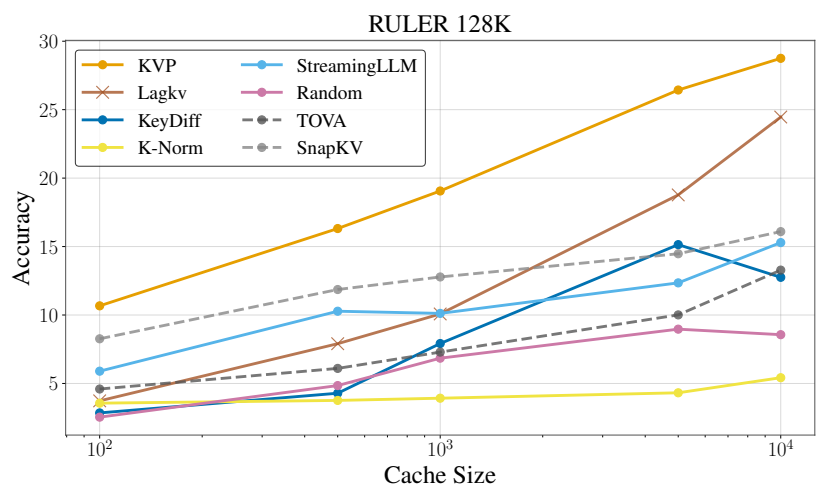
На рисунке 3 политика, обученная примерно на 4K токенов, применяется к RULER-128K. KVP опережает представленные базовые методы во всём показанном диапазоне бюджетов, что указывает на перенос ранжирования на значительно более длинный вход.
Однако важны и абсолютные значения: при кэше 10 000 точность по графику составляет около 29%. Это приблизительное считывание, а не почти полное запоминание документа длиной 128K. Речь идёт об относительном улучшении при сжатии, а не об устранении потери информации.
Обучающие данные меняют приоритеты
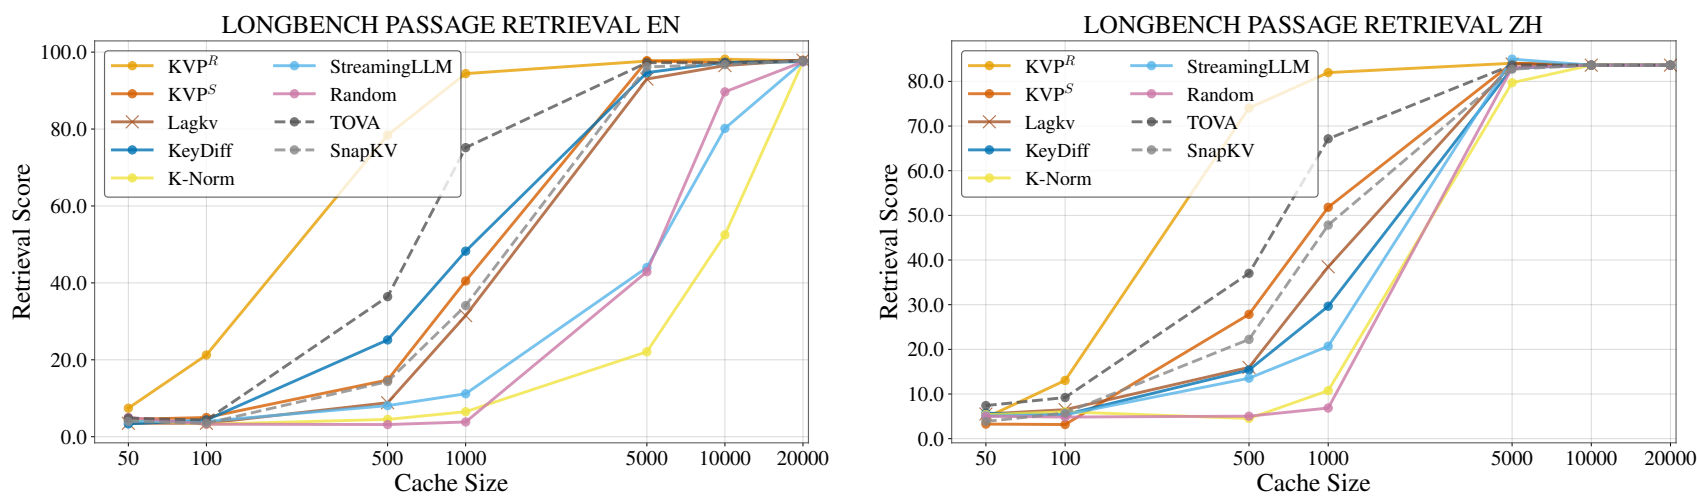
Рисунок 5 сопоставляет KVPᴿ, обученную на RULER, и KVPˢ, обученную на OASST2, в поиске фрагментов LongBench на английском и китайском языках. KVPᴿ особенно эффективна при малых бюджетах. На английском графике при примерно 1 000 элементах точность первой находится выше 90%, второй — около 40%; значения приблизительные.
Для BoolQ и GovReport в статье лучше подходит политика, обученная на диалогах. Поиск, продолжительный разговор и суммаризация могут требовать разных приоритетов. Перед внедрением следует проверить сохранность нужных рабочей задаче подсказок, качество, расход памяти и задержку.
Что показывает сравнение целей обучения
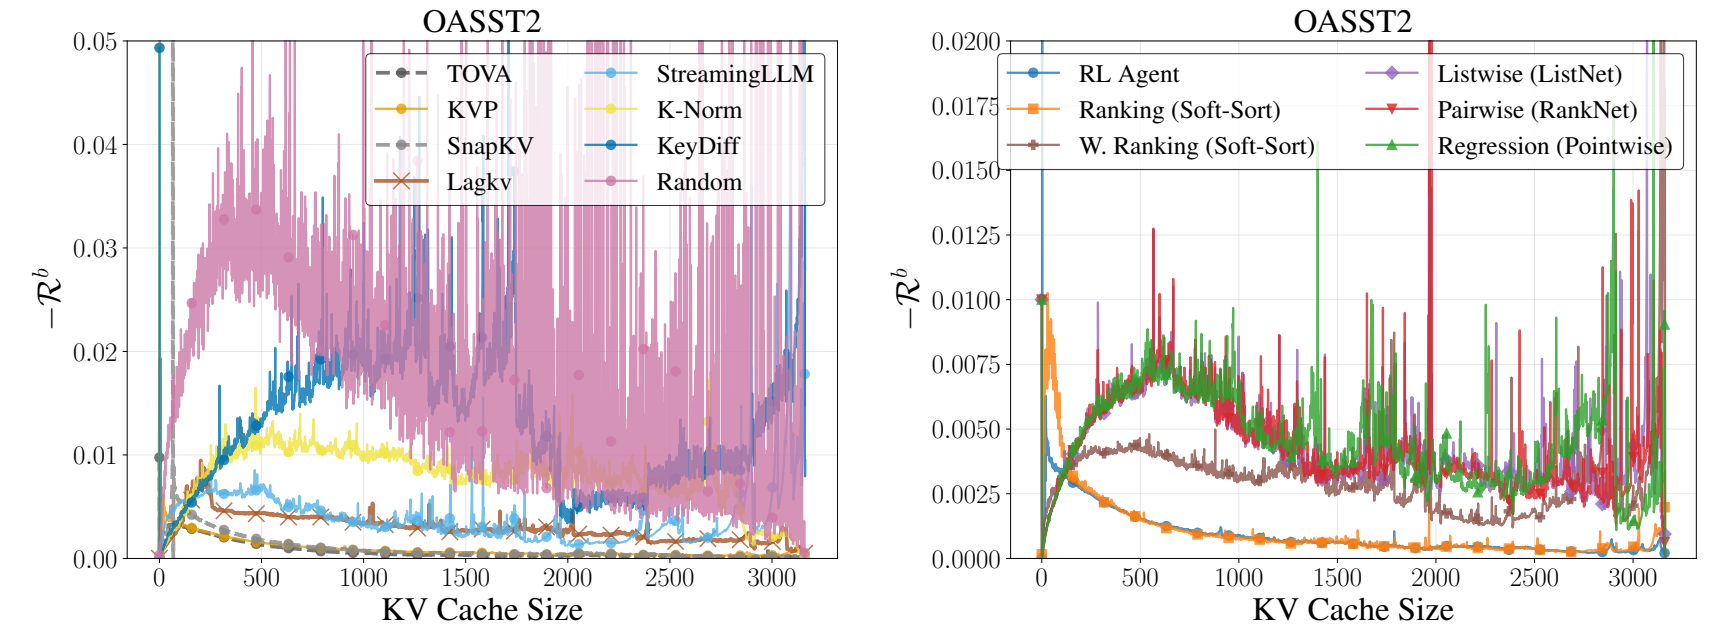
Рисунок 6 сравнивает регрессию, попарное и списочное ранжирование и обучение с подкреплением. По вертикали отложена не точность, а отрицательный вклад вознаграждения — нормированные затраты обучения для позиции токена, где меньше значит лучше. Фокус на нескольких токенах с большим вниманием может оставить порядок остальных недостаточно изученным.
Вознаграждение по разным бюджетам помогает решить эту проблему. При этом невзвешенный SoftSort конкурентоспособен вне самых малых ёмкостей. Проверка относится к OASST2, слою 10 и KV-голове 0; она не доказывает, что обучение с подкреплением — единственно верная цель для любой модели и головы.
Накладные расходы отбора — не ускорение всего сервиса
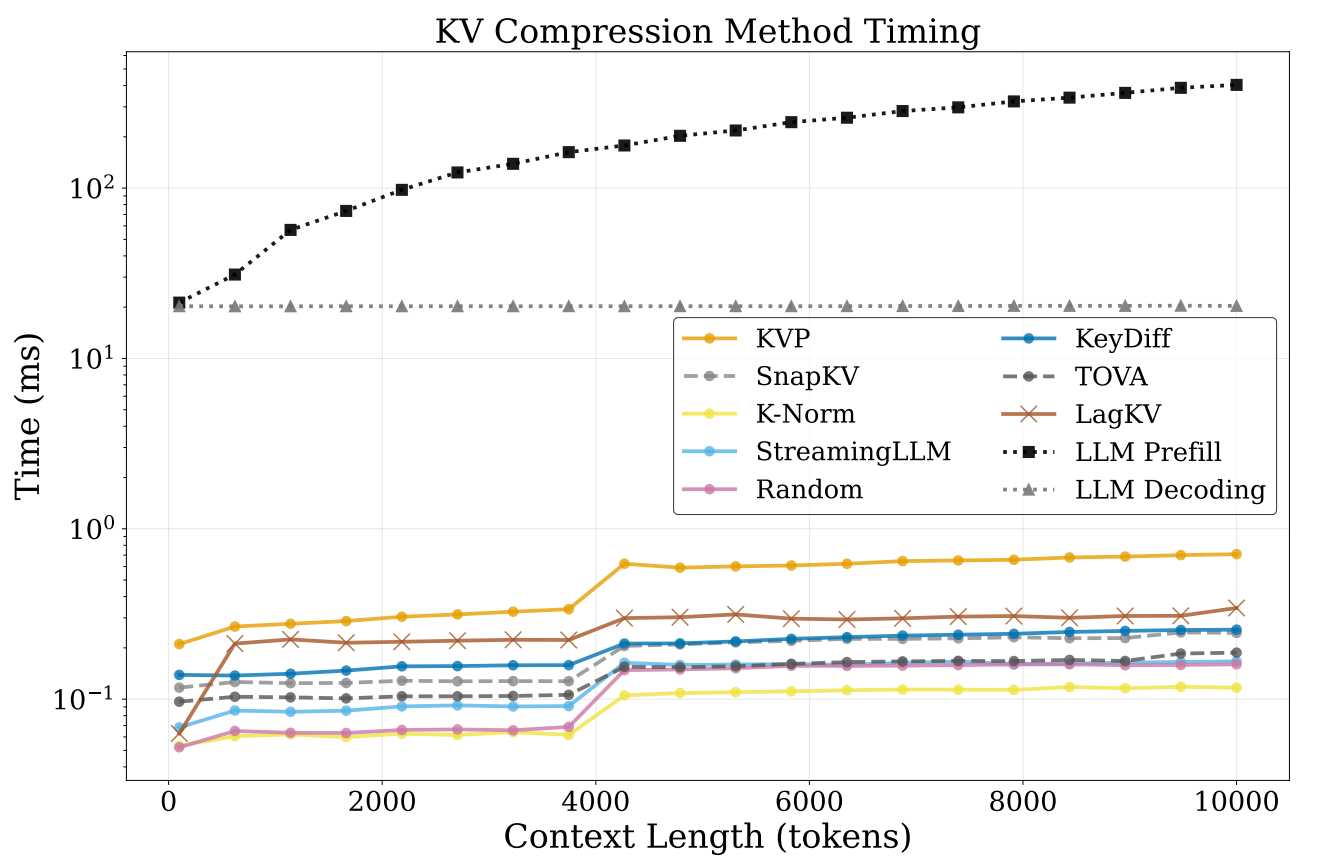
Рисунок 7 измеряет оценку важности и вычисление индексов отбора отдельных KV-кэшей на NVIDIA B200. Время prefill и декодирования полной модели дано для ориентира. Пересчёт внимания для TOVA и SnapKV не включён. При 10 000 токенов отбор KVP занимает около 0,71 мс, а полный prefill — около 404 мс.
Это разные операции, поэтому их отношение нельзя рекламировать как ускорение сервиса в сотни раз. Оценка по числу параметров со всеми 112 политиками увеличивает затраты примерно с 14 до 14,15 GFLOPs на токен — около 1%. Это теоретическое число операций, а не измеренное увеличение задержки или памяти на 1%. Полностью оптимизированного сквозного сравнения сервиса статья не даёт.
Стоимость подготовки и ограничения
В примере OASST2 сбор трасс охватывает 4 649 диалогов на семи узлах по восемь GPU и даёт около 1,2 ТБ данных. Обучение одной политики на узле с восемью H100 занимает менее 30 минут. Это не суммарное время сбора и обучения всех 112 политик.
Будущее внимание остаётся косвенной целью. Независимые политики слоёв и голов не полностью учитывают взаимодействия, а приоритеты зависят от обучающих данных. Проверка в основном касается сжатия вокруг prefill; надёжное непрерывное вытеснение при очень долгой генерации из этих результатов ещё не следует.
Техническое решение с позиции патентного анализа
Задача — удержать растущий KV-кэш в ограниченной памяти и уменьшить потерю информации для последующего инференса. Существенна взаимосвязь политики по K, V и позиции для каждого слоя и головы, общего порядка для разных бюджетов, объединённого вознаграждения за потери и офлайн-обучения на заранее собранных трассах.
Особенно показательно разделение: будущие обращения определяют обучающие цели, но при применении используются только текущие признаки кэша. Подтверждены улучшения качества при заданных бюджетах, перенос на длинный контекст и ограниченные расходы отбора в конкретных условиях. Сами по себе они не устанавливают патентоспособность, выдачу патента или объём охраны. Возможности KVP следует оценивать вместе с зависимостью от данных, цели обучения и условий проверки.
Публикационные сведения и полный текст
Иллюстрации: CC BY 4.0; исходное содержание сохранено, формат преобразован для веб-показа