
著者:IPLEX 知的財産権法律事務所 金容德, 弁理士
問題の性質は、AIエージェントが「正しい回答を試す」ではなく、「あなたが望む情報を見つけるためにウェブサイトをナビゲートするために、必要なボタンを押して、それが失敗した場合、パスを修正する」とは完全に異なります。 これは、単一の応答で終わらないが、むしろ複数の行動、観察、および判断を含むためです。 このプロセス中に、エージェントは間違ったボタンを押し、同じアクションを繰り返したり、初期にあまり諦めないことがあります。
.
AgentGym-RL は、このマルチターンの決定問題を正確にターゲットにしています。 研究者は、環境、エージェント、学習アルゴリズムを分離し、ScalingInter-RLと組み合わせた統合強化学習フレームワークを提案し、学習の始まりに簡単に相互作用の数を制限し、徐々にそれらを増加させます。 論文のコアメッセージはシンプルです。 エージェントを最初から長いアクションの自由を与えるよりもむしろ、エージェントが短いタスクで基本を学習し、アクションのスコープを拡大できるように、より安定しているかもしれません。
1つの文要。 AgentGym-RL は、さまざまな現実環境でオンラインの強化学習を通じて LLM エージェントを訓練する統合フレームワークであり、ScalingInter-RL は、対話の最大数を徐々に増加させることにより、初期学習のデケイを削減しながら、長期的な探査能力を向上させる方法です。
1。 1。 3分で紙を理解する
まず、問題の開始点は、既存のLLM強化学習が単一の応答タスクに焦点を合わせることであり、複数のアクションや観察を必要とするエージェントタスクでは、環境の多様性、学習の安定性、長期間のやり取りサポートが欠けています。
これを解決するために、AgentGym-RL は、環境、エージェント、トレーニングを分離し、Web、検索、ゲーム、エンボディ、科学的な環境を標準化されたサーバー指向構造と並列ロールアウトを介して 1 つの学習パイプラインに接続します。
ScalingInter-RLは学習面では、初期の最小限のインタラクション数を設定し、学習フェーズが進行するにつれて許可される数が増えます。 身近な行動を確実に学習し、より長い探査を可能にするカリキュラム。
実験結果を見ると、論文の7BモデルはBabyAI 96.67、TextCraft 91.00、SciWorld 57.00、WebArena 26.00、Deep Search 38.25を記録しました。 しかし、すべてのタスクで商用モデルを打ち破らず、各タスクの優位性と劣性が異なっていた。
しかし、一般化は、主に同じシリーズ環境で検証され、物理的な現実環境とマルチエージェント学習は将来のタスクとして残っています。 手続き上の誤りや過度の相互作用は、いくつかの科学的課題とWebナビゲーションで一貫して観察された。
2。 最初に知る主な用語
LLMエージェントは、言語モデルが単に文章を生成しないシステムであり、ツールを呼び出し、環境を観察し、複数のステップのアクションを選択します。
マルチターン強化学習は、単一の回答ではなく、複数のアクションと観察から成る全ての軌跡に基づいて方策を更新する学習です。
インタラクション horizon は、エージェントが 1 つのエピソードで環境と相互作用できる最大回数です。 理解の容易さのために、この記事は、アクションまたはインタラクションの長さの最大数としてそれを参照します。
探索は新しい行動経路を試すこと、活用は有効であると学習した行動を繰り返すことを意味します。この二つのバランスは、強化学習の安定性に直接関わります。
ロールアウトは、アクション、観察、報酬から成る軌跡を収集するために、現在のポリシーでエージェントを実際の環境に置くプロセスです。
POMDPは、エージェントが直接環境の状態を見ない決定モデルで、いくつかの観察に基づいて次のアクションを決定しなければならない。 ウェブページやゲーム画面のステップを一歩ずつ見ている状況によく機能します。
GRPOは、同じタスクで複数の軌跡を生成し、グループ内の相対的なパフォーマンスを使用して方策を更新する強化学習方法です。
重要な表現のまとめ。 論文の中の「SFTなしの傷から学ぶ」は、ランダムな初期化で言語モデル自体をプリトレインするという意味ではありません。 Qwen2.5シリーズの事前学習や指導学習モデルをスタート地点として捉え、エージェントの作業のエキスパートの軌跡を使用してマップをファインチューニングすることなく、環境報酬を使用してエージェントの行動を学習することがより正確です。
3。 既存のAIエージェントの強化学習が難しいのはなぜですか?
3.1 シングルレスポンス強化学習とマルチターンエージェント学習の違い
数学の問題やコードの問題など、一度に回答を提出するタスクでは、最終的な正しい回答の正確さのためにのみ報酬を受けることができます。 一方、Web閲覧や科学実験では、中間操作はチェーン内の次の状態を変更します。 ワンクリックで、その後の観察全体を変更したり、初期のアクションの影響が数回後に現れます。 これは、長期の軌跡を上回る成功に貢献した行動を決定するために、クレジットを割り当てる問題が増加します。
インタラクションの数が増えると、アクションの実行可能なパスが増加します。 十分に探していない場合は、簡単なショートカットを繰り返すだけ、そして逆に、最初からあまりにも多くの探査を許可すると、学習は無意味な行動と高分散のために崩壊するかもしれません。 論文は、これら2つの極端を、それぞれ、長い固定地平線のための短い固定地平線と学習の崩壊のためのパフォーマンスの上部の境界として観察します。
3.2 統合フレームワークがなければ、実験自体は困難です
各環境には、異なる動作コマンド、観察形式、リセット方法、報酬計算があります。 ウェブブラウザはタブとボタンを扱い、TextCraft はコマンドを制作し、BabyAI は空間の動きとドア操作を実行します。 SciWorldは、温度測定、接続回路、混合化学物質などの手続きを行う必要があります。 それらを単一の強化学習コードに接続するには、環境インタフェース、並列実行、エラー回復、およびリソース組織は標準化されなければなりません。
AgentGym-RL は、研究のアイデアだけでなく、長期的なロールアウト中に発生するボトルネックをエンジニアリングするだけでなく、対処します。 論文は、WebArenaのマルチブラウザの実行、SciWorldの並列初期化、TextCraftとSciWorldのメモリリーク、およびエピソードの最後に完全な初期化など、問題が修正されたことを説明しています。 長期的エージェント学習では、アルゴリズム自体として、このシステム安定性が重要である。
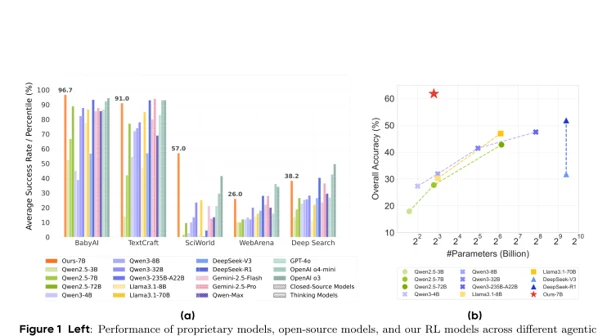
図1. 論文の図1:モデルサイズで5つのエージェントタスクと全体的な精度のパフォーマンスの比較。 出典:西ら。、p。 2。
図1の左側は5つの環境のそれぞれの性能を示し、右側はモデルパラメータスケールと全体的な精度の関係を示しています。 論文は、7Bスケールの強化学習モデルは、より大きなオープンソースモデルと競争し、一部の環境では、商用モデルよりも高いスコアを強調しています。 ただし、右上のグラフの1点から実際の全ての能力を一般化することは不可能であり、各ベンチマークの評価方法とタスク構成が異なることが確認される必要があります。
4。 AgentGym-RLフレームワークはどのように構築されていますか?
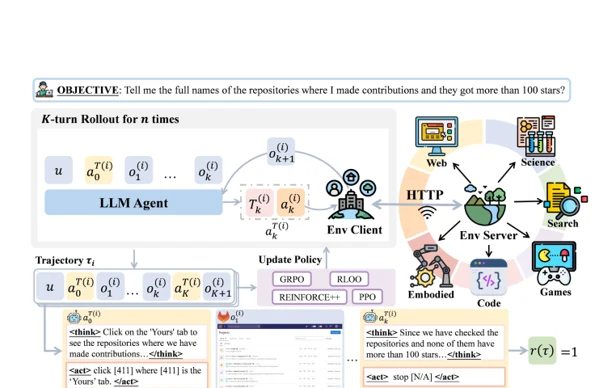
図2. ペーパー図2:AgentGym-RLの全体的な構造は環境、代理店および訓練モジュールに分けました。 出典:西ら。、p。 3。
4.1 環境モジュール
環境は独立したサーバーとしてパッケージ化され、エージェントは観察を要求し、利用可能なアクションをチェックし、アクションを実行し、HTTPベースのクライアント経由でリセットします。 この構造の利点は、Web環境、検索環境、ゲーム環境が異なる内部実装を持っている場合でも、エージェントと学習モジュールは、一般的なインタフェースを介してアクセスすることができます。
論文に含まれる5つのシナリオは次のとおりです。 WebArenaは現実的なWebナビゲーションのために、Deep Searchは、検索エンジンを使用してマルチレベルの情報探査のために、TextCraftはテキストベースのクラフトゲーム、BabyAIはグリッド世界でエンボディされたタスクのためであり、SciWorldは科学実験と手順を実行しています。
4.2 エージェントモジュール
エージェントモジュールは、観察を要する反復ループをカプセル化し、推論を行い、次のアクションを生成します。 戦略、サンプリング設定、リワード機能、および長期計画や自己反射などのメカニズムが拡張可能であるように設計されている。 キーは、特定の環境の詳細な実装から、エージェントの推論ロジックを分離することです。
4.3 トレーニングモジュール
Trainingモジュールは、並列環境で収集した軌跡をバッチにまとめ、対数確率と参照モデルの確率を計算し、アドバンテージの推定と方策の更新を行います。論文では、オンライン強化学習アルゴリズムとしてPPO・GRPO・RLOO・REINFORCE++を、補助的な学習方法としてSFT・DPO・棄却サンプリングをサポートすると説明しています。
1。 1。 複数の割り当てと環境クライアントを同時に初期化します。
2。 各エージェントは、現在の観察に基づいてアクションを生成します。
3。 環境はアクションをトリガーし、新しい観察と報酬を返します。
4。 エピソードが終わるまで、アクションや観察を軌跡として保存します。
5。 5。 収集した軌跡から利益を計算し、ポリシーパラメータを更新します。
6。 。 環境を初期状態にリセットし、次のロールアウトを繰り返します。
簡単なアナログ:運転学校。 環境は、道路や信号システムに似ています。エージェントは、研修生の運転に似ています。そして、トレーニングは、運転記録を見て次のレッスンプランを変更するコーチに近づいています。 生徒やコーチとは別々に道を保つことで、新しい道、異なる学生モデルを追加したり、卒業を変更したりすれば、システム全体を再構築する必要はありません。
5。 5。 重要な提案:ScalingInter-RLは、ステップバイステップのアクション数を増加させます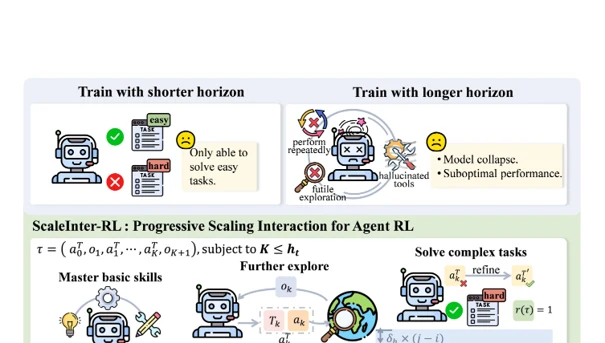
図3。 ペーパー図5:スケーリングInter-RLは、短い地平線で基本を学び、長い地平線に拡大します。 出典:西ら。、p。 8月8日
5.1 なぜ最初から長い相互作用を許可しない
エージェントに環境の基本的なルールをまだ知らずに初期段階で多くのアクションを与えると、それらの余分な計算が有用な探査につながるという保証はありません。 同じボタンを繰り返し押すか、既に閲覧したページ間に戻り、タスクに関連しないツールを呼び出します。 この軌跡は、報酬分散とクレジット配分の難しさを増加させ、方策の更新を不安定にする。
逆に、アクションの数が継続的に固定されている場合、安定した複雑なタスクを解決する十分な機会があります。 エージェントは、成功への簡単なパスにのみ適応し、計画、反射、およびバックトラッキングなどの長期的な行動パターンを学習できないことがあります。
5.2 グラデーション・ホライゾン拡張
ScalingInter-RLは、単調にh1、h2、h3としてインタラクションの最大数を増加させるカリキュラムを使用しています。 初期段階では、小さなやりとり予算で、基本的な行動の効率的な使用を可能にし、特定の学習期間の後、長いナビゲーションパスを可能にするために、ターンの最大数が増加します。
1。 1。 初期段階:簡単なタスクと基本的なツールの使用を短い地平線で確実に学習できます。
2。 中間段階: 障害、再発、およびさらなる回復を経験する相互作用の数を増加して下さい。
3。 後段:長い地平線で計画、反射、戦略的なバックトラックなどの複雑な動作を強化します。
4。 各ステージのロールアウトは、現在のポリシーによって生成されるため、タスクの難易度と検索スペースは、エージェントの能力が成長するにつれて拡大します。
特許の観点からは、広い意味でのカリキュラム学習は既知の概念である可能性が高いと考えられます。請求項では、難易度の調整という表現にとどまらず、オンポリシーのマルチターン・ロールアウトにおける最大対話回数を段階的に制限し、報酬に基づく方策更新と組み合わせて学習の崩壊を抑える具体的な制御構造に着目することが有用です。
6。 。 主要な学習曲線ショー:長いターンは高速ですが、ダウンすることができます
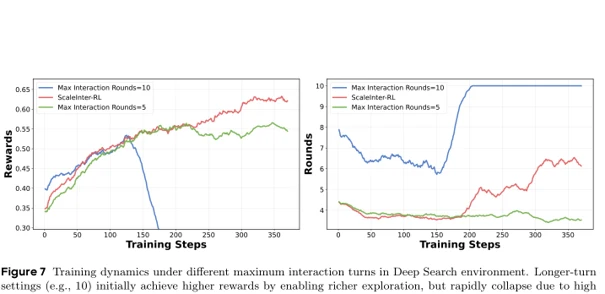
図4. 論文の図7: 報酬の比較と、固定10ターン、固定5ターン、および深層検索におけるScalingInter-RLの相互作用の実際の数。 出典:西ら。、p。 12月12日
左のグラフでは、スタートから最大10回転できる設定で、素早く上昇する初期報酬が得られるが、150回程度の学習手順ですぐに崩壊する。 最大5ターンの設定は比較的安定していますが、後続のパフォーマンスは停滞します。 ScalingInter-RLは、初期に短いインタラクションを維持し、徐々にターン数を増加させ、最終的に最高報酬に達します。
右側のグラフは、使用したインタラクションの実際の数を示します。 ScalingInter-RL は、最初は 4 ターン前後で 6 ターン以上増加します。 言い換えれば、大きな最終的な地平線を持つだけでなく、エージェントの学習状態に応じて探査の自由を順次付与する構造です。
論文が示す技術的効果は、初期段階から長いホライズンを探索することで生じる高い分散、誤った行動の蓄積、不適切なツール呼出し、反復的な行動を抑えながら、後半では複雑な課題の解決に必要な対話回数を確保することです。論文では、探索と活用のバランス、学習の安定性、計算効率の改善として説明されています。
7。 実験が実施された環境は?
実験環境は、ウェブ閲覧から科学的な手順まで、さまざまな5種類で構成されます。 各環境は、エージェントが複数の回行動し、次のアクションを選択するためのフィードバックを受け取る必要があると共通していますが、それらを評価する能力は異なります。
WebArenaは、ショッピング、フォーラム、GitLab、マップ、およびCMSを横断するボタンクリック、検索、およびページナビゲーションを通じて目標を達成する能力を評価するWebナビゲーションシナリオです。
Deep Searchは、検索エンジンを繰り返し、複数のソースから情報を組み合わせて質問に答える機能を評価するディープ検索シナリオです。
TextCraft は、マテリアルを収集し、Minecraft のようなテキスト環境で複数のステップの工芸品を実行するための能力を評価するデジタルゲームシナリオです。
BabyAIは、ドアを開けたり、周りを移動したり、ターゲットオブジェクトをグリッドの世界で到達したりする能力を評価する、エンボディされたチャレンジシナリオです。
SciWorldは、測定温度、試験導電性、有機物を見つけること、および操作材料などの手続き実験を行う能力を評価する科学的チャレンジシナリオです。
主要な骨はQwen2.5-3BおよびQwen2.5-7Bです。 比較対象は、GPT-4o、OpenAI o3、Gemini 2.5 Proなどの商用モデル、Qwen、Llama、DeepSeekなどのオープンソースモデルが含まれます。 評価図は、論文の選択したタスクセット、最大インタラクション数、サンプリング設定の結果であり、一般的な製品性能ランキングに直接変換されるべきではありません。
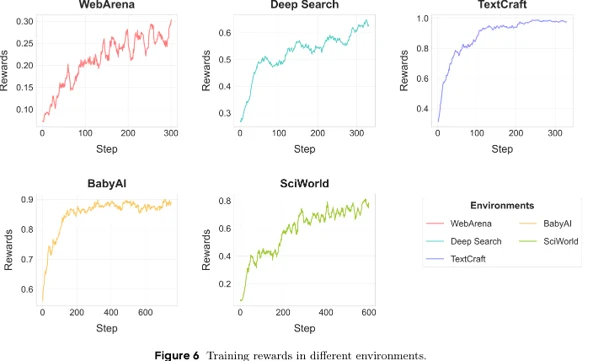
図5. ペーパー図6:WebArena、ディープ検索、TextCraft、BabyAI、SciWorldの報酬の傾向を学習します。 出典:西ら。、p。 10月10日
学習報酬曲線は、すべての5つの環境で上向きな傾向を示していますが、異なる形状です。 WebArenaとSciWorldが非常に揮発性している間、TextCraftとBabyAIは比較的迅速に高い報酬を受けます。 これは、明確な規則とフィードバックで閉鎖した環境にあるペーパーの解釈と並んでいます。それは、強化学習が成功パスを見つけるのが容易であり、そのノイズと行動空間は現実的なWebや複雑な科学的手順で大きくなります。
8月8日 誇張なしの重要な実験結果を読む
WebArena では、Qwen2.5-7B は 9.76 を記録しました。AgentGym-RL-7B は 22.00 を記録し、ScalingInter-7B は 26.00 を記録しました。 ScalingInter-7B は、ベースラインモデルを +16.24 の絶対スコアで上回りました。
ディープ検索では、Qwen2.5-7B が 18.75 を記録し、AgentGym-RL-7B が 34.00 を記録し、ScalingInter-7B が 38.25 を記録しました。 ScalingInter-7B は、絶対スコアで +19.50 のベースラインモデルを上回りました。
テキストクラフトでは、42.00を記録したQwen2.5-7B、AgentGym-RL-7Bは89.00を記録し、ScalingInter-7Bは91.00を記録しました。 ScalingInter-7B は、ベースラインモデルを +49.00 の絶対スコアで上回りました。
BabyAIでは、Qwen2.5-7Bが66.67を記録し、AgentGym-RL-7Bは92.22を記録し、ScalingInter-7Bは96.67を記録しました。 ScalingInter-7B は、ベースラインモデルを +30.00 の絶対スコアで上回りました。
SciWorldでは、Qwen2.5-7Bは1.50を記録し、AgentGym-RL-7Bは50.50を記録し、ScalingInter-7Bは57.00を記録しました。 ScalingInter-7Bは、絶対スコアで+55.50でベースラインモデルを抜いた。
上記の標準モデルは、論文に記述されているQwen2.5-7B-Instructです。 各環境で提示された改善は、ScalingInter-7Bとベースラインモデルの絶対的なスコアの違いです。 SciWorldとTextCraftで最大の改善が認められました。その両方とも比較的明確なルールと成功条件があり、試行錯誤による学習の強い信号が認められました。
8.1 WebArena: 商用モデルと競争力のある、しかし最高の
ScalingInter-7B は WebArena 全体で 26.00 を記録し、GPT-4o の 16.00 を超えると Gemini 2.5 Pro の 28.00 に近いです。 しかしながら、OpenAI o3の34.00とo4-miniの36.00の不足を抑えました。 特にGitLabとRedditサブタスクで、ギャップは残っています。 そのため、「7BモデルがWebArenaのすべての商用モデルを打ち破る」というステートメントは正確ではありません。
8.2 ディープ検索: 強力, o3 と同じくらい良いではありません
ScalingInter-7Bは38.25で、GPT-4o 26.75とGemini 2.5 Pro 36.50を超えるが、OpenAI o3 49.50とo4-mini 42.50よりも低い。 52.00でNQで最高スコアを記録し、70.00でTriviaQAで最高のスコアのために縛られたが、全体的な平均はトップの推論モデルとギャップを残しました。
8.3 テキストクラフトとBabyAI:長期行動学習の強み
TextCraftでは、ScalingInter-7BがGPT-4oの83.00を91.00に上回っていて、最も困難な深さ4でも33.33を記録したモデルの中にありました。 論文に比べ、全機種で96.67の最高スコアを記録しました。 これは、相互作用のエスカレーションは、明確な行動ルールと成功のための報酬を持つ環境で効果的に働くことができることを示しています。
8.4 SciWorld:最大の改善と最も明らかな制限が同時に現れます
SciWorldでは、ScalingInter-7Bは57.00で、OpenAI o3の41.50を大幅に上回りました。 これは、Qwen2.5-7Bに基づいて1.50から55.50ポイントの増加の結果です。 しかし、化学混合作業では、全てのモデルが0点を獲得しました。 科学的手順を正確に実行し、失敗の原因を実験的に診断する能力は未解決のままです。
数字を読まれた時、心に留めておくべきこと。 これらの結果は、論文の特定の評価サンプル、ツールインターフェイス、最大回転数、サンプリング数のパフォーマンスです。 モデルの一般的な知識、安全性、実際のウェブサービス互換性、または新しい環境への転送性を直接証明する数字ではありません。
9 月 9 日 強化学習アルゴリズムがうまく機能したのは?
3Bモデルでは、TextCraftはGRPO 75.00とREINFORCE ++ 28.00を記録し、BabyAIはGRPO 93.33とREINFORCE ++ 70.00を記録し、深層検索はGRPO 25.75とREINFORCE ++ 13.25を記録しました。
7Bモデルでは、TextCraftはGRPO 83.00とREINFORCE ++ 73.00を記録し、BabyAIはGRPO 92.22とREINFORCE ++ 84.44を記録し、詳細な検索結果はGRPO 34.00とREINFORCE ++ 24.00を記録しました。
論文では、GRPOは、すべての3つのタスクと両方のモデルスケールでREINFORCE++よりも高いスコアをスコアします。 研究者は、フルエピソードのみを使用して、長期の軌跡とスパース報酬のみを使用して、大規模な分散、およびグループ内での相対的なパフォーマンスを使用するGRPOがより安定した学習信号を提供することができることを解釈します。
しかし、この比較は、紙が選択したハイパーパラメータと環境に限られます。 アルゴリズムの優越性または劣性を一般化するには、同じ計算量、同じサンプル数、異なる報酬密度とモデルファミリーに関するさらなる検証が必要です。
10月10日 テスト時の計算量がパフォーマンスを増加しますか?
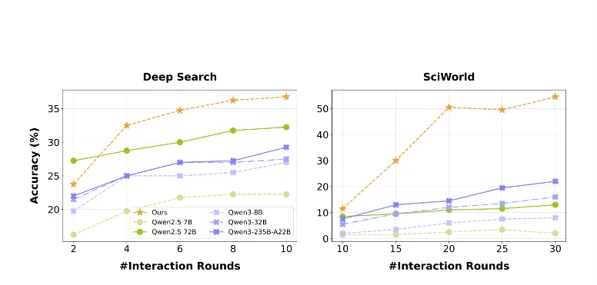
図6. ペーパー図8:Deep SearchとSciWorldの相互作用の最大数を増加させるときの精度の変化。 出典:西ら。、p。 17 ..
一般的には、ディープ検索で2〜10ターンのインタラクション数が増加し、SciWorldで10〜30ターンの間、精度が高まります。 学習したエージェントは、数回でもベースラインモデルを出力し、ターン数が増えるにつれて、その優位性を維持します。 エージェントのテストタイム計算は、内部の推論トークンだけでなく、実際の環境との追加のインタラクションもスケールできるということを示しています。
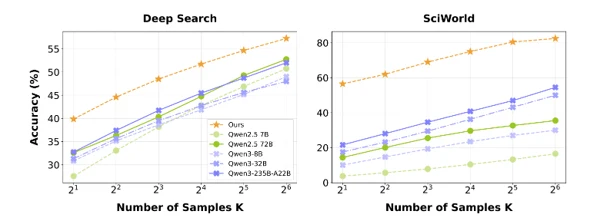
図7. ペーパー図9:平行サンプルKの数を増加させるときPass@Kの性能の変更。 出典:西ら。、p。 17 ..
複数の軌跡を並列に生成し、成功するかどうかをチェックするPass@Kは、サンプルの数が増えるにつれて増加します。 64サンプルでは、強化学習モデルは、深層検索の5.5ポイントとSciWorldの7.05ポイントでベースラインモデルを外したと報告しています。 ただし、実際のサービスではコストと遅延を大幅に増やすことができますので、製品設計では、成功率と計算予算のバランスが必要です。
11月11日 ケース分析: 強化学習が変化しているのは何ですか?
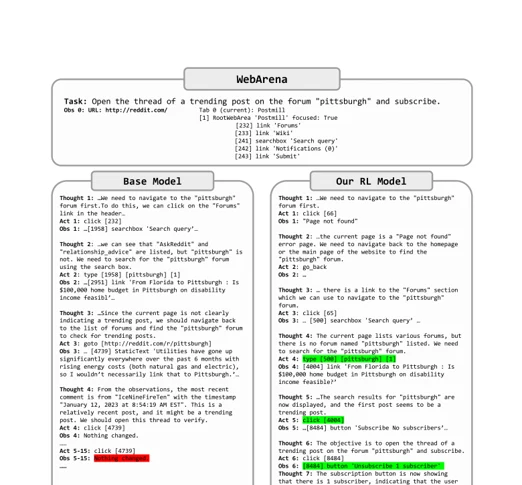
図8. ペーパー図10:WebArenaの基本的なモデルとRLモデルの動作軌跡の比較。 出典:西ら。、p。 19.19.(日)
基本モデルは、Pittsburghフォーラムで人気のある投稿を購読する割り当てで、同じテキスト要素の繰り返しクリックにもかかわらず、画面が変更されなかったという事実を利用できませんでした。 一方、強化学習モデルは、間違ったページに移動して、次の順序でアクションを取ることで成功しました。フォーラムを検索し、検索結果を選択し、購読ボタンを確認します。
この場合の重要な変更は、単に知識を増加させません。 環境のフィードバックを使用して、障害を認識し、異なるパスに切り替え、終了条件をチェックするアクションポリシーを改善しました。 特許明細書の観点から、そのようなエラー回復、反復行動抑制、目標達成状況決定を別々の依存条件または補償産業設計として指定する部屋があります。
12月12日 実際に証明された紙とそれが証明しなかったもの
論文によって直接証明される規模。 複数のターンオンライン強化学習パイプラインは、デジタル環境の5種類で操作できます。 短い地平線から長い地平線に拡張する方法は、固定ターン設定よりも安定した学習曲線を示しています。 3Bモデルと7Bモデルは、複数のエージェントベンチマークにわたってベースラインモデルを大幅に改善します。 相互作用の数と並列サンプルの数を増やすと、テストパフォーマンスが増加できます。
スコープはまだ十分に証明されていません。 完全新しい環境、ツール、報酬構造、現実的な物理的なロボット、または長い作業時間と安全制約、マルチエージェントのコラボレーション/競争、および共同意思決定に一般化および転送は、追加の検証が必要です。 また、すべての商用モデルにおいて一貫して優れている結論や、全ての評価条件下では、この論文だけではサポートされていません。
批判的に読む必要があるポイント。 論文のパフォーマンスの比較は非常に印象的ですが、各環境の評価サンプルとインターフェイスの数が異なるため、一部のWeb割は状態の変化操作を除外します。 また、BabyAIやSciWorldなどの特定の環境では「商用モデルの処理」の締結が強くなっていますが、WebArenaやDeep Searchで最高の商用モデルの不足が予想されます。
13 . . 人工知能特許に特化した特許弁理士の視点から発明のポイント
以下は、論文の公開内容から得られた特許実務の観点から解釈されます。 実際の新規性、進歩性、権利の範囲、および侵害の可能性は、国固有の法的原則および特許および非特許文献の別の検索によって決定されなければならない。
13.1 発明コンセプトを5層に分ける
発明コンセプトは5層に分けられます。 コアアルゴリズムは、学習の進歩として、エージェント環境の相互作用の最大数を徐々に増加させるマルチターン強化学習方法です。 システム構造は、環境、エージェント、およびトレーニングを分離し、標準化されたサーバー指向インターフェイスを介してそれらを接続するモジュラーフレームワークに優先され、データフローは、並列環境内の軌跡を収集し、報酬やログの確率を計算することにより、方策を更新する、オン方策学習パイプラインとして記述することができます。
安定化技術のコアは、短い地平線で初期の分散と非生産的な探査を制限し、長い地平線に拡張することにより、学習崩壊を減らすために制御され、操作技術は、成功率と計算予算を管理する方法として要約され、相互作用の数とテスト時の並列サンプルの数を調整することができます。
13.2 最も強い権利化候補はScalingInter-RLです
AgentGym-RL のモジュール構造は実用的ですが、環境、エージェント、学習者を分離し、HTTP 上で接続する概念自体は、ソフトウェアフレームワークで広く使用されている可能性があります。 一方、強化学習ステージと組み合わせて相互作用の最大数を増加させ、長い固定地平線の初期学習崩壊を抑制する構造は、論文の最も明確な実験ポイントです。
しかし、「簡単なタスクから困難なタスクに挑発する」という広範なカリキュラム学習概念を主張する場合、それは以先行技術と競合する可能性が高い。 クレームは、インタラクション・horizon、オン・ポーシー・トラジェトリー・ジェネレーション、ターミナル・リワード、または軌跡報酬、方策・アップデート、ステップ・トランジション・コンディション、および最大ターン・増加と呼ばれる特定の制御変数の組み合わせを開示しなければなりません。
14 日 事業・製品視点からの影響
AgentGym-RLのダイレクトアプリケーションは、Webタスクの自動化、検索エージェント、ゲームエージェント、仮想ロボット、科学実験アシスタントなど、複数のアクションや環境フィードバックを必要とする製品です。 特に、ユーザーやタスクに応じて、成功に必要なアクションの数が変化するサービスでは、修正ではなく難易度や信頼性に基づいて、インタラクション予算を調整する設計が重要である。
生産段階では、最高の成功率だけでなく、環境コールコスト、ブラウザセッションの数、レイテンシー、繰り返しアクション率、エラー回復率、および安全なシャットダウン条件を最適化する必要があります。 紙のテストタイムスケーリング結果は、より多くのターンとサンプルがパフォーマンスを向上させることができることを示していますが、実際のサービスは、計算予算の制約を反映した動的ポリシーを必要とします。
実用的な影響。 AIエージェントの競争力は、モデルパラメータの数だけに決定されません。 環境とやり取りする方法、学習信号に失敗する報酬設計、および行動予算を増やすときに決定する運用方針は、モデルサイズとして重要な知的財産ポイントとしてのみあることができます。
15.15.(日) 論文の制限とフォローアップ研究の質問
1。 1。 Indomainのパフォーマンスは高くなっていますが、全く新しい環境と新しいツールが十分に検証されていないという汎用性が十分に確認されています。
2。 ほとんどの課題は、デジタルシミュレーションにとどまり、現実的な物理的制約やセンサーの騒音など、長期的な課題は残っています。
3。 現在のフレームワークは、単一のエージェントに焦点を当て、マルチエージェントのコラボレーションと競争は将来の研究トピックです。
4。 SciWorldの化学混合物は、すべてのモデルに失敗し、一部の科学タスクは、学生が実験ではなく記憶事実に答えようとした手続き上のエラーを引き起こしました。
5。 5。 WebArenaでは、ターゲットページに到達した後であっても、不要なクリックとスクロールが不要な、過度の相互作用の問題が残っています。
6。 。 紙は、コードやデータを開示する計画を提示しますが、実際の再現性は、開示および実行環境の範囲の個別の確認が必要です。
7。 相互作用の水平方向トランジションルールは、より自動化され、理論的に正当化する必要があります。
16.16. コンクルージョン
AgentGym-RL は、個々のベンチマークのコードではなく、さまざまな環境を接続する統合システムの問題として LLM エージェントの強化学習を扱います。 最も注目すべき部分は、ScalingInter-RLです。 最初は、エージェントはまだ基本的なスキルを身につけていないとき、行動の自由は限られており、方策がより安定してなるにつれて、長期的な意思決定能力を向上させるための相互作用の長さが増加します。
実験結果は、小さな7Bモデルであっても、適切な後続の強化学習と試験時間の相互作用で、はるかに大きなモデルと競争することができることを示しています。 同時に、WebArenaとDeep Searchのギャップ、科学的手順のエラー、および過剰な相互作用は、エージェントのインテリジェンスがまだ完了していないことを明らかにします。
特許の観点で重要なのは、「AIエージェントに強化学習を適用する」という広い着想ではなく、長期ロールアウトにおける高分散と学習崩壊という技術的課題を、相互作用のホライズンを段階的に制御する具体的な構成によって解決する点です。今後は、報酬統計と方策の安定性に応じてホライズンを自動調整し、テスト時のコストも最適化する方向が、より強い技術的な差別化につながる可能性があります。
ワンライン結論: 強力なAIエージェントは、最初から長時間動作するように構築されていませんが、短い成功を学び、長い探求するために訓練することができます。
この記事は公表時点の情報に基づいています。個別の事情については、当事務所にご相談ください。