
Автор: Ким Ёндок, патентный поверенный IPLEX IP Law Firm
Характер проблемы совершенно иной, если поручить агенту ИИ не «сказать правильный ответ», а «навигировать сайт, чтобы найти нужную информацию, нажать необходимую кнопку, и если это не удастся, исправить путь». Это потому, что он не заканчивается одним ответом, а скорее включает в себя несколько действий, наблюдений и суждений. Во время этого процесса агент может нажать неправильную кнопку, повторить то же действие или сдаться слишком рано.
.
Документ AgentGym-RL нацелен именно на эту проблему многоповоротного решения. Исследователи предложили интегрированную систему обучения с подкреплением, которая отделяла среду, агент и алгоритм обучения и комбинировала его с Scaling Inter-RL, которая ограничивает количество взаимодействий в начале обучения, а затем постепенно увеличивает их. Основная идея статьи проста. Вместо того, чтобы давать агенту длительную свободу действий с самого начала, может быть более стабильным позволить агенту изучить основы через короткие задачи, а затем расширить сферу действия.
Резюме одного предложения. AgentGym-RL - это интегрированная структура, которая обучает агентов LLM через онлайн-обучение с подкреплением в различных реальных средах, а Scaling Inter-RL - это метод увеличения способности к долгосрочному исследованию, одновременно уменьшая первоначальный распад обучения за счет постепенного увеличения максимального количества взаимодействий.
1. Понять газету за 3 минуты
Во-первых, отправной точкой проблемы является то, что существующее обучение с подкреплением LLM ориентировано на одну задачу реагирования, а в задачах агента, требующих нескольких действий и наблюдений, ему не хватает разнообразия окружающей среды, стабильности обучения и долгосрочной поддержки взаимодействия.
Чтобы решить эту проблему, AgentGym-RL разделяет среду, агента и обучение и соединяет веб, поиск, игру, воплощенную и научную среду в один учебный конвейер через стандартизированную структуру сервера-клиента и параллельное развертывание.
С точки зрения обучения, Scaling Inter-RL изначально устанавливает максимальное количество взаимодействий и увеличивает количество разрешенных по мере продвижения фазы обучения. Учебная программа, которая надежно изучает знакомое поведение, а затем позволяет более длительное исследование.
Анализируя экспериментальные результаты, 7B-модель была записана BabyAI 96.67, TextCraft 91.00, SciWorld 57.00, WebArena 26.00 и Deep Search 38.25. Однако она не превзошла коммерческую модель во всех задачах, а превосходство и неполноценность каждой задачи были разными.
Однако обобщение было в основном проверено в той же среде серии, и среда физической реальности и многоагентное обучение остаются в качестве будущих задач. Процедурные ошибки и чрезмерная интерактивность последовательно наблюдались в некоторых научных заданиях и веб-навигации.
2. Ключевые слова, которые нужно знать первым
LLM-агент - это система, в которой языковая модель не просто генерирует предложения, но и вызывает инструменты, наблюдает за окружающей средой и выбирает многошаговые действия.
Мультиповоротное обучение — это обучение, которое обновляет политику на основе всей траектории, состоящей из нескольких действий и наблюдений, а не из одного ответа.
Горизонт взаимодействия — это максимальное количество раз, когда агент может взаимодействовать с окружающей средой в одном эпизоде. Для простоты понимания в этой статье также упоминается максимальное количество действий или продолжительность взаимодействия.
Исследование и эксплуатация — это попытка новых поведенческих путей, в то время как эксплуатация — это повторение поведения, которое уже научилось хорошо работать. Баланс этих двух факторов напрямую влияет на стабильность обучения.
Раскрутка - это процесс помещения агента в реальную среду с его текущей политикой сбора траекторий, состоящих из действий, наблюдений и вознаграждений.
POMDP - это модель принятия решений, в которой агент не видит непосредственно все состояние окружающей среды и должен принять решение о своем следующем действии, основываясь только на некоторых наблюдениях. Он хорошо подходит для ситуаций, когда вы просматриваете веб-страницу или игровой экран шаг за шагом.
GRPO - это метод обучения с подкреплением, который генерирует несколько траекторий в одной и той же задаче, а затем обновляет политику, используя относительную производительность в группе.
Резюме важных выражений. «Обучение с нуля без SFT» в статье не означает предварительную подготовку самой языковой модели со случайной инициализацией. Точнее считать, что в качестве отправной точки используется модель предварительного обучения или направленного обучения серии Qwen2.5, но изучение поведения агента с использованием экологических вознаграждений без предварительной тонкой настройки карты с использованием экспертной траектории задачи агента.
3. Почему обучение с подкреплением было трудным для существующих агентов ИИ?
3.1 Различия между обучением с однократным усилением ответа и обучением с многооборотным агентом
В задачах, где вы отправляете ответ один раз, таких как математическая задача или проблема с кодом, вы можете быть вознаграждены только за точность окончательного правильного ответа. С другой стороны, в веб-браузере или научных экспериментах промежуточные действия изменяют следующее состояние в цепи. Один неправильный клик может изменить все ваше последующее наблюдение, и последствия ваших первоначальных действий могут появиться несколько раз позже. Это увеличивает проблему присвоения кредита для определения того, какие действия способствовали успеху по долгосрочным траекториям.
По мере того, как количество взаимодействий увеличивается, возможные пути действия взрываются. Если вы не исследуете достаточно, вы будете только повторять простые ярлыки, и наоборот, если вы позволите слишком много исследований с самого начала, обучение может рухнуть из-за бессмысленных действий и высокой дисперсии. В статье эти две крайности рассматриваются как верхняя граница производительности для коротких фиксированных горизонтов и распад обучения для длинных фиксированных горизонтов соответственно.
3.2 Без интегрированной структуры сам эксперимент является трудным.
Каждая среда имеет различные поведенческие команды, форматы наблюдений, методы сброса и вычисления вознаграждения. Веб-браузер обрабатывает вкладки и кнопки, TextCraft использует команды крафта, а BabyAI выполняет пространственное перемещение и манипулирование дверью. SciWorld требует процедурных действий, таких как измерение температуры, соединение цепей и смешивание химических веществ. Чтобы соединить их в единый код обучения с подкреплением, интерфейс среды, параллельное выполнение, восстановление ошибок и организация ресурсов должны быть стандартизированы.
AgentGym-RL рассматривает не только исследовательские идеи, но и технические узкие места, которые возникают во время долгосрочного развертывания. В статье объясняется, что она устраняет такие проблемы, как выполнение нескольких браузеров в WebArena, параллельная инициализация в SciWorld, утечки памяти в TextCraft и SciWorld и полная инициализация после окончания эпизода. При долгосрочном обучении агентов стабильность системы так же важна, как и сам алгоритм.
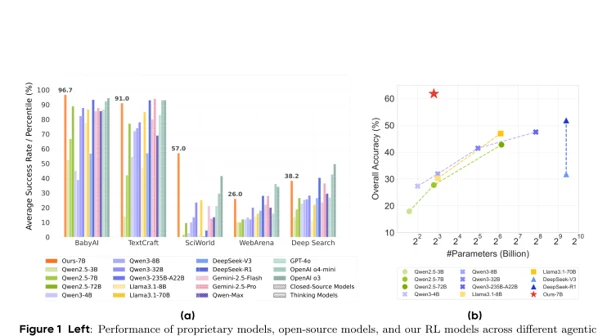
Рисунок 1. Рисунок 1: Сравнение выполнения пяти агентных задач и общей точности по размеру модели. Источник: Xi et al., p. 2.
Левая сторона рисунка 1 показывает производительность для каждой из пяти сред, а правая сторона показывает связь между шкалой параметров модели и общей точностью. В статье подчеркивается, что модель обучения с подкреплением в масштабе 7B конкурирует с гораздо более крупными моделями с открытым исходным кодом и в некоторых средах набирает больше баллов, чем коммерческие модели. Однако невозможно обобщить все фактические способности из одной точки на графике справа, и необходимо видеть, что метод оценки и состав задач каждого эталона различны.
4. Как устроена структура AgentGym-RL?
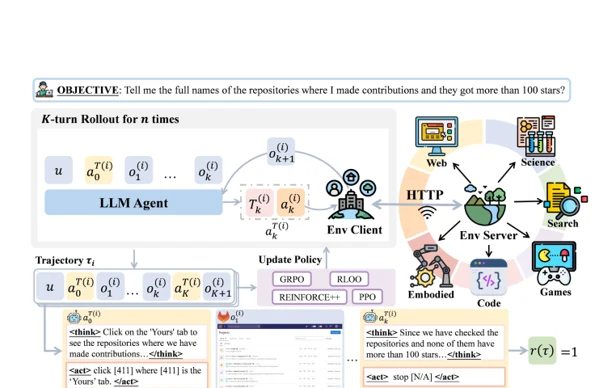
Рисунок 2. Рисунок 2: Общая структура AgentGym-RL разделена на модули «Окружающая среда», «Агент» и «Обучение». Источник: Xi et al., p. 3.
4.1 Модуль среды
Окружающая среда упакована как независимый сервер, и агенты запрашивают наблюдения, проверяют доступные действия, выполняют действия и сбрасывают через HTTP-клиенты. Преимущество этой структуры заключается в том, что даже если веб-среда, среда поиска и игровая среда имеют разные внутренние реализации, к агенту и модулю обучения можно получить доступ через общий интерфейс.
Пять сценариев, включенных в статью: WebArena предназначена для реалистичной веб-навигации, Deep Search - для многоуровневого исследования информации с использованием поисковой системы, TextCraft - для текстовых крафтовых игр, BabyAI - для воплощенных задач в сетевом мире, а SciWorld - для выполнения научных экспериментов и процедур.
4.2 Агентный модуль
Модуль Агент инкапсулирует итеративную петлю, которая принимает наблюдения, делает выводы и генерирует следующее действие. Быстрые стратегии, настройки выборки, функции вознаграждения, а также такие механизмы, как долгосрочное планирование и саморефлексия, предназначены для расширения. Ключ состоит в том, чтобы отделить логику рассуждений агента от детальной реализации конкретной среды.
4.3 Учебный модуль
Части учебного модуля собирают траектории в параллельной среде, вычисляют вероятность журнала и вероятность эталонной модели и выполняют оценку преимуществ и обновление политики. В статье объясняется, что PPO, GRPO, RLOO и REINFORCE++ поддерживаются в качестве онлайн-алгоритмов обучения с подкреплением, а SFT, DPO и отторжение также поддерживаются в качестве вспомогательных методов обучения.
1. Инициировать одновременно несколько назначений и окружение клиентов.
2. Каждый агент генерирует действие, основанное на его текущих наблюдениях.
3. Окружающая среда запускает действие и возвращает новые наблюдения и награды.
4. Сохраните свои действия и наблюдения в качестве траектории до окончания эпизода.
5. Вычислите выгоды от собранных траекторий и обновите параметры политики.
6. Перезагрузите окружающую среду до ее первоначального состояния и повторите следующее развертывание.
Простая аналогия: автошкола. Окружающая среда похожа на дороги и сигнальные системы, Агент похож на вождение стажеров, а Тренинг ближе к тренерам, которые смотрят на записи вождения и меняют следующий план урока. Держа дороги отдельно от студентов и тренеров, вам не придется перестраивать всю систему, если вы добавите новую дорогу, другую модель студента или измените оценку.
5. Масштабирование Inter-RL увеличивает количество действий шаг за шагом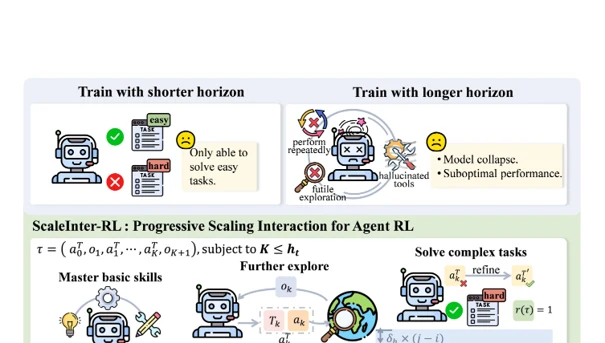
Рисунок 3. Рисунок 5: Масштабирование Inter-RL, который изучает основы в коротком горизонте, а затем расширяется до длинного горизонта. Источник: Xi et al., p. 8.
5.1 Почему не допускается длительное взаимодействие с самого начала
Если вы дадите агенту большое количество действий на ранней стадии, когда он еще не знает основных правил окружающей среды, нет никакой гарантии, что эти дополнительные вычисления приведут к полезному исследованию. Вы можете нажимать одну и ту же кнопку несколько раз, перемещаясь между страницами, которые вы уже просматривали, или вызывать инструменты, которые не связаны с задачей. Эта траектория увеличивает дисперсию вознаграждения и трудности с распределением кредитов, что делает обновления политики нестабильными.
И наоборот, если количество действий фиксируется непрерывно, то возможностей для решения стабильных, но сложных задач недостаточно. Агенты могут адаптироваться только к легким путям к успеху и не могут изучать долгосрочные поведенческие модели, такие как планирование, рефлексия и обратная связь.
5.2 Постепенное расширение горизонта
ScalingInter-RL использует учебную программу, которая монотонно увеличивает максимальное количество взаимодействий как h1, h2, h3. На ранних стадиях небольшой бюджет взаимодействия позволяет эффективно использовать основные действия, а после определенного периода обучения максимальное количество поворотов увеличивается, чтобы обеспечить более длинные навигационные пути.
1. Начальный этап: Надежно изучите простые задачи и базовое использование инструментов с коротким горизонтом.
2. Промежуточный этап: Увеличьте количество взаимодействий, чтобы испытать восстановление после неудачи, перенаправить и дальнейшее извлечение.
3. Более поздний этап: Улучшает сложное поведение, такое как планирование, рефлексия и стратегическое отступление в долгосрочной перспективе.
4. Развертывание каждого этапа генерируется текущей политикой, поэтому сложность задачи и поиск пространства масштабируются вместе по мере роста возможностей агента.
С точки зрения патентования обучение по учебной программе в широком смысле, вероятно, уже известно. Поэтому в формуле изобретения целесообразно отражать конкретный механизм: поэтапное ограничение числа взаимодействий в многошаговых траекториях текущей политики и его сочетание с обновлением политики на основе вознаграждения для предотвращения срыва обучения.
6. Ключевая кривая обучения показывает: длинные повороты быстры, но могут сломаться.
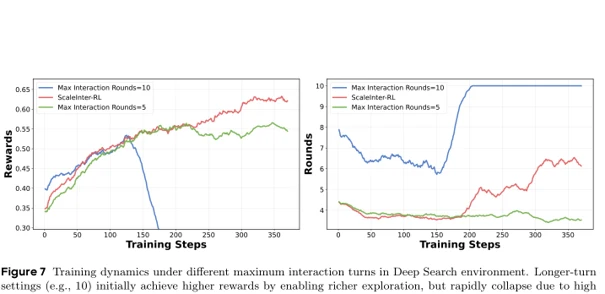
Рисунок 4. Рисунок 7: Сравнение вознаграждений и фактического количества взаимодействий для фиксированных 10 оборотов, фиксированных 5 оборотов и масштабирования Inter-RL в глубоком поиске. Источник: Xi et al., p. 12.
На графике слева настройка, которая позволяет до 10 поворотов от начала, дает начальные вознаграждения, которые быстро растут, но затем быстро разрушаются после примерно 150 шагов обучения. Максимальная настройка 5 оборотов относительно стабильна, но позже производительность стагнирует. Масштабирование Inter-RL изначально поддерживает короткие взаимодействия и постепенно увеличивает количество оборотов, в конечном итоге достигая наивысшей награды.
График справа показывает фактическое количество используемых взаимодействий. Масштабирование Inter-RL начинается примерно с 4 оборотов в начале и увеличивается до более чем 6 оборотов на поздних этапах обучения. Другими словами, это структура, которая не только имеет большой конечный горизонт, но и последовательно предоставляет свободу исследования в соответствии с состоянием обучения агента.
Технические эффекты, заявленные в статье. Это уменьшает высокую дисперсию, накопление неправильных действий, ложных вызовов инструментов и повторяющихся действий, вызванных ранним исследованием длинных горизонтов, обеспечивая при этом достаточный бюджет взаимодействия для решения сложных задач на более поздних стадиях. В статье объясняется это как баланс между разведкой и эксплуатацией, стабильностью обучения и повышением вычислительной эффективности.
7. В какой среде проводился эксперимент?
Экспериментальная среда состоит из пяти различных типов, от просмотра веб-страниц до научных процедур. Каждая среда имеет общее, что агент должен действовать несколько раз и получать обратную связь, чтобы выбрать следующее действие, но их способность оценивать их отличается.
WebArena - это сценарий веб-навигации, который оценивает вашу способность достигать целей с помощью кликов кнопок, поиска и навигации по страницам в магазинах, форумах, GitLab, картах и CMS.
Глубокий поиск - это сценарий глубокого поиска, который неоднократно вызывает поисковую систему и оценивает ее способность объединять информацию из нескольких источников для ответа на вопрос.
TextCraft - это цифровой игровой сценарий, который оценивает вашу способность собирать материалы и выполнять многошаговые ремесла в текстовой среде, подобной Minecraft.
BabyAI - это воплощенный сценарий вызова, который оценивает вашу способность открывать двери, перемещаться и достигать целевых объектов в мире сетки.
SciWorld - это сценарий научной задачи, который оценивает вашу способность выполнять процедурные эксперименты, такие как измерение температуры, тестирование проводимости, поиск организмов и манипулирование материалами.
Основными костяшками являются Qwen2.5-3B и Qwen2.5-7B. Цели сравнения включают коммерческие модели, такие как GPT-4o, OpenAI o3 и Gemini 2.5 Pro, а также модели с открытым исходным кодом, такие как Qwen, Llama и DeepSeek. Цифры оценки являются результатом выбранного набора задач, максимального количества взаимодействий и настроек выборки, и не должны быть непосредственно преобразованы в общий рейтинг производительности продукта.
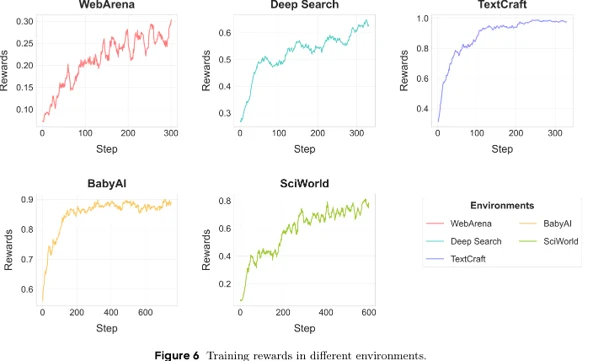
Рисунок 5. Рисунок 6: Тенденции вознаграждения за обучение для WebArena, Deep Search, TextCraft, BabyAI и SciWorld. Источник: Xi et al., p. 10.
Кривая вознаграждения за обучение показывает тенденцию к росту во всех пяти средах, но в разных формах. TextCraft и BabyAI достигают высоких наград относительно быстро, в то время как WebArena и SciWorld очень изменчивы. Это согласуется с интерпретацией статьи о том, что в закрытой среде с четкими правилами и обратной связью обучение с подкреплением легче найти путь к успеху, и что пространство шума и действий становится больше в реалистичных паутинах или сложных научных процедурах.
8. Прочитайте ключевые результаты эксперимента без преувеличения
В WebArena Qwen2.5-7B записал 9.76, AgentGym-RL-7B записал 22.00, а ScalingInter-7B записал 26.00. ScalingInter-7B превзошел базовую модель на +16,24 в абсолютном балле.
В Deep Search Qwen2.5-7B записал 18.75, AgentGym-RL-7B - 34.00, а ScalingInter-7B - 38.25. ScalingInter-7B превзошел базовую модель на +19,50 в абсолютном балле.
В TextCraft Qwen2.5-7B записал 42.00, AgentGym-RL-7B - 89.00, а ScalingInter-7B - 91.00. ScalingInter-7B превзошел базовую модель на +49,00 в абсолютном балле.
В BabyAI Qwen2.5-7B записал 66,67, AgentGym-RL-7B записал 92,22, а ScalingInter-7B записал 96,67. ScalingInter-7B превзошел базовую модель на +30,00 в абсолютном балле.
В SciWorld Qwen2.5-7B зафиксировал 1,50, AgentGym-RL-7B — 50,50, а ScalingInter-7B — 57,00. ScalingInter-7B превзошел базовую модель на +55,50 в абсолютном балле.
Стандартная модель, описанная выше, представляет собой Qwen2.5-7B-инструкцию, описанную в статье. Улучшение, представленное в каждой среде, является абсолютной разницей баллов между ScalingInter-7B и базовой моделью. Наибольшие улучшения были отмечены в SciWorld и TextCraft, которые имеют относительно четкие правила и условия успеха, с сильными сигналами обучения методом проб и ошибок.
8.1 WebArena: конкурентоспособна с коммерческими моделями, но не лучшая
ScalingInter-7B зафиксировал 26.00 в целом в WebArena, превысив 16.00 GPT-4o и приблизившись к 28.00 Gemini 2.5 Pro. Тем не менее, он не дотянул до 34.00 OpenAI o3 и 36.00 o4-mini. Остались пробелы, особенно в подзадачах GitLab и Reddit. Поэтому утверждение о том, что «модель 7B обыграла все коммерческие модели в WebArena», не является точным.
8.2 Глубокий поиск: сильный, но не такой хороший, как o3
ScalingInter-7B составил 38,25, превысив GPT-4o 26,75 и Gemini 2.5 Pro 36,50, но ниже, чем OpenAI o3 49,50 и o4-mini 42,50. Он зафиксировал самый высокий балл в NQ с 52,00 и был привязан к лучшему баллу в TriviaQA с 70,00, но общее среднее значение оставило пробел с верхней моделью вывода.
8.3 TextCraft and BabyAI: Сила долгосрочного поведенческого обучения
В TextCraft ScalingInter-7B превзошел GPT-4o 83.00 с 91.00 и был среди немногих моделей, которые записали 33.33 даже в самой сложной глубине 4. BabyAI зафиксировал самый высокий общий балл 96,67 среди всех моделей, сравниваемых в статье. Это показывает, что эскалация взаимодействия может эффективно работать в средах с четкими правилами поведения и наградами за успех.
8.4 SciWorld: Наибольшие улучшения и наиболее очевидные ограничения появляются одновременно
В SciWorld ScalingInter-7B был на 57.00, значительно превысив 41.50 OpenAI o3. Это результат увеличения на 55,50 пункта с 1,50 на основе Qwen2,5-7B. Тем не менее, все модели набрали 0 баллов в задаче химического смешивания. Способность точно выполнять научные процедуры и экспериментально диагностировать причины неудачи остается нерешенной.
О чем нужно помнить при чтении цифр Эти результаты являются производительностью для конкретного образца оценки бумаги, интерфейса инструмента, максимального количества витков и количества выборок. Это не та цифра, которая непосредственно доказывает общие знания модели, безопасность, фактическую совместимость веб-сервисов или переносимость в новые среды.
9. Какой алгоритм обучения с подкреплением работает лучше?
В модели 3B TextCraft записывал GRPO 75.00 и REINFORCE++ 28.00, BabyAI записывал GRPO 93.33 и REINFORCE++ 70.00, а Deep Search записывал GRPO 25.75 и REINFORCE++ 13.25.
В модели 7B TextCraft записывал GRPO 83.00 и REINFORCE++ 73.00, BabyAI записывал GRPO 92.22 и REINFORCE++ 84.44, а Deep Search записывал GRPO 34.00 и REINFORCE ++ 24.00.
В статье GRPO оценивает выше, чем REINFORCE++, по всем трем задачам и обеим модельным шкалам. Исследователи интерпретируют, что использование только полного эпизода в долгосрочных траекториях и скудных вознаграждениях может привести к большой дисперсии, и что GRPO, который использует относительную производительность в группах, обеспечивает более стабильный сигнал обучения.
Тем не менее, это сравнение ограничено гиперпараметрами и средой, выбранной в статье. Обобщение алгоритмического превосходства или неполноценности требует дальнейшей проверки на одну и ту же вычислительную величину, одно и то же количество выборок и разные плотности вознаграждения и семейства моделей.
10. Увеличивает ли объем расчетов на момент тестирования производительность?
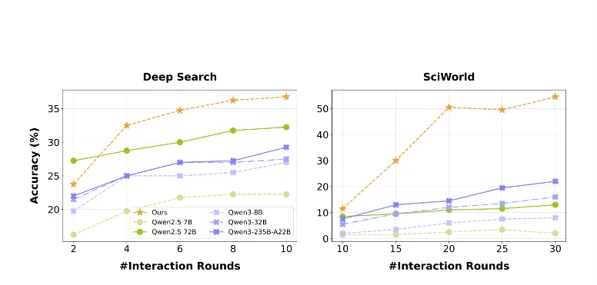
Рисунок 6. Рисунок 8: Изменение точности при увеличении максимального количества взаимодействий в Deep Search и SciWorld. Источник: Xi et al., p. 17.
Точность обычно увеличивается по мере увеличения количества взаимодействий от 2 до 10 оборотов в Deep Search и от 10 до 30 оборотов в SciWorld. Ученый агент превосходит базовую модель даже с меньшим количеством оборотов и сохраняет свое превосходство по мере увеличения числа оборотов. Это показывает, что вычисления тест-времени агента могут масштабироваться не только с внутренними токенами вывода, но и с дополнительными взаимодействиями с реальной средой.
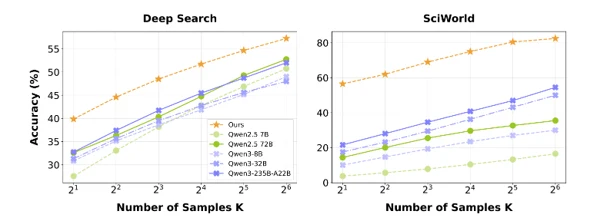
Рисунок 7. Рисунок 9: Производительность Pass@K изменяется при увеличении числа параллельных выборок K. Источник: Xi et al., p. 17.
Pass@K, который генерирует несколько траекторий параллельно и проверяет, удастся ли какой-либо из них, также увеличивается по мере увеличения количества образцов. В статье сообщается, что в 64 образцах модель обучения с подкреплением превзошла базовую модель на 5,5 балла в Deep Search и 7,05 балла в SciWorld. Тем не менее, этот метод может значительно увеличить затраты и задержки в фактическом обслуживании, поэтому дизайн продукта требует баланса между скоростью успеха и вычислительным бюджетом.
11. Анализ случаев: что изменилось в обучении с подкреплением?
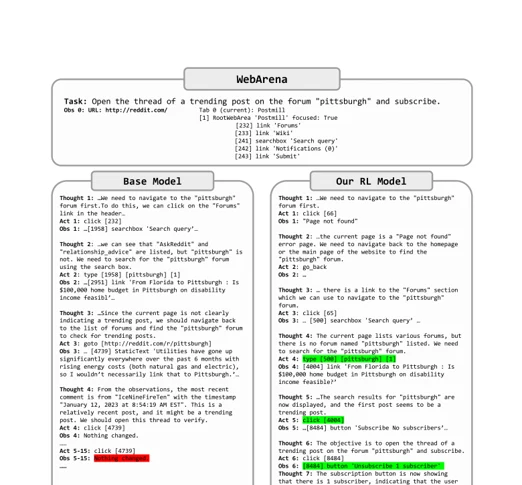
Рисунок 8. Рисунок 10: Сравнение траекторий действия базовой модели и модели RL в WebArena. Источник: Xi et al., p. 19.
Базовая модель не смогла воспользоваться тем, что в задании подписаться на популярные посты на форуме в Питтсбурге экран не менялся, несмотря на неоднократные клики по одному и тому же текстовому элементу. С другой стороны, модель обучения с подкреплением была успешной, перейдя на неправильную страницу, а затем предприняв действия в следующем порядке: вернувшись назад, выполнив поиск на форуме, выбрав результат поиска и подтвердив кнопку подписки.
Важное изменение состоит в улучшении политики действий: агент использует обратную связь среды для выявления ошибок, смены пути и проверки условий завершения. В патентной заявке восстановление после ошибок, подавление повторных действий и определение достижения цели можно раскрыть как отдельные зависимые пункты формулы или элементы механизма вознаграждения.
12. Что на самом деле доказала газета и чего не доказала
Сфера, непосредственно доказанная статьёй. Многооборотный онлайн-провод обучения с подкреплением может работать в пяти типах цифровых сред. Метод расширения от короткого горизонта до длинного горизонта показывает более стабильную кривую обучения, чем фиксированная настройка поворота. Модели 3B и 7B значительно улучшаются по сравнению с базовой моделью в нескольких тестах агентов. Тестовая производительность может увеличиваться по мере увеличения количества взаимодействий и количества параллельных выборок.
Сфера еще не полностью доказана. Обобщение и передача в совершенно новые среды, инструменты и структуры вознаграждения, реальные физические роботы или реальные услуги с длительным рабочим временем и ограничениями безопасности, сотрудничество / конкуренция с несколькими агентами и совместное принятие решений с людьми требуют дополнительной проверки. Кроме того, вывод о том, что он последовательно превосходит все коммерческие модели и при всех условиях оценки, не подтверждается только в этом документе.
Точка, которую нужно прочесть критически. Хотя сравнение производительности в статье очень впечатляет, количество образцов оценки и интерфейсов для каждой среды различны, а некоторые веб-задания исключают операции изменения состояния. Кроме того, вывод о «превзойденных коммерческих моделях» остается сильным в определенных средах, таких как BabyAI и SciWorld, но не соответствует лучшим коммерческим моделям в WebArena и Deep Search.
13. Точки изобретения с точки зрения патентного поверенного, специализирующегося на патентах на искусственный интеллект
Ниже приводится интерпретация с точки зрения патентной практики, полученная из опубликованного содержания статьи. Фактическая новизна, изобретательский уровень, объем прав и возможность нарушения должны определяться с помощью конкретных правовых принципов страны и отдельного поиска патентной и непатентной литературы.
13.1 Разделение концепции изобретения на пять слоев
Концепцию изобретения можно разделить на пять слоев. Основной алгоритм - это метод обучения с многоповоротным подкреплением, который постепенно увеличивает максимальное количество взаимодействий агента и окружающей среды по мере развития обучения. Структура системы основана на модульной структуре, которая разделяет среду, агента и обучение и соединяет их через стандартизированный интерфейс сервера-клиента, а поток данных может быть описан как конвейер обучения по политике, который собирает траектории в параллельной среде и обновляет политику, вычисляя вознаграждения и вероятности журнала.
Ядром технологии стабилизации является контроль для уменьшения коллапса обучения путем ограничения начальной дисперсии и непродуктивного исследования с коротким горизонтом, а затем расширения до длинного горизонта, и технология операции может быть обобщена как метод управления скоростью успеха и вычислительным бюджетом путем корректировки количества взаимодействий и количества параллельных выборок во время тестирования.
13.2 Самым сильным кандидатом на получение прав является ScalingInter-RL.
В то время как модульная структура AgentGym-RL практична, сама концепция разделения сред, агентов и учащихся и подключения их через HTTP, вероятно, будет широко использоваться в программных средах. С другой стороны, структура, которая увеличивает максимальное количество взаимодействий в сочетании со стадией обучения с подкреплением и подавляет начальный коллапс обучения длинного фиксированного горизонта, является наиболее ясной экспериментальной точкой статьи.
Широкое притязание на переход от простых задач к сложным с высокой вероятностью столкнётся с уровнем техники. В формуле следует раскрыть взаимосвязь горизонта взаимодействия, генерации траекторий текущей политики, конечного или траекторного вознаграждения, обновления политики, условий перехода между этапами и увеличения максимального числа шагов.
14. Последствия с точки зрения бизнеса и продукта
AgentGym-RL может применяться для автоматизации веб-задач, поисковых и игровых агентов, виртуальных роботов и сопровождения научных экспериментов — задач, требующих последовательности действий и обратной связи от среды. Если число действий до достижения результата зависит от пользователя и задачи, важно адаптировать бюджет взаимодействия к сложности и надёжности выполнения, а не задавать его неизменным.
На этапе производства вам необходимо оптимизировать не только самый высокий показатель успеха, но и стоимость вызова среды, количество сеансов браузера, задержку, частоту повторных действий, скорость восстановления ошибок и безопасные условия отключения. Результаты масштабирования во время тестирования показывают, что большее количество поворотов и выборок может улучшить производительность, но реальные услуги требуют динамической политики, которая отражает вычислительные бюджетные ограничения.
Практические последствия. Конкурентоспособность ИИ-агента определяется не только количеством параметров модели. Как он взаимодействует с окружающей средой, дизайн вознаграждения, который превращает неудачи в обучающие сигналы, и операционная политика, которая определяет, когда увеличить свой бюджет действий, могут быть такими же важными точками интеллектуальной собственности, как размер модели.
15. Ограничения статьи и последующие вопросы исследований
1. Несмотря на высокую производительность Indomain, его способность к обобщению в совершенно новых средах и новых инструментах не была достаточно проверена.
2. Большинство проблем остаются в цифровом моделировании, а долгосрочные проблемы остаются, в том числе физические ограничения в реальном мире и шум датчиков.
3. В настоящее время основное внимание уделяется одному агенту, а сотрудничество и конкуренция между несколькими агентами являются темами будущих исследований.
4. Химические смеси SciWorld провалили все модели, и некоторые научные задачи привели к процедурным ошибкам, когда студенты пытались ответить заученными фактами вместо экспериментов.
5. В WebArena оставалась проблема чрезмерной интерактивности, с ненужным нажатием и прокруткой даже после достижения целевой страницы.
6. В статье представлен план раскрытия кода и данных, но фактическая воспроизводимость требует отдельного подтверждения объема раскрытия и среды исполнения.
7. Правила перехода на горизонт взаимодействия должны быть более автоматизированными и теоретически обоснованными.
16. Заключение
AgentGym-RL рассматривает обучение с подкреплением агентов LLM как комплексную системную проблему, которая соединяет различные среды, а не как код для отдельных эталонов. Наиболее примечательной частью является Scaling Inter-RL. Вначале, когда агент еще не приобрел базовые навыки, свобода действий ограничена, и по мере того, как политика становится более стабильной, продолжительность взаимодействия увеличивается, чтобы улучшить способность принимать долгосрочные решения.
Экспериментальные результаты показывают, что даже небольшая модель 7B может конкурировать с гораздо более крупными моделями с соответствующим последующим обучением с подкреплением и взаимодействием во время тестирования. В то же время разрыв между WebArena и Deep Search, ошибки в научных процедурах и чрезмерное взаимодействие ясно показывают, что агентный интеллект еще не завершен.
С точки зрения патента, ключом является не широкая идея «применения обучения с подкреплением к агентам ИИ», а конкретная комбинация решения технических проблем высокой дисперсии и распада обучения в долгосрочных развертываниях с ступенчатым контролем горизонта взаимодействия. В будущем автоматическая корректировка горизонта на основе статистики вознаграждений и стабильности политики и оптимизация затрат на момент тестирования могут стать более сильной технической дифференциацией.
Сильные агенты ИИ не созданы для того, чтобы вести себя долгое время с самого начала, но могут быть обучены тому, чтобы учиться коротким успехам, а затем исследовать дольше.
Материал отражает ситуацию на дату публикации. Обратитесь в IPLEX, чтобы обсудить обстоятельства вашего дела.