
Autor: Yongduck Kim, agente de patentes de IPLEX IP Law Firm
La naturaleza del problema es completamente diferente si usted instruye al agente de IA a no decir la respuesta correcta, sino a “avizar el sitio web para encontrar la información que desea, presionar el botón requerido, y si eso falla, corregir el camino”. Esto es porque no termina con una sola respuesta, sino que implica múltiples acciones, observaciones y juicios. Durante este proceso, el agente puede pulsar el botón equivocado, repetir la misma acción, o renunciar demasiado temprano.
.
El documento AgentGym-RL se dirige precisamente a este problema de decisión multivolutivo. Los investigadores propusieron un marco integrado de aprendizaje por refuerzo que separaba el ambiente, el agente y el algoritmo de aprendizaje, y lo combinaron con ScalingInter-RL, lo que limita el número de interacciones brevemente al comienzo del aprendizaje y luego aumenta gradualmente. El mensaje central del artículo es simple. En lugar de dar al agente una larga libertad de acción desde el principio, puede ser más estable dejar que el agente aprenda los fundamentos a través de tareas cortas y luego ampliar el alcance de la acción.
Un resumen de la frase. AgentGym-RL es un marco integrado que capacita a los agentes de LLM a través del aprendizaje por refuerzo en línea en diversos entornos del mundo real, y ScalingInter-RL es un método para aumentar la capacidad de exploración a largo plazo, reduciendo al mismo tiempo el deterioro inicial del aprendizaje aumentando gradualmente el número máximo de interacciones.
1. Entender el artículo en 3 minutos
En primer lugar, el punto de partida del problema es que el aprendizaje por refuerzo LLM existente se centra en una única tarea de respuesta, y en tareas de agentes que requieren múltiples acciones y observaciones, carece de diversidad ambiental, estabilidad del aprendizaje y apoyo a la interacción a largo plazo.
Para resolver esto, AgentGym-RL separa Medio Ambiente, Agente y Formación, y conecta web, búsqueda, juego, encarnado y entornos científicos en un solo oleoducto de aprendizaje a través de una estructura estándar del cliente servidor y la implantación paralela.
En el lado del aprendizaje, ScalingInter-RL establece el número máximo de interacciones pequeñas inicialmente y aumenta el número permitido a medida que avanza la fase de aprendizaje. Un plan de estudios que aprende de forma fiable comportamientos familiares y luego permite una exploración más larga.
Mirando los resultados experimentales, el modelo 7B del documento grabó BabyAI 96.67, TextCraft 91.00, SciWorld 57.00, WebArena 26.00 y Deep Search 38.25. Sin embargo, no superó el modelo comercial en todas las tareas, y la superioridad e inferioridad de cada tarea eran diferentes.
Sin embargo, la generalización se verificó principalmente en el entorno de la misma serie, y el entorno de la realidad física y el aprendizaje multiagente siguen siendo tareas futuras. Los errores de procedimiento y la interactividad excesiva se observaron constantemente en algunas asignaciones científicas y navegación web.
2. Términos clave para conocer primero
Un agente de LLM es un sistema en el que el modelo de lenguaje no simplemente genera oraciones, sino que también llama herramientas, observa el medio ambiente y selecciona acciones multi-paso.
El aprendizaje por refuerzo multivolutivo es aprender que actualiza la política basada en toda la trayectoria que consiste en múltiples acciones y observaciones en lugar de una sola respuesta.
El horizonte de interacción es el número máximo de veces que un agente puede interactuar con el medio ambiente en un episodio. Para facilitar el entendimiento, este artículo también se refiere a él como el número máximo de acciones o longitud de interacción.
La exploración y la explotación consisten en probar nuevos caminos conductuales, mientras que la explotación consiste en repetir comportamientos que ya se han aprendido a trabajar bien. El equilibrio de los dos afecta directamente a la estabilidad del aprendizaje por refuerzo.
Rollout es el proceso de poner a un agente en un ambiente real con su política actual de recoger trayectorias consistentes en acciones, observaciones y recompensas.
POMDP es un modelo de toma de decisiones en el que el agente no ve directamente todo el estado del medio ambiente y debe decidir su siguiente acción basado en sólo algunas observaciones. Funciona bien para situaciones donde se ve una página web o una pantalla de juego paso a paso.
GRPO es un método de aprendizaje por refuerzo que genera múltiples trayectorias en la misma tarea y luego actualiza la política utilizando el desempeño relativo dentro del grupo.
Resumen de expresiones importantes. “Aprender desde cero sin SFT” en el artículo no significa pre-entrenamiento del modelo de lenguaje en sí con inicialización aleatoria. Es más preciso leer esto como tomar el modelo de aprendizaje pre-aprendizaje o dirigido de la serie Qwen2.5 como punto de partida, pero aprender el comportamiento del agente usando recompensas ambientales sin ajustar previamente el mapa usando la trayectoria experta de la tarea del agente.
3. ¿Por qué era difícil el aprendizaje por refuerzo para los agentes de IA existentes?
3.1 Diferencias entre el aprendizaje de un solo refuerzo de la respuesta y el aprendizaje de agentes de giro múltiple
En tareas donde usted envía una respuesta una vez, como un problema matemático o problema de código, sólo puede ser recompensado por la exactitud de la respuesta correcta final. Por otro lado, en navegación web o experimentos científicos, las acciones intermedias cambian el siguiente estado en una cadena. Un clic incorrecto puede cambiar toda su observación posterior, y los efectos de sus acciones iniciales pueden aparecer varios giros más adelante. Esto aumenta el problema de asignar crédito para determinar qué acciones contribuyeron al éxito en las trayectorias a largo plazo.
A medida que aumenta el número de interacciones, los posibles caminos de acción explotan. Si no exploras lo suficiente, sólo repetirás atajos fáciles, y al contrario, si permites demasiada exploración desde el principio, el aprendizaje puede colapsar debido a acciones sin sentido y a una gran varianza. El documento observa estos dos extremos como un límite superior de rendimiento para horizontes cortos fijos y decaimiento de aprendizaje para horizontes fijos largos, respectivamente.
3.2 Sin un marco integrado, el experimento en sí es difícil
Cada entorno tiene diferentes comandos conductuales, formatos de observación, métodos de reseteo y cálculos de recompensa. El navegador web maneja pestañas y botones, TextCraft utiliza comandos de fabricación, y BabyAI realiza movimiento espacial y manipulación de puerta. SciWorld requiere acciones de procedimiento como medir temperaturas, conectar circuitos y mezclar productos químicos. Para conectarlos a un solo código de aprendizaje por refuerzo, debe estandarizarse la interfaz del medio ambiente, la ejecución paralela, la recuperación de errores y la organización de recursos.
AgentGym-RL aborda no sólo las ideas de investigación sino también los cuellos de botella de ingeniería que surgen durante el despliegue a largo plazo. El documento explica que fija temas como la ejecución multi-browser en WebArena, la inicialización paralela en SciWorld, las fugas de memoria en TextCraft y SciWorld, y la inicialización completa después del final de un episodio. En el aprendizaje a largo plazo de los agentes, esta estabilidad del sistema es tan importante como el algoritmo mismo.
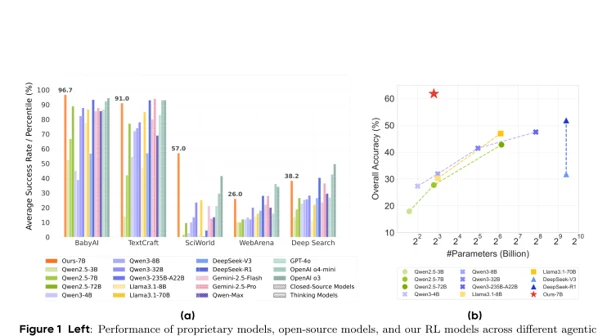
Figura 1. Gráfico 1: Comparación del desempeño de cinco tareas de agente y precisión general por tamaño modelo. Fuente: Xi et al., p. 2.
El lado izquierdo de la Figura 1 muestra el rendimiento para cada uno de los cinco ambientes, y el lado derecho muestra la relación entre la escala del parámetro modelo y la precisión general. El artículo destaca que el modelo de aprendizaje por refuerzo 7B compite con modelos de código abierto mucho más grandes y, en algunos ambientes, puntua más alto que los modelos comerciales. Sin embargo, no es posible generalizar todas las habilidades reales desde un solo punto en el gráfico de la derecha, y debe verse que el método de evaluación y la composición de tareas de cada punto de referencia son diferentes.
4. ¿Cómo se estructura el marco AgentGym-RL?
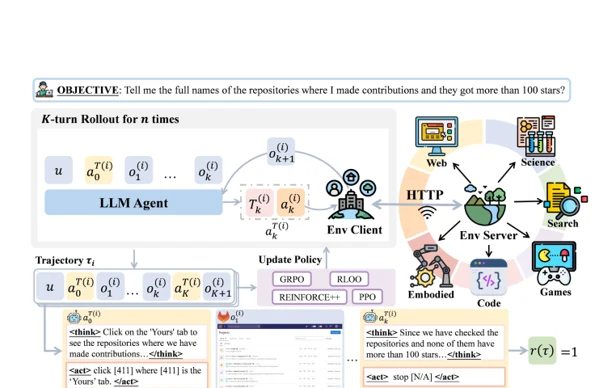
Figura 2. Gráfico 2: Estructura general de AgentGym-RL dividida en módulos de Medio Ambiente, Agente y Capacitación. Fuente: Xi et al., p. 3.
4.1 Módulo para el medio ambiente
El entorno se envasa como servidor independiente, y los agentes solicitan observaciones, verifican las acciones disponibles, ejecutan acciones y se reinician a través de clientes basados en HTTP. La ventaja de esta estructura es que incluso si el entorno web, el entorno de búsqueda y el entorno de juego tienen diferentes implementaciones internas, el agente y el módulo de aprendizaje se pueden acceder a través de una interfaz común.
Los cinco escenarios incluidos en el documento son: WebArena es para la navegación web realista, Deep Search es para la exploración de información multinivel utilizando un motor de búsqueda, TextCraft es para juegos de artesanía basados en texto, BabyAI es para tareas encarnadas en un mundo de la red, y SciWorld es para realizar experimentos y procedimientos científicos.
4.2 Módulo del agente
El módulo Agente encapsula un bucle iterativo que toma observaciones, hace inferencias y genera la siguiente acción. Las estrategias de prontitud, ajustes de muestreo, funciones de recompensa, así como mecanismos tales como la planificación a largo plazo y la auto-reflexión están diseñados para ser extensibles. La clave es separar la lógica de razonamiento del agente de la aplicación detallada de un entorno específico.
4.3 Módulo de capacitación
Los lotes del módulo de capacitación recolectaron trayectorias en un entorno paralelo, calcula la probabilidad de registro y la probabilidad del modelo de referencia, y realiza la estimación de beneficios y la actualización de políticas. El documento explica que PPO, GRPO, RLOO y REINFORCE++ son compatibles como algoritmos de aprendizaje por refuerzo en línea, y SFT, DPO, y muestreo de rechazo también se soportan como métodos auxiliares de aprendizaje.
1. Inicializar múltiples clientes de asignación y entorno simultáneamente.
2. Cada agente genera una acción basada en sus observaciones actuales.
3. El medio ambiente activa la acción y devuelve nuevas observaciones y recompensas.
4. Guarda tus acciones y observaciones como una trayectoria hasta que termine el episodio.
5. Calcule los beneficios de las trayectorias recogidas y actualice los parámetros de política.
6. Reiniciar el medio ambiente a su estado inicial y repetir la próxima salida.
Una analogía fácil: una escuela de conducción. El medio ambiente es similar a los caminos y sistemas de señalización, el agente es similar a los aprendices de conducción, y el entrenamiento está más cerca de los entrenadores que miran los registros de conducción y cambian el próximo plan de lección. Al mantener las carreteras separadas de estudiantes y entrenadores, no tienes que reconstruir todo el sistema si agregas una nueva carretera, un modelo de estudiante diferente, o cambiar de clasificación.
5. Proposición clave: Escalar Inter-RL aumenta el número de acciones paso a paso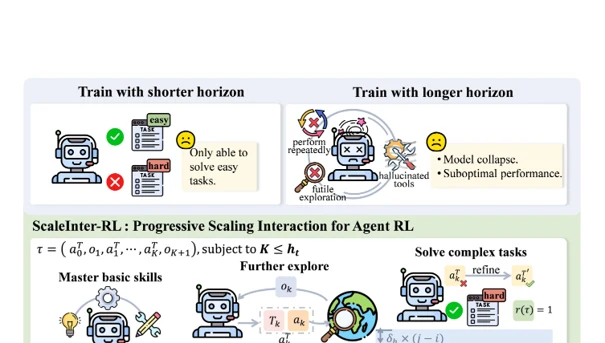
Figura 3. Gráfico 5: Escalar Inter-RL, que aprende los fundamentos en un corto horizonte y luego se expande a un largo horizonte. Fuente: Xi et al., p. 8.
5.1 ¿Por qué no permitir largas interacciones desde el principio
Si usted da al agente un gran número de acciones en una etapa temprana cuando todavía no conoce las reglas básicas del medio ambiente, no hay garantía de que esas computaciones adicionales conducirán a una exploración útil. Usted puede estar presionando el mismo botón repetidamente, yendo de ida y vuelta entre las páginas que ya ha visto, o llamando herramientas que no están relacionadas con la tarea. Esta trayectoria aumenta la dispersión de recompensas y la dificultad de asignación de crédito, haciendo que las actualizaciones de políticas sean inestables.
Por el contrario, si el número de acciones se fija continuamente, no hay suficientes oportunidades para resolver tareas estables pero complejas. Los agentes sólo pueden adaptarse a caminos fáciles para el éxito y pueden no aprender patrones conductuales a largo plazo como planificación, reflexión y retroceso.
5.2 Ampliación de Horizonte Gradual
ScalingInter-RL utiliza un plan de estudios que aumenta monotonicamente el número máximo de interacciones como h1, h2, h3. En las primeras etapas, un pequeño presupuesto de interacción permite el uso eficiente de las acciones básicas, y después de un cierto período de aprendizaje, se aumenta el número máximo de vueltas para permitir caminos de navegación más largos.
1. Etapa inicial: Aprende con fiabilidad tareas fáciles y uso básico de herramientas con un corto horizonte.
2. Etapa intermedia: Aumentar el número de interacciones para experimentar la recuperación después del fracaso, el desvío y la recuperación posterior.
3. Etapa posterior: Mejora comportamientos complejos como planificación, reflexión y retroceso estratégico en el largo horizonte.
4. El despliegue de cada etapa se genera por la política actual, por lo que la dificultad de tarea y la escala de espacio de búsqueda juntos a medida que crecen las capacidades del agente.
Una línea desde una perspectiva de patente. Es probable que el aprendizaje de los estudios en sentido amplio sea un concepto conocido. En las reivindicaciones de patente, en lugar de simplemente expresar dificultades, resulta más ventajoso centrarse en una estructura de control específica que limita el número máximo de interacciones en la implantación de multirrelación política por etapa y suprime el colapso del aprendizaje combinandolo con actualizaciones normativas basadas en recompensas.
6. La curva de aprendizaje clave muestra: los giros largos son rápidos pero pueden descomponerse
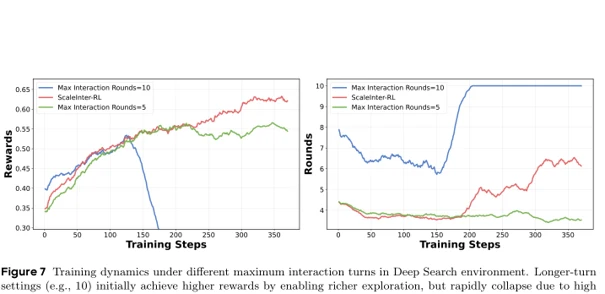
Figura 4. Documento Gráfico 7: Comparación de recompensas y número real de interacciones para 10 vueltas fijas, 5 vueltas fijas, y escalando Inter-RL en búsqueda profunda. Fuente: Xi et al., p. 12.
En el gráfico de la izquierda, un ajuste que permite hasta 10 vueltas desde el principio da recompensas iniciales que se levantan rápidamente, pero luego rápidamente colapsan después de unos 150 pasos de aprendizaje. El ajuste máximo de 5 vueltas es relativamente estable, pero el rendimiento posterior se estanca. ScalingInter-RL mantiene inicialmente interacciones cortas y aumenta gradualmente el número de giros, alcanzando finalmente la recompensa más alta.
El gráfico de la derecha muestra el número real de interacciones utilizadas. ScalingInter-RL comienza alrededor de 4 vueltas en el principio y aumenta a más de 6 vueltas en las etapas posteriores del entrenamiento. En otras palabras, es una estructura que no sólo tiene un gran horizonte final, pero secuencialmente otorga libertad de exploración según el estado de aprendizaje del agente.
Efectos técnicos reclamados por el documento. Reduce la alta varianza, acumulación de acciones incorrectas, llamadas falsas de herramientas y acciones repetitivas causadas por la exploración temprana de horizontes largos, al tiempo que proporciona suficiente presupuesto de interacción para resolver tareas complejas en las etapas posteriores. El documento explica esto como un equilibrio entre la exploración y la explotación, la estabilidad del aprendizaje y una mejor eficiencia computacional.
7. ¿En qué ambiente se llevó a cabo el experimento?
El entorno experimental consiste en cinco tipos diferentes, que van desde la navegación web hasta los procedimientos científicos. Cada entorno tiene en común que el agente debe actuar múltiples veces y recibir comentarios para elegir la siguiente acción, pero su capacidad de evaluarlos difiere.
WebArena es un escenario de navegación web que evalúa su capacidad para alcanzar metas a través de clics de botones, búsquedas y navegación de páginas a través de Compras, Foros, GitLab, Mapas y CMS.
Deep Search es un escenario de búsqueda profunda que llama repetidamente un motor de búsqueda y evalúa su capacidad de combinar información de múltiples fuentes para responder a una pregunta.
TextCraft es un escenario de juego digital que evalúa su capacidad para reunir materiales y realizar artesanías de varios pasos en un entorno de texto similar a Minecraft.
BabyAI es un escenario de desafío encarnado que evalúa su capacidad de abrir puertas, moverse y alcanzar objetos objetivos en un mundo de la red.
SciWorld es un escenario de desafío científico que evalúa su capacidad para realizar experimentos de procedimiento tales como medir temperatura, probar conductividad, encontrar organismos y manipular materiales.
Las columnas principales son Qwen2.5-3B y Qwen2.5-7B. Los objetivos de comparación incluyen modelos comerciales como GPT-4o, OpenAI o3, y Gemini 2.5 Pro, así como modelos de código abierto como Qwen, Llama y DeepSeek. Las cifras de evaluación son el resultado del conjunto de tareas elegido del documento, el número máximo de interacciones y ajustes de muestreo, y no deben ser convertidos directamente a la clasificación general del rendimiento del producto.
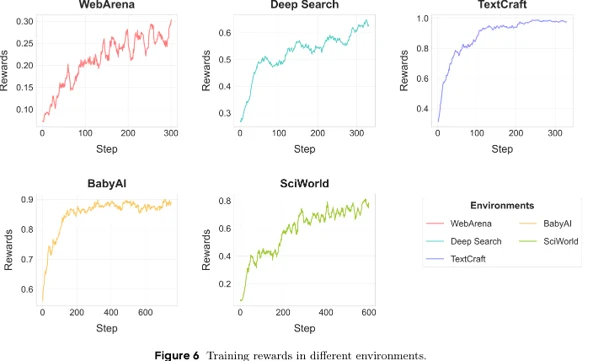
Figura 5. Documento Gráfico 6: Aprendizaje las tendencias de la recompensa para WebArena, Búsqueda profunda, TextCraft, BabyAI y SciWorld. Fuente: Xi et al., p. 10.
La curva de recompensa de aprendizaje muestra una tendencia ascendente en los cinco ambientes, pero en diferentes formas. TextCraft y BabyAI alcanzan altas recompensas relativamente rápidamente, mientras que WebArena y SciWorld son altamente volátiles. Esto está en consonancia con la interpretación del documento de que en un entorno cerrado con reglas claras y retroalimentación, es más fácil para el aprendizaje por refuerzo encontrar un camino de éxito, y que el espacio de ruido y acción se hace más grande en redes realistas o procedimientos científicos complejos.
8. Leer resultados de experimentos clave sin exageración
En WebArena, Qwen2.5-7B registró 9.76, Agente Gym-RL-7B grabó 22.00, y ScalingInter-7B registró 26.00. ScalingInter-7B superó el modelo de referencia por +16.24 en puntuación absoluta.
En Deep Search, Qwen2.5-7B registró 18.75, AgentGym-RL-7B registró 34.00, y ScalingInter-7B registró 38.25. ScalingInter-7B superó el modelo de base por +19.50 en puntuación absoluta.
En TextCraft, Qwen2.5-7B grabó 42.00, AgentGym-RL-7B grabó 89.00, y ScalingInter-7B grabó 91.00. ScalingInter-7B superó el modelo de referencia para +49.00 en la puntuación absoluta.
En BabyAI, Qwen2.5-7B registró 66.67, el Agente Gym-RL-7B registró 92.22, y ScalingInter-7B registró 96.67. ScalingInter-7B superó el modelo de referencia por +30.00 en puntuación absoluta.
En SciWorld, Qwen2.5-7B registró 1,50, AgentGym-RL-7B registró 50.50, y ScalingInter-7B registró 57.00. ScalingInter-7B superó el modelo de referencia por +55.50 en puntuación absoluta.
El modelo estándar resumido anteriormente es Qwen2.5-7B-Instrucción descrita en el documento. La mejora presentada en cada entorno es la diferencia de puntuación absoluta entre ScalingInter-7B y el modelo de referencia. Las mejoras más importantes se vieron en SciWorld y TextCraft, ambos con reglas relativamente claras y condiciones de éxito, con señales fuertes de aprendizaje a través del ensayo y error.
8.1 WebArena: Competitiva con modelos comerciales, pero no la mejor
ScalingInter-7B grabó 26.00 en general en WebArena, superando las 16.00 de GPT-4o y llegando cerca de las 28.00 de Gemini 2.5 Pro. Sin embargo, se redujo a 34.00 de OpenAI o3 y a 36.00 de o4-mini. Gaps se mantuvo, especialmente en los sub-tareas de GitLab y Reddit. Por lo tanto, la afirmación de que “el modelo 7B golpeó todos los modelos comerciales en WebArena” no es precisa.
8.2 Búsqueda profunda: Fuerte, pero no tan bueno como o3
ScalingInter-7B era 38.25, superando el GPT-4o 26.75 y el Gémini 2.5 Pro 36.50, pero inferior a OpenAI o3 49.50 y o4-mini 42.50. Grabó la puntuación más alta en NQ con 52.00 y fue atada para la mejor puntuación en TriviaQA con 70.00, pero el promedio general dejó una brecha con el modelo de inferencia superior.
8.3 TextCraft y BabyAI: ventajas del aprendizaje de acciones a largo plazo
En TextCraft, ScalingInter-7B superó los 83,00 de GPT-4o con 91.00, y fue uno de los pocos modelos que registraron 33.33 incluso en la más difícil Profundidad 4. BabyAI registró la puntuación general más alta de 96.67 entre todos los modelos comparados en el artículo. Esto demuestra que la intensificación de la interacción puede funcionar eficazmente en entornos con reglas claras de comportamiento y recompensas para el éxito.
8.4 SciWorld: Las mayores mejoras y limitaciones más obvias aparecen simultáneamente
En SciWorld, ScalingInter-7B fue a las 57.00, superando significativamente los 41.50 de OpenAI o3. Esto es resultado de un aumento de 55.50 puntos de 1.50 basado en Qwen2.5-7B. Sin embargo, todos los modelos marcaron 0 en la tarea de mezcla química. La capacidad de realizar con precisión procedimientos científicos y de diagnosticar experimentalmente las causas del fracaso sigue sin resolverse.
Cosas que tener en cuenta al leer números. Estos resultados son el rendimiento para la muestra de evaluación específica del artículo, la interfaz de herramienta, el número máximo de vueltas y el número de muestreos. No es una figura que demuestre directamente el conocimiento general del modelo, la seguridad, la compatibilidad real del servicio web o la transferibilidad a nuevos entornos.
9. ¿Qué algoritmo de aprendizaje por refuerzo funcionó mejor?
En el modelo 3B, TextCraft grabó GRPO 75.00 y REINFORCE+++ 28.00, BabyAI grabó GRPO 93.33 y REINFORCE++ 70.00 y Deep Search grabó GRPO 25.75 y REINFORCE++ 13.25.
En el modelo 7B, TextCraft grabó GRPO 83.00 y REINFORCE++ 73.00, BabyAI grabó GRPO 92.22 y REINFORCE++ 84.44 y Deep Search grabó GRPO 34.00 y REINFORCE+++ 24.00.
En el artículo, GRPO marca más alto que REINFORCE++ en las tres tareas y ambas escalas de modelos. Los investigadores interpretan que el uso de sólo episodio completo retorna en trayectorias a largo plazo y recompensas escasas puede resultar en una gran varianza, y que GRPO, que utiliza el rendimiento relativo dentro de los grupos, proporciona una señal de aprendizaje más estable.
Sin embargo, esta comparación se limita a los hiperparametros y el ambiente seleccionados por el artículo. Generalizar superioridad o inferioridad algorítmica requiere mayor verificación sobre la misma cantidad computacional, el mismo número de muestras, y diferentes densidades de recompensa y familias modelo.
10. ¿La cantidad de cálculo en el momento de la prueba aumenta el rendimiento?
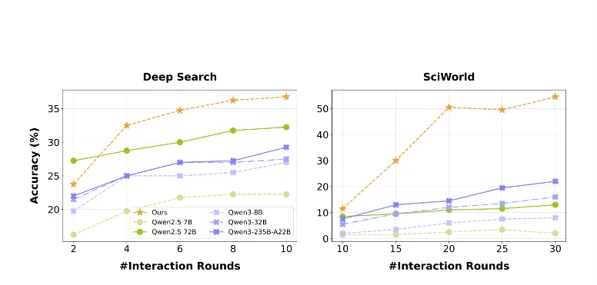
Figura 6. Documento Figura 8: Cambio de precisión al aumentar el número máximo de interacciones en Búsqueda profunda y SciWorld. Fuente: Xi et al., p. 17.
La precisión generalmente aumenta a medida que el número de interacciones aumenta de 2 a 10 vueltas en Búsqueda profunda, y de 10 a 30 vueltas en SciWorld. El agente aprendido supera el modelo de referencia incluso con menos giros y mantiene su superioridad a medida que aumenta el número de giros. Esto muestra que la computación de tiempo de prueba del agente puede escalar no sólo con los tokens internas de inferencia, sino también con interacciones adicionales con el ambiente del mundo real.
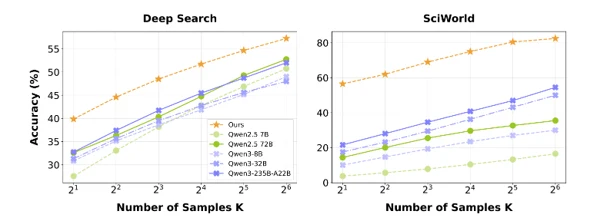
Figura 7. Gráfico 9: Cambio de rendimiento de Pass@K al aumentar el número de muestras paralelas K. Fuente: Xi et al., p. 17.
Pass@K, que genera múltiples trayectorias en paralelo y comprueba si alguien tiene éxito, también aumenta a medida que aumenta el número de muestras. El documento informa que en 64 muestras, el modelo de aprendizaje por refuerzo superó el modelo de base en 5.5 puntos en Búsqueda profunda y 7.05 puntos en SciWorld. Sin embargo, este método puede aumentar significativamente los costos y retrasos en el servicio real, por lo que el diseño del producto requiere un equilibrio entre la tasa de éxito y el presupuesto computacional.
11. Análisis de casos: ¿Qué ha cambiado el aprendizaje de la reforzamiento?
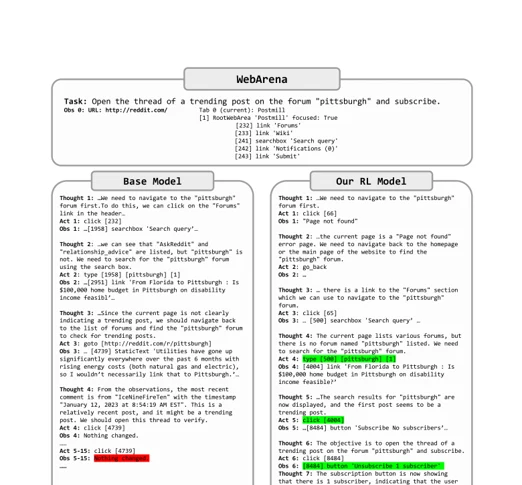
Figura 8. Gráfico 10: Comparación de trayectorias de acción del modelo básico y modelo RL en WebArena. Fuente: Xi et al., p. 19.
El modelo básico no pudo aprovechar el hecho de que, en una asignación para suscribirse a publicaciones populares en un foro de Pittsburgh, la pantalla no cambió a pesar de repetidos clics en el mismo elemento de texto. Por otro lado, el modelo de aprendizaje por refuerzo tuvo éxito navegando a la página incorrecta y luego tomando medidas en el siguiente orden: volver, buscar el foro, seleccionar el resultado de la búsqueda, y confirmar el botón de suscripción.
El cambio importante en este caso no es simplemente un aumento del conocimiento. Políticas de acción mejoradas que utilizan la retroalimentación ambiental para reconocer el fracaso, cambiar a un camino diferente, y comprobar las condiciones de terminación. Desde una perspectiva de memoria de patente, hay margen para especificar tal recuperación de errores, supresión de comportamientos repetitivos y determinación del estado de logro de objetivos como términos independientes o diseños industriales de compensación.
12. Lo que el artículo realmente demostró y lo que no demostró
Ámbito probado directamente por el artículo. Un oleoducto de aprendizaje por refuerzo en línea de múltiples giros puede ser operado en cinco tipos de entornos digitales. El método de expandirse desde un horizonte corto hasta un horizonte largo muestra una curva de aprendizaje más estable que el ajuste de giro fijo. Los modelos 3B y 7B mejoran significativamente sobre el modelo de referencia a través de múltiples parámetros de referencia de agentes. El rendimiento de las pruebas puede aumentar a medida que aumenta el número de interacciones y el número de muestras paralelas.
Ámbito aún no probado. La generalización y transferencia a entornos, herramientas y estructuras de recompensa completamente nuevos, robots físicos del mundo real o servicios reales con largas horas de trabajo y limitaciones de seguridad, colaboración/competición de múltiples agentes y toma de decisiones conjuntas con las personas requieren una verificación adicional. Además, la conclusión de que es consistentemente superior en todos los modelos comerciales y en todas las condiciones de evaluación no está respaldada por este documento únicamente.
Un punto que necesita ser leído críticamente. Aunque las comparaciones de rendimiento en el documento son muy impresionantes, el número de muestras de evaluación e interfaces para cada entorno son diferentes, y algunas asignaciones web excluyen las operaciones de cambio de estado. Además, la conclusión de “modelos comerciales que no funcionan” es fuerte en ciertos ambientes, como BabyAI y SciWorld, pero no se encuentra con los mejores modelos comerciales de WebArena y Deep Search.
13. Puntos de invención desde la perspectiva de un abogado de patentes especializado en patentes de inteligencia artificial
Lo siguiente es una interpretación desde una perspectiva de práctica de patentes derivada del contenido publicado del documento. La novedad real, la actividad inventiva, el alcance de los derechos y la posibilidad de infringir deben determinarse mediante principios jurídicos específicos de cada país y una búsqueda separada de la literatura patentada y no patente.
13.1 Dividir el concepto de invención en cinco capas
El concepto de invención puede dividirse en cinco capas. El algoritmo central es un método de aprendizaje por refuerzo multi giro que aumenta gradualmente el número máximo de interacciones entre agentes y entornos a medida que avanza el aprendizaje. La estructura del sistema se basa en un marco modular que separa Medio Ambiente, Agente y Capacitación y los conecta a través de una interfaz de cliente-servidor estandarizada, y el flujo de datos puede describirse como una tubería de aprendizaje en políticas que recopila trayectorias en un entorno paralelo y actualiza la política calculando recompensas y probabilidades de registro.
El núcleo de la tecnología de estabilización es el control para reducir el colapso del aprendizaje limitando la varianza inicial y la exploración improductiva con un corto horizonte y luego expandiéndose a un largo horizonte, y la tecnología de operación se puede resumir como un método para gestionar la tasa de éxito y el presupuesto computacional ajustando el número de interacciones y el número de muestras paralelas en el momento de la prueba.
13.2 El candidato más fuerte de la derecha es ScalingInter-RL
Aunque la estructura modular de AgentGym-RL es práctica, es probable que el concepto mismo de separación de entornos, agentes y estudiantes y conectarlos a HTTP sea ampliamente utilizado en los marcos de software. Por otra parte, la estructura que aumenta el número máximo de interacciones en conjunción con la etapa de aprendizaje del refuerzo y suprime el colapso inicial del aprendizaje del horizonte fijo largo es el punto experimental más claro del artículo.
Sin embargo, si usted reclama el amplio concepto de aprendizaje curricular de "progresar de tareas fáciles a tareas difíciles", hay una alta posibilidad de que va a entrar en conflicto con el estado de la técnica. Las afirmaciones deben revelar una combinación de una variable de control específica llamada horizonte de interacción, generación de trayectoria en la política, recompensa terminal o recompensa de trayectoria, actualización de políticas, condición de transición paso y aumento máximo de giro.
14. Consecuencias desde una perspectiva de negocio y producto
Las aplicaciones directas de AgentGym-RL son productos que requieren múltiples acciones y retroalimentación ambiental, como automatización de tareas web, agentes de búsqueda, agentes de juego, robots virtuales y asistentes de experimentos científicos. Especialmente en servicios donde el número de acciones necesarias para el éxito varía dependiendo del usuario y la tarea, es importante diseñar un diseño que ajuste el presupuesto de interacción basado en la dificultad y fiabilidad en lugar de fijarlo.
Durante la fase de producción, usted necesita optimizar no sólo la tasa de éxito más alta, sino también el costo de llamadas ambientales, el número de sesiones del navegador, latencia, la tasa de acción de repetición, la tasa de recuperación de errores y las condiciones de cierre seguras. Los resultados de escalado de tiempo de prueba del periódico muestran que más vueltas y muestras pueden mejorar el rendimiento, pero los servicios reales requieren políticas dinámicas que reflejen limitaciones presupuestarias computacionales.
Consecuencias prácticas. La competitividad de un agente de inteligencia artificial no se determina únicamente por el número de parámetros modelo. Cómo interactúa con el medio ambiente, el diseño de recompensa que convierte las fallas en señales de aprendizaje, y las políticas operativas que determinan cuándo aumentar su presupuesto de acción pueden ser tan importantes puntos de propiedad intelectual como el tamaño del modelo.
15. Limitaciones del artículo y cuestiones de investigación de seguimiento
1. Aunque el rendimiento de Indomain es alto, su capacidad de generalización para entornos completamente nuevos y nuevas herramientas no ha sido suficientemente verificada.
2. La mayoría de los desafíos permanecen en la simulación digital, y siguen existiendo desafíos a largo plazo, incluyendo las limitaciones físicas del mundo real y el ruido de los sensores.
3. El marco actual se centra en un solo agente, y la colaboración y la competencia de múltiples agentes son temas de investigación futuros.
4. Las mezclas químicas de SciWorld fallaron todos los modelos, y algunas tareas científicas resultaron en errores de procedimiento donde los estudiantes trataron de responder con hechos memorizados en lugar de experimentos.
5. En WebArena, el problema de la interactividad excesiva se mantuvo, con clics innecesarios y desplazamiento incluso después de llegar a la página de destino.
6. El documento presenta un plan para divulgar código y datos, pero la reproducibilidad real requiere una confirmación separada del alcance de la divulgación y el entorno de ejecución.
7. Las reglas de transición del horizonte de interacción deben ser más automatizadas y teóricamente justificadas.
16. Conclusión
AgentGym-RL trata el aprendizaje por refuerzo del agente LLM como un problema de sistema integrado que conecta diversos entornos, en lugar de como código para puntos de referencia individuales. La parte más destacable es ScalingInter-RL. Al principio, cuando el agente aún no ha adquirido las aptitudes básicas, la libertad de acción es limitada y a medida que la política se vuelve más estable, se aumenta la duración de la interacción para mejorar la capacidad de toma de decisiones a largo plazo.
Los resultados experimentales muestran que incluso el pequeño modelo 7B puede competir con modelos mucho más grandes con el aprendizaje por refuerzo adecuado y las interacciones de tiempo de prueba. Al mismo tiempo, la brecha entre WebArena y Búsqueda Profunda, los errores del procedimiento científico y la interacción excesiva revelan claramente que la inteligencia del agente aún no está completa.
Desde una perspectiva de patente, la clave no es la idea amplia de “aplicar el aprendizaje por refuerzo a los agentes de IA”, sino la combinación específica de resolver los problemas técnicos de alta variabilidad y desaprendizaje en los despliegues a largo plazo con el control gradual del horizonte de interacción. En el futuro, ajustar automáticamente el horizonte basado en estadísticas de recompensa y estabilidad política y optimizar el costo en el momento de la prueba puede convertirse en una diferenciación técnica más fuerte.
Conclusión de una línea: Los agentes de IA fuertes no se construyen para comportarse durante mucho tiempo desde el principio, pero pueden ser entrenados para aprender éxitos cortos y luego explorar más tiempo.
Este artículo del archivo refleja la situación en su fecha de publicación. Contacte con el despacho para analizar su caso.