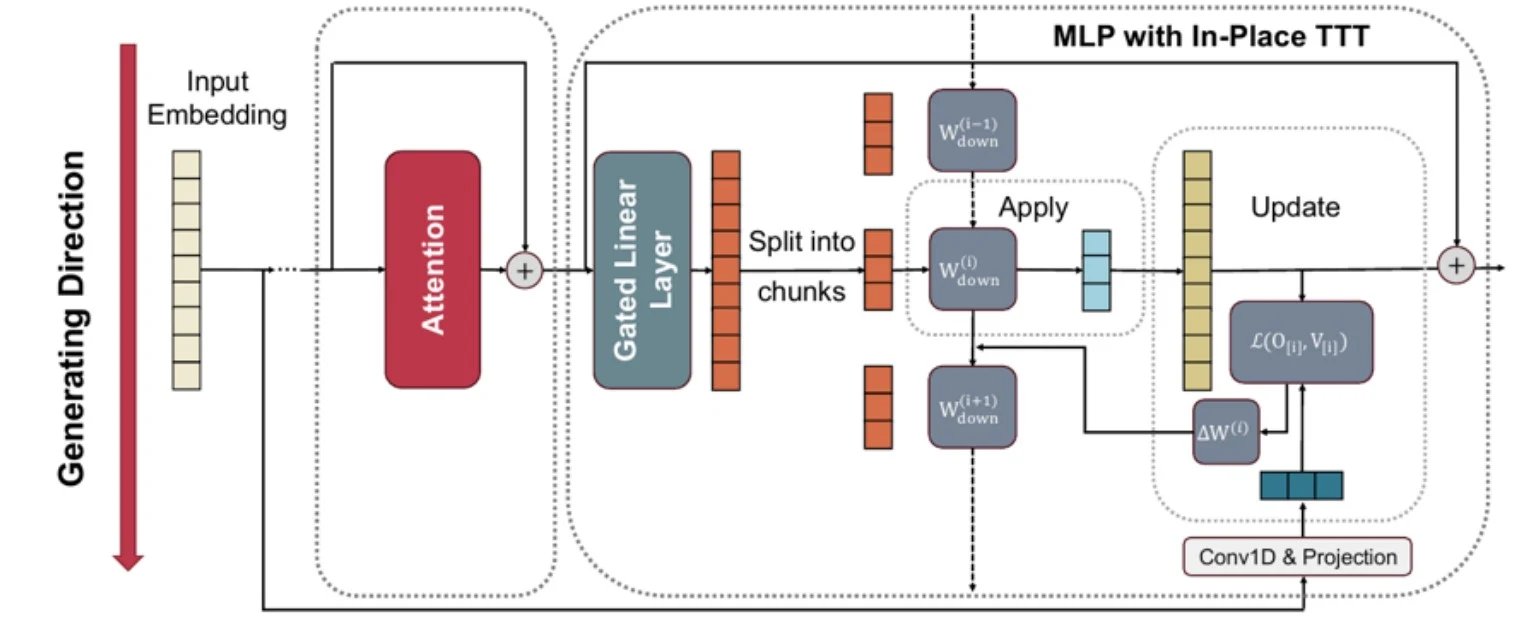
Sin la fórmula, los dos caminos de proyección de la MLP cerrada se combinan para crear un valor de activación intermedia Z, y la Wdown actual se aplica a Z para obtener la salida O. Después, la cantidad de actualización ΔWdown de Wdown se calcula utilizando las expresiones de destino V y Z. La forma simplificada presentada en el artículo es ΔWdown = pira · VT · Z.
Figura 1. Estructura general de TTT en ejecución. Se mantiene la atención y sólo se actualiza el Wdown del MLP con pesos rápidos. Fuente: Feng et al., documento p. 6, Figura 1.
La ventaja práctica de este diseño es que los cambios estructurales son pequeños. En lugar de insertar un nuevo módulo de memoria grande con inicialización aleatoria, tomamos la matriz de salida de un MLP que ya tiene capacidades de lenguaje como punto de partida. El periódico llama a este aumento de la entrada.
Una cosa a señalar aquí es que la expresión drop-in no significa que no se requiere aprendizaje adicional. En el experimento Qwen3-4B, se impartió formación continua sobre aproximadamente 20B tokens en contextos de 32k y aproximadamente 15B tokens en contextos de 128k. En otras palabras, la clave es que puede comenzar desde un punto de control existente sin reemplazar completamente la estructura modelo o pre-aprendizaje desde cero.
3. Principio básico 2: Aplicar los trozos primero y actualizar más tarde
El TTT en capa divide la secuencia de entrada en múltiples pedazos. En cada trozo, los pesos rápidos actuales se aplican primero para crear una salida, y luego Wdown se actualiza con la activación intermedia y los valores de destino obtenidos de ese trozo. La matriz actualizada se utiliza a partir del siguiente trozo. Esta secuencia es de aplicación-entonces-actualización. thesis pp. 4-5.
El orden de operación es el siguiente: El primer trozo se procesa como un Wdown inicial pre-entrenado, y el siguiente estado Wdown se crea utilizando Z y el objetivo V obtenido de ese trozo. El segundo trozo se procesa con este Wdown actualizado y luego la actualización que se utilizará para el tercer trozo se calcula de nuevo. Lo importante es que la salida de la corriente se produce siempre desde su estado pre-actual. Mantener este orden evita las fugas donde la corriente rebote pre-refleja su respuesta correcta información.
La capa TTT existente también jugó el artículo de un mezclador token que reemplazaba la atención, por lo que se necesitaban pequeños trozos. Por otro lado, en el TTT de En-Place, la atención es responsable de interacciones token detalladas dentro de un trozo, y los pesos rápidos MLP son responsables del estado de adaptación más allá del trozo. El documento explica que gracias a esta división de roles, el rendimiento fue bueno incluso para grandes trozos como 512 o 1024.
4. Principio básico 3: Predecir el siguiente token, no restaurar el token actual
Los TTT existentes generalmente utilizan el objetivo de restaurar la representación de el token de entrada actual. Sin embargo, lo que un modelo de lenguaje debe realmente hacer bien no es reproducir el token actual en sí mismo, sino predecir el siguiente token basado en el contexto hasta ahora. El artículo ve esta discrepancia como el problema principal.
La representación objetivo se obtiene aplicando una convolución unidimensional y una proyección aprendible Wtarget a los embeddings X0: V̂ = Conv1D(X0) · Wtarget. Al ajustar el núcleo, el objetivo puede incorporar el siguiente token o una combinación de tokens futuros cercanos. La actualización se simplifica a ΔWdown = η · V̂ᵀ · Z. Véase la página 5 del artículo.
Por ejemplo, en el patrón de A seguido por B, A seguido por B puede aparecer anteriormente en el contexto, y luego A puede aparecer de nuevo más adelante en el contexto. Los objetivos de reconstrucción tienden a trabajar mirando A y almacenando una representación de A en sí, mientras que los objetivos alineados con LM miran A y almacenan una representación de la B que la sigue. Por lo tanto, pesos rápidos pueden funcionar en la dirección de aumentar el logit de B cuando A reaparece.
5. Análisis teórico: ¿Por qué aumenta el registro de la respuesta correcta?
El teorema 1 del artículo analiza una situación simplificada en forma de cabeza de inducción. El token clave y el siguiente token de valor aparecen una vez en el frente, y cuando la misma llave aparece de nuevo en la parte posterior, tienes que adivinar el siguiente token de valor. Bajo la suposición de que las incrustaciones de token son casi ortogonales entre sí y que las activaciones medianas de la misma clave están alineadas, los objetivos alineados con LM aumentan significativamente el logit esperado de la token correcta y apenas cambian el logit de otros tokens. Por otra parte, el objetivo de reconstrucción no está garantizado para aumentar el logit correcto. thesis pp. 5-6, Apéndice A.
Estos resultados teóricos deben interpretarse dentro de sus límites. El teorema 1 no ofrece una garantía para todos los LLM y todas las entradas: analiza el valor esperado bajo supuestos como la ortogonalidad aproximada de las representaciones vectoriales y la alineación entre claves y consultas. Aunque aporta una base teórica para explicar los resultados experimentales, no debe interpretarse como una garantía general de rendimiento.
6. Context Parallelism: Cómo calcular las actualizaciones secuenciales en paralelo
Aunque las actualizaciones de giro son conceptualmente secuenciales, los deltas de actualización en el artículo son aditivos y asociativos. Los investigadores utilizan esta propiedad para calcular el ΔW de cada pedazo en paralelo, obtener la actualización acumulativa hasta justo antes de cada trozo utilizando la suma prefijo exclusiva, y luego calcular la Wdown efectiva y la salida requerida para cada pedazo en paralelo. thesis pp. 6-7, Algoritmo 1.
En aplicación, el valor de activación intermedia Z y la actualización delta ΔW en todos los trozos se calculan primero en paralelo, y luego se realiza un análisis prefijo para resumir sólo los deltas hasta el trozo actual. Este delta acumulado se añade a la Wdown inicial para crear los pesos rápidos que se utilizarán por cada trozo, y la salida de cada pedazo se calcula en paralelo.
Los límites de la trama manejan el acolchado y los límites para asegurar que la convolución generada por el objetivo no tire de la información futura de otros pedazos. Cuando se termina un documento independiente, los pesos rápidos se reasientan al estado pre-aprendizaje para evitar fugas de información entre documentos.
En la evaluación a largo plazo de Qwen3-4B, se garantizó la estabilidad numérica limitando la norma Frobenius del delta de actualización a un umbral de 1e-5. Apéndice C.2
En nuestra implementación, en lugar de aplicar TTT a cada capa MLP, lo aplicamos a cada sexto bloque MLP para controlar el tamaño del estado y el costo computacional. La expresión objetivo se construyó para contener la señal de predicción de los tokens futuros cercanos utilizando el Conv1D profundo y Wtarget del tamaño del kernel 5. Conv1D se inicializa a 0 y Wtarget se inicializa a una forma diagonal escasa para que las actualizaciones iniciales comiencen en aproximadamente 0. Además, en los límites de los documentos, Wdown fue devuelto al estado de pre-aprendizaje para evitar fugas de contexto entre secuencias independientes, y actualizar el clipping de norma se utilizó para evitar que las actualizaciones acumulativas se inundaran en secuencias largas.
7. Resultados del experimento: ¿Cuánto ha mejorado el rendimiento del contexto a largo plazo de LLM?
7.1 Capacitación continua para Qwen3-4B
Los investigadores entrenaron Qwen3-4B-Base y un modelo al que se aplicó el TTT In-Place utilizando el mismo plan de estudios de formación continua. Usamos unos tokens de 20B a 32k de longitud, unos tokens de 15B a 128k de longitud, y extendimos RoPE con YaRN a 128k pasos. La métrica de evaluación es la precisión media RULER, que mide el uso del largo contexto de texto. thesis pp. 7-8.
Mirando los resultados de RULER de Qwen3-4B por longitud de contexto, en 4k, el TTT en ejecución fue de 96.1, 0,5 puntos más bajo que el nivel de referencia 96.6. Sin embargo, en 8k mejoró en 1,5 puntos de 94.1 a 95.6, en 16k mejoró en 0,6 puntos de 92,1 a 92,7 y en 32k mejoró en 0,60 puntos de 88,7 a 89,3.
La mejora fue mayor en contextos más largos. La mayor mejora se observó en 64k con un aumento de 4,4 puntos de 74,3 a 78,7, a 128k fue 2,2 puntos más alto de 74,8 a 77,0, y a 256k más allá de la duración de la formación fue 2,2 puntos más alto de 41,7 a 43.9. Por lo tanto, en lugar de decir que siempre es superior en contextos cortos, es más preciso interpretarlo como una tendencia para que la ventaja aumente a medida que el contexto se hace más largo.
La mayor mejora es de +4.4 puntos a 64k. Mantuvo +2.2 puntos a 128k y 256k más allá de la duración del entrenamiento, respectivamente. Sin embargo, en 4K, fue 0,5 puntos más bajo. Por lo tanto, en lugar de resumir este documento como un método que siempre es superior incluso en contextos cortos, es más preciso leerlo como una tendencia en la que la ventaja aumenta a medida que el contexto se hace más largo.
7.2 Mejoras en LLaMA-3.1-8B y Qwen3-14B
Cuando se aplicó la misma idea a otras familias y tamaños modelo, se mejoró el rendimiento de 64k. El LLaMA-3.1-8B aumentó de 81.6 a 83.7, y el Qwen3-14B aumentó de 67.9 a 70.6. Incluso en el entorno de 64k donde YaRN se aplicó a Qwen3-14B, mejoró de 81.3 a 82.5, mostrando que puede ser utilizado en paralelo con la técnica de ampliación de la ubicación incrustando. Paper p. 8, cuadro 2.
También se confirmaron mejoras en otros modelos básicos. La puntuación RULER 64k para LLaMA-3.1-8B aumentó en 2,1 puntos de 81,6 a 83,7 y Qwen3-14B aumentó en 2,7 puntos de 67,9 a 70,6 puntos. Incluso en el entorno de 64k aplicando YaRN a Qwen3-14B, hubo una mejora de 1,2 puntos de 81,3 a 82,5.
7.3 Comparación al aprender desde cero
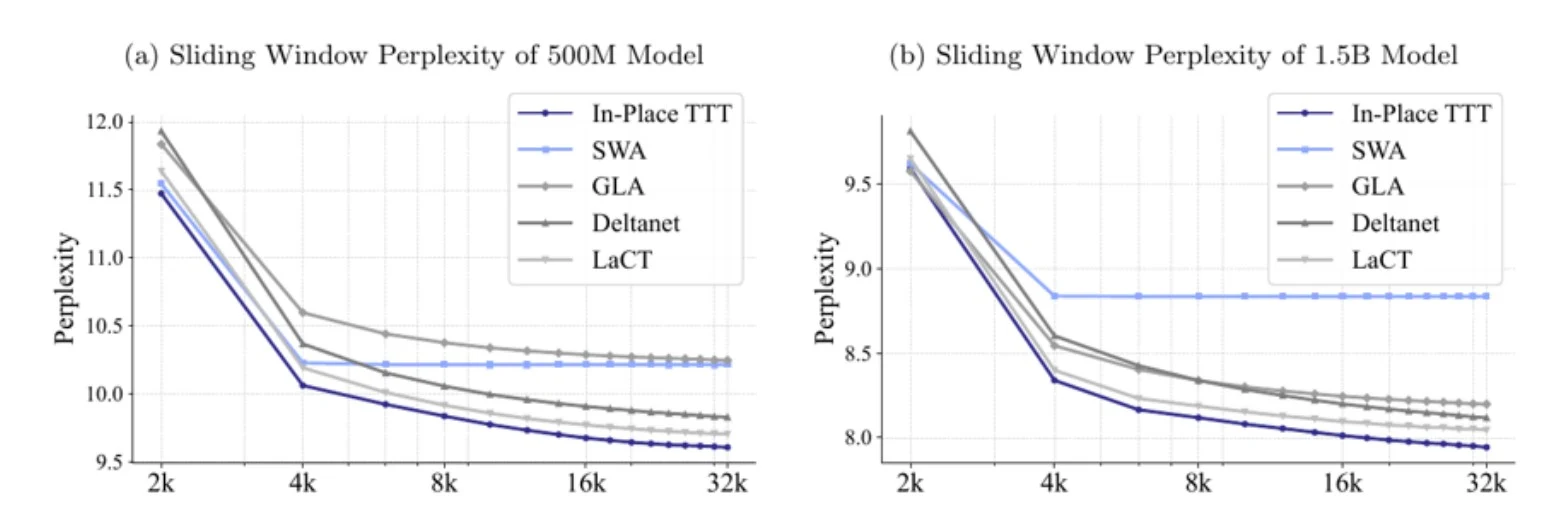
A escala 500M y 1.5B, lo comparamos con Sliding Window Atención, Gated Linear Atención, DeltaNet y LaCT. La perplejidad de la ventana deslizante en la Figura 2 es un indicador de cuánto disminuye la dificultad de predicción del último bloque cuando se proporciona un contexto anterior largo, y el menor el mejor. TTT en el espacio tenía la perplejidad más baja para ambas escalas de modelos de 2k a 32k. Paper p. 9.
En el modelo 4B, el TTT de encaje se añade a la atención completa y a la atención de ventanilla deslizante. Los cambios en la tarea de razonamiento de sentido común eran generalmente pequeños, pero se observaron mejoras significativas en la larga RULER.
Un experimento de aprendizaje desde cero a escala 4B también mostró mejoras en el rendimiento de RULER largo. En plena atención, 4k aumentó en 4.21 puntos de 45.77 a 49.98, 8k aumentó en 5.73 puntos de 38.09 a 43.82, y 16k aumentó en 13.41 puntos de 6.58 a 19.99.
En Sliding Window Atención, había algunas áreas donde la mejora era mayor. RULER 4k mejoró en 13.56 puntos de 14.77 a 28.33, 8k mejoró en 16.89 puntos de 9.91 a 26.80, y 16k mejoró en 2.50 puntos de 5.07 a 7.57. El punto clave de este experimento es que, aunque los cambios en la tarea de razonamiento del sentido común eran generalmente pequeños, hubo una clara mejora en RULER, que requiere un largo contexto de texto.
7.4 Ablación: Lo que realmente importa
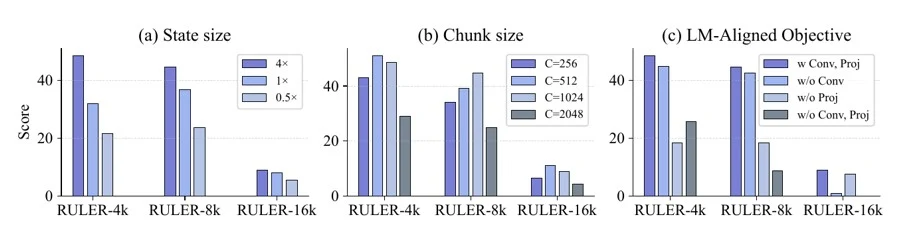
Figura 3. Resultados de la comparación de rendimiento mientras se elimina el tamaño del estado, el tamaño del trozo y los componentes del objetivo alineado con LM. Fuente: Paper p. 10, Figura 3.
Los resultados de la ablación muestran que cuanto mayor es el tamaño del estado de pesos rápidos, mayor es el rendimiento de RULER, apoyando la ventaja del diseño de reutilizar una matriz MLP grande como estado dinámico. Los tamaños gruesos de 512 y 1024 fueron los más competitivos, y el artículo evalúa 1024 como una opción ventajosa al considerar la eficiencia. Además, el mejor rendimiento se logró al utilizar Conv1D, que crea información de token futura, y proyección Wtarget, que convierte la representación, juntos. Conv1D desempeñó un papel particularmente importante en los contextos largos, y la proyección desempeñó un papel especialmente importante en los contextos cortos.
7.5 Eficiencia: ¿Es pequeño el sobrecabezamiento en comparación con la mejora del rendimiento?
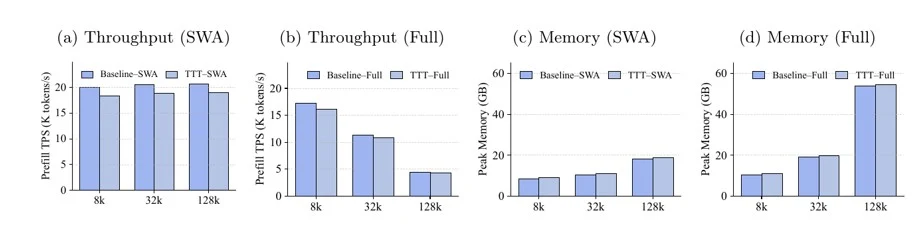
Figura 4. Comparación del rendimiento prefijo y la memoria máxima en el contexto de 8k·32k·128k en el ambiente H800. El documento evalúa que la sobrecarga práctica es pequeña. Fuente: Paper p. 10, Figura 4.
Mirando el gráfico, al aplicar TTT en el espacio, el rendimiento disminuye ligeramente y la memoria aumenta ligeramente, pero la diferencia no es grande en comparación con el costo de la atención misma, especialmente en contextos largos. Sin embargo, esta conclusión es una medición previa en las condiciones específicas de Nvidia H800, tamaño de lote 1, y aplicación de papel. Los resultados no se generalizan con el costo de servicio multiusuario, pasos de decodificación y varios hardware.
8. Lo que el artículo realmente prueba y lo que aún no ha probado
Es necesario distinguir entre el alcance que el documento ha mostrado y el alcance que aún no se ha mostrado. Aunque vimos mejoras en RULER y perplejidad de ventanas correderas en el contexto a largo plazo, no podemos garantizar que el rendimiento mejorará automáticamente en todas las tareas de razonamiento o agente a largo plazo. La compatibilidad modelo también se ha confirmado mediante la formación continua en la escala 4B a 14B de Qwen3 y LLaMA, lo que no significa que pueda aplicarse inmediatamente a los puestos de control arbitrarios sin aprendizaje adicional.
Además, los pesos rápidos siguen cambiando dentro de un documento o secuencia, pero se reasientan cuando el documento termina, por lo que no mantienen el conocimiento persistente en todas las sesiones. En términos de eficiencia, el rendimiento y la sobrecarga de memoria eran pequeños en el entorno prefill del H800, pero no se evaluó el costo total de la etapa de decodificación, el despliegue a gran escala y el entorno multiteniente. Aunque la estabilidad numérica de las actualizaciones de largo texto se asegura mediante el recorte de la norma, no hay verificación contra los impulsos maliciosos, la corrupción de datos o el envenenamiento de peso rápido. El análisis teórico también está en el nivel de explicar el efecto del objetivo alineado con LM en el logit en un entorno de inducción, y no es un teorema universal que cubre todas las situaciones en realidad.
El punto crítico más importante es que, aunque el documento tiene como objetivo el aprendizaje continuo, la implementación real inicializa pesos rápidos en cada límite de documentos. Por lo tanto, es más preciso ver TTT en pantalla en su etapa actual como un dispositivo de memoria adaptativa o compresión de contexto que funciona dentro de la sesión en lugar de una actualización de conocimiento persistente.
9. El centro de la presente invención desde la perspectiva de un abogado de patentes especializado en patentes de IA
Esta sección es una interpretación práctica de la patente distinta de las reclamaciones experimentales del autor del artículo. Para determinar la novedad real/actividad inventiva, se requiere una búsqueda de arte previa independiente, incluyendo la literatura patentada y no patente.
9.1 Las relaciones combinadas son más importantes que los elementos únicos
Pesos rápidos, entrenamiento en tiempo de prueba, actualización en sentido torcido, transformador FFN como perspectiva de memoria, predicción de token futuro, y análisis de prefijo cada uno tiene ejes de investigación previos. Por lo tanto, enfocar la patentabilidad en la frase simplemente actualizar pesos durante la inferencia probablemente dará lugar a reclamaciones amplias pero débiles.
El concepto de invención relativamente fuerte en este documento es la combinación de las tres capas siguientes:
En este artículo, el concepto de invención relativamente fuerte se puede encontrar en la combinación de las tres capas. En términos de arquitectura, la última proyección de salida del bloque de alimentación hacia adelante del transformador de pre-aprendizaje fue seleccionada como los pesos rápidos para permitir un comienzo cálido sin reemplazar la estructura. En términos de la función de meta, en lugar de restaurar el token actual, creamos una representación objetivo que contiene información sobre uno o más tokens posteriores para alinear la dirección de actualización con la próxima predicción de token del modelo de lenguaje. En términos de ejecución, la matriz pre-actual se aplica al trozo actual, y el delta calculado en el trozo actual se refleja sólo en los trozos posteriores, paralelizandolo con un escaneo prefijo exclusivo.
9.2 Elementos de las reivindicaciones y efecto técnico
Al construir una reivindicación de patente, es importante vincular la combinación de estos elementos con el efecto técnico en lugar de los elementos individuales. En primer lugar, al especificar la proyección de salida del bloque de alimentación hacia adelante como pesos rápidos, se puede hacer hincapié en el efecto de la adaptación dinámica al tiempo que se mantiene la estructura de preaprendizaje. El método Apply-then-update crea el siguiente estado con el delta calculado después de la salida del trozo actual y lo aplica a los trozos posteriores, manteniendo así la causalidad y evitando la fuga de información.
Los objetivos alineados con LM pueden organizarse en construcciones que generen una representación objetivo que contenga información posterior de los embeddings de la corriente actual, almacenando así un contexto útil para la próxima predicción de token. El método grueso, que actualiza la matriz por múltiples tokens en lugar de por token, está ligado al paralelismo de GPU y a la mejora de el rendimiento, y el escaneo prefijo, que calcula el delta de cada pedazo en paralelo y luego lo acumula hasta la parte anterior, se puede ver como una configuración que mantiene simultáneamente significado secuencial y paralelismo contextual. Combinando esto con el restablecimiento del límite de documentos, la fijación de normas y la inicialización cercana a cero, podemos demostrar además los efectos de la prevención de fugas de documentos cruzados, la estabilidad numérica y la preservación del comportamiento inicial.
9.3 Estrategia de aplicación y perspectiva del ejercicio de los derechos
En la estrategia de presentación de solicitudes, separadamente de la reivindicación independiente del método de inferencia, el método de formación continua en sí mismo, que hace posible aprender pesos rápidos, puede ser revisado como una reivindicación independiente. La aplicación paralela de contexto tiene un efecto técnico separado de la eficiencia del hardware, por lo que hay lugar para la separación en métodos de procesamiento paralelo o reclamaciones del sistema. La agrupación de categorías de dispositivos, sistemas de servidores y medios de grabación legibles por computadora puede complementar las entidades de ejecución y la aplicabilidad. Sin embargo, ya que es difícil probar la violación desde el exterior en un proceso en el que el peso sólo cambia dentro del servidor, es necesario considerar componentes que están conectados a pistas identificables externamente tales como archivos de modelo, registros de tiempo de ejecución, API de estado de actualización, código de código de código abierto y trazas de rendimiento/memoria. Además, las cifras de papel, como la mejora del rendimiento a largo plazo y la pequeña sobrecarga, pueden utilizarse como datos para explicar el efecto técnico de una invención de software, pero es importante dejar suficientes encarnaciones reproducibles y rangos de parámetros en la especificación real.
10. Consecuencias industriales: donde puede ser útil
Áreas en las que el TTT es particularmente atractivo son aquellas en las que el contexto es largo, las pautas se repiten dentro del mismo documento o sesión, y releer todas los tokens con atención es una operación costosa. Ejemplos incluyen el análisis de contratos largos y especificaciones de patentes, comprensión de repositorios de código grande, operaciones de registro de agentes largos, análisis de registros de streaming y adaptación de las preferencias de los usuarios dentro de las sesiones.
Por el contrario, el hecho de que los pesos rápidos se actualizan directamente por entrada también significa que la superficie de ataque puede aumentar. Si los contaminantes de entrada maliciosos de memoria temporal, cómo aislar múltiples solicitudes de usuario, cuándo restablecer el estado de actualización, y cómo dejar los registros de auditoría son problemas de diseño importantes en los servicios del mundo real. Estos artículos no fueron probados experimentalmente en el artículo.
11. Preguntas frecuentes
Q1. ¿Es TTT en el espacio igual que el ajuste general?
No es lo mismo. El ajuste fino suele implicar cambios a largo plazo en el modelo utilizando datos y procedimientos de capacitación separados. El TTT de enlace actualiza temporalmente algunas Wdowns mientras procesa la secuencia de entrada y las revierte en los límites de documentos. Sin embargo, se requiere una formación continua para que este mecanismo funcione bien.
Q2. ¿Todos los pesos modelo cambian durante la inferencia?
No. El artículo fija Wup y Wgate de MLP cerrado y utiliza Wdown como pesos rápidos. En experimentos de modelos a gran escala, lo aplicamos a cada sexta capa.
Q3. ¿Es una tecnología que reemplaza a Atención?
No. El diferenciador clave de este documento es que se mantiene la atención y la adaptación MLP la complementa. Debido a que la atención maneja las relaciones token dentro de pedazos, TTT In-Place puede utilizar actualizaciones más grandes de giro.
Q4. ¿La longitud del contexto es virtualmente ilimitada?
No puedes estar tan seguro. El modelo de 128k entrenado era mejor que la base de referencia de 256k RULER, pero la puntuación absoluta fue de 43.9. Esto es evidencia de un mejor uso y extrapolación de oraciones largas, pero no evidencia de una memoria perfecta para un contexto sin restricciones.
Q5. ¿Cuál es la línea más importante desde una perspectiva de patente?
Es una relación de combinación que utiliza la proyección de salida MLP existente del transformador de pre-aprendizaje como pesos rápidos, aplica el estado antes de la actualización al trozo actual, y refleja la actualización calculada como el objetivo, incluyendo información de token subsiguiente, desde el siguiente trozo.
12. Conclusión
In-Place Test-Time Training no propone una arquitectura completamente nueva para aportar capacidades adaptativas dinámicas a LLM. Reinterpretamos el Wdown existente de MLP en un estado que cambia rápidamente y diseñamos un escaneo de sentido torcido adecuado para el propósito del modelo de lenguaje y hardware paralelo. Esta es la parte más interesante, tanto técnica como patentada.
Los experimentos muestran mejoras significativas en RULER y perplejidad de forma larga, pero el drop-in no debe ser malinterpretado como una aplicación sin aprendizaje. Se utilizó un entrenamiento continuo con una escala de token 35B, se reasientan los pesos rápidos en los límites de los documentos, y aún no se ha verificado el agente, la seguridad y el entorno de varios contenedores.
En última instancia, este documento está más cerca de un diseño práctico que convierte el MLP interno de un LLM pre-entrenado en una memoria adaptativa específica de sesión en lugar de completar un LLM permanentemente auto-aprendizaje. Desde una perspectiva de patente, es apropiado enfocarse en la relación que combina la adaptación de Wdown, el objetivo alineado con LM, la causalidad de aplicación-entonces-actualización, y el escaneo contextual en lugar de elementos individuales.
Este artículo del archivo refleja la situación en su fecha de publicación. Contacte con el despacho para analizar su caso.