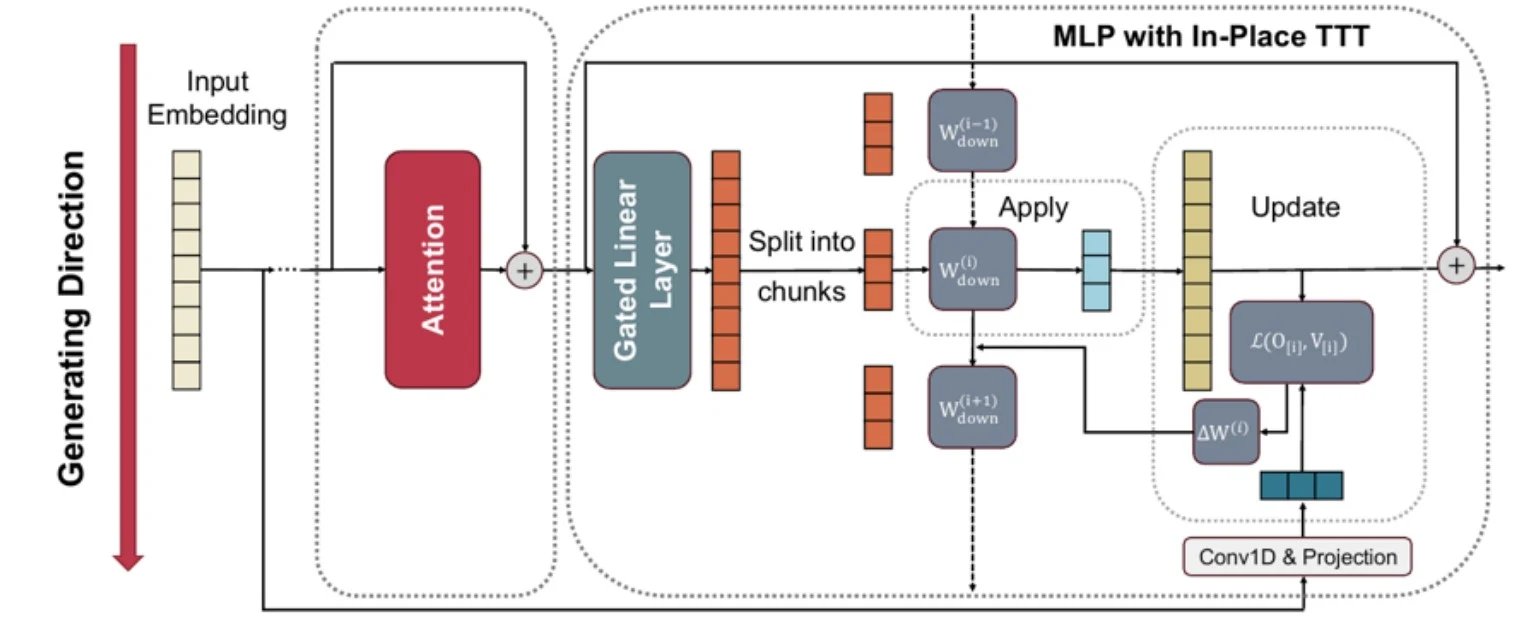
不用公式来理解,就是将门控MLP的两条投影路径组合为中间激活值Z,再对Z应用当前Wdown得到输出O。随后利用目标表示V和Z计算Wdown的更新量ΔWdown。论文给出的简化形式为ΔWdown = η · Vᵀ · Z。
图1 In-Place TTT整体结构. 注意保持,只更新MLP的Wdown,加速度重量. 资料来源:冯等人,论文p. 6,图1。
这种设计的实际优点是结构变化很小. 与其插入新的大型内存模块并随机初始化,不如将已经具备语言能力的MLP的输出矩阵作为起点. 报纸称这种滴滴增强.
这里需要注意的一件事是,表达式的跳跃并不意味着不需要额外的学习. 在Quen3-4B实验中,在32k背景下进行了约20B令牌的连续培训,在128k背景下进行了约15B令牌的连续培训。 换句话说,关键是,你可以从现有的检查站开始,而不完全取代模型结构或从头开始的预学.
In-Place TTT将输入序列分为多个块. 在每一个块中,首先应用当前快速权重来创建输出,然后Wdown通过中间激活和从该块获得的目标值来更新. 从下一个块开始使用更新的矩阵 。 此序列是应用时更新的 。 (原始内容存档于2017-09-25). Thesis pp. 4–5 (英语).
操作顺序如下: 第一块块作为预先训练的初始Wdown处理,下一个状态Wdown是使用Z和从该块获得的目标V创建的. 第二块用这个更新的Wdown处理,然后再次计算用于第三块的更新. 重要的是,当前块的输出总是从其更新前状态产生. 保持此命令可避免当前块预回正确答案信息时发生漏泄.
现存的TTT层也起到了符号搅拌器取代注意力的作用,因此需要小块块. 另一方面,在In-Place TTT中,注意力负责一个块内的详细符号交互,而MLP快重则负责块外的适应状态. 论文解释道,由于这种角色分工,即使是512或1024等大块块的性能也是好的.
4. 核心原则3:预知下一个令牌,而不是恢复当前令牌
现有的TTT通常使用恢复当前输入符的表示目标. 然而,一个语言模型实际上应该做的不是复制当前符号本身,而是根据迄今为止的上下文预测下一个符号. 该文件认为这一差异是核心问题。
目标表示通过对词元嵌入X0应用一维卷积及可学习投影Wtarget得到:V̂ = Conv1D(X0) · Wtarget。调整卷积核可使目标包含下一个词元或邻近未来词元的组合。更新式简化为ΔWdown = η · V̂ᵀ · Z。参见论文第5页。
例如,在A后B的图案中,A后B可能在上下文中出现,然后A可能在后下文中再次出现. 重建目标往往通过审视A和存储A本身的代表来发挥作用,而LM与对应的目标则审视A,并存储后面的B代表. 因此,快速权重可以朝着A重现时增加B的对数的方向工作.
5. 理论分析:正确答案词元的logit为什么上升?
论文的定理1以诱导头的形式分析了一种简化的情况. 键符和下一个值符一次出现在前面,当同样的键符再次出现在后面时,你必须猜下一个值符符. 在信使嵌入物彼此几乎正统,同一密钥的中位激活物对齐的假设下,LM对齐的目标大大增加了正确信使的预期对数,几乎不会改变其他信使的对数. 另一方面,不能保证重建目标能够增加正确的记录。 (原始内容存档于2017-09-25). Thesis pp. 5-6,附录A。
这些理论结果应作有限的解读。 定理1并不是对所有LLMs和所有输入的保证,而是基于嵌入和密钥-query对齐的近似正交性等假设的预期值分析. 因此,虽然它作为解释实验结果的理论基础是有意义的,但不应被解释为一般的性能保障.
6. 背景并行性: 如何并行计算顺序更新
尽管分块更新在概念上是顺序执行的,但论文中的更新增量具有可加性与结合性。研究者利用这一性质,并行计算各块的ΔW,以排他前缀和获得每块之前的累积更新,再并行计算各块所需的有效Wdown及输出。参见论文第6—7页、算法1。
实现时,首先并行计算所有块的中间激活值Z与更新增量ΔW,再进行排他前缀扫描,仅累加当前块之前的增量。将累积增量加到初始Wdown上,得到每块使用的快速权重,然后并行计算各块输出。
Chunk 边界管理挂载和边界,以确保生成目标的进化不会从其他块中牵引未来的信息. 当一个独立的文档完成后,快速权重被重置到学习前状态,以防止文档之间的信息泄漏.
在对Qwen3-4B的长期评价中,通过将更新三角洲的弗罗贝尼乌斯规范限制在1e-5的阈值来保证数值稳定性. 附录C.2。
在执行过程中,我们不将TTT应用于每个 MLP 层,而是将其应用于每六个 MLP 块,以控制状态大小和计算成本. 目标表达式的构建是为了使用内核大小5的深度Conv1D和Wotar来包含近期信使的预测信号. Conv1D初始化为0,Woctar初始化为稀疏的对角形状,以使初始更新开始于约0. 此外,在文档边界上,Wdown被恢复到学前状态,以防止独立序列之间的上下文渗漏,并使用更新规范裁剪来防止累积更新在长序列中淹没.
7.1 Quen3-4B的继续就地培训
研究人员对Qune3-4B-Base进行了培训,并利用同样的连续培训课程对In-Place TTT进行了应用。 我们用了32千米长的约20B个令牌,128千米长的约15B个令牌,并在128千米长的步数上用YARN延长了ROPE. 评价的衡量标准是欧盟驻科法治团的平均准确度,它衡量长文本上下文的使用。 (原始内容存档于2017-09-25). Thesis pp. 7–8 (英语).
从Qwen3-4B按上下文长度计算的结果来看,在4k中,In-Place TTT比基线96.6低96.1,0.5点. 然而,在8k中,从94.1提高到95.6,提高了1.5个百分点;在16k中,从92.1提高到92.7,提高了0.6个百分点;在32k中,从88.7提高到89.3,提高了0.6个百分点。
在较长的时间内,情况有了更大的改善。 最大的改进是64k,4.4分从74.3升至78.7,128k,2.2分从74.8升至77.0,256k,超过训练长度,2.2分从41.7升至43.9。 因此,与其说在短期内总是优越的,更准确的解释是,随着环境变长,优势会增加。
最大的改进是+4.4分,为64k. 它在超过训练时间的128k和256k时分别维持+2.2分. 然而,在4K中,它却降低了0.5分. 因此,不把本文概括为一种即使在短期内也总是优于它的方法,而是将它理解为随着环境变长而优势增加的趋势,更为准确。
7.2 LLaMA-3.1-8B和Qune3-14B的改进
当同样的想法被应用到其他的模范家庭和规模时,64k的性能得到了改进. LLaMA-31-8B从81.6升至83.7,Qune3-14B从67.9升至70.6. 即使在应用到Qwen3-14B的64k设置中,它也从81.3改进到82.5,表明它可以与位置嵌入扩展技术平行使用. 纸本p. 8,表2,第2段。
其他基本模型也证实有改进。 LLAMA-3.1-8B的RULAR 64k分从81.6分增加到83.7分,Qwen3-14B分从67.9分增加到70.6分,增加了2.7分. 即使在将YARN应用到Qwen3-14B的64k设置中,从81.3到82.5的1.2分都有改进.
7.3 从零开始学习时的比较
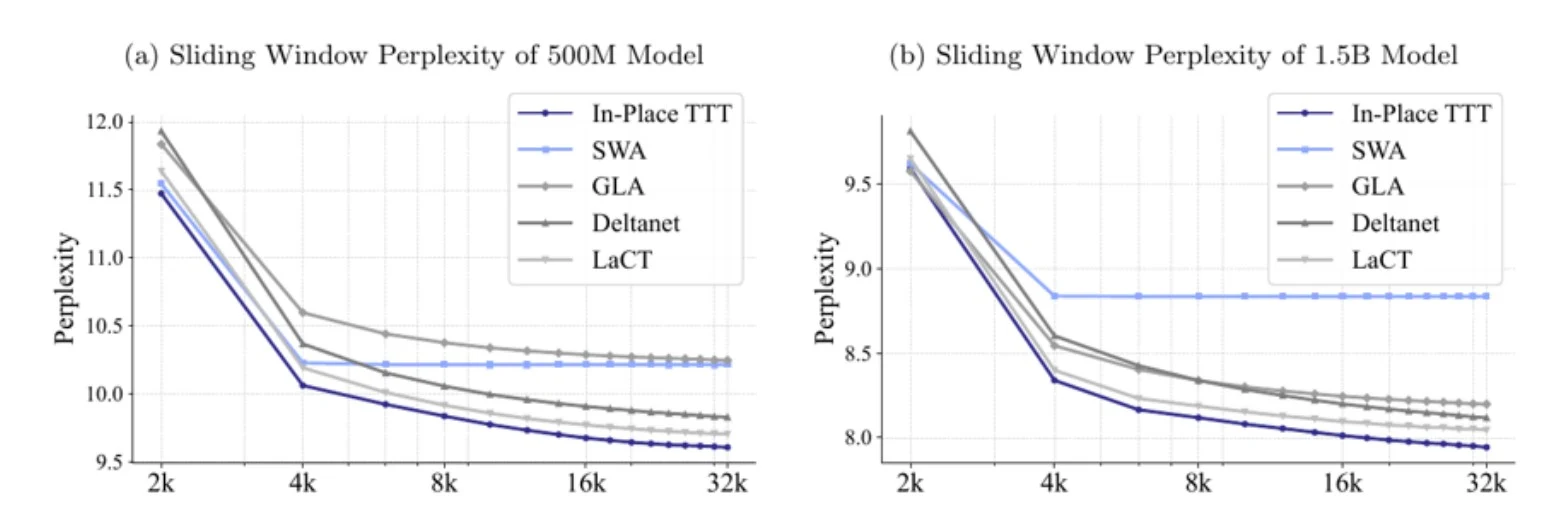
在500M和1.5B的尺度上,我们把它与滑动窗口关注,Gated Linear关注,DeltaNet,和LACT相比较. 图2中的滑动窗口复杂度是一个指标,说明在提供很长的上下文时,最后一个区块的预测难度会减少多少,越低越好。 在两个模型的比分中,In-Place TTT的复杂度最低,从2k到32k。 纸本p. 9. 与《公约》有关的其他事项
在4B模式中,In-Place TTT被添加到全注和滑动窗口关注中. 常识推理任务的变化一般很小,但长期法治团有了显著改善。
在4B尺度上从零开始的实验学习也显示,RULAR的长期性能有所改善。 在"全注"中,4k增加了4.21分,从45.77分增至49.98分,8k增加了5.73分,从38.09分增至43.82分,16k增加了13.41分,从6.58分增至19.99分.
在滑动窗口注意中,有些领域的改进更大。 RULAR 4k改进了13.56个点,从14.77到28.33个,8k改进了16.89个点,从9.91到26.80个,16k改进了2.50个点,从5.07到7.57个. 这一实验的关键点是,虽然常识推理任务的变化一般很小,但RULAR有明显的改进,这需要较长的文字上下文.
7.4 偏差:真正重要的问题
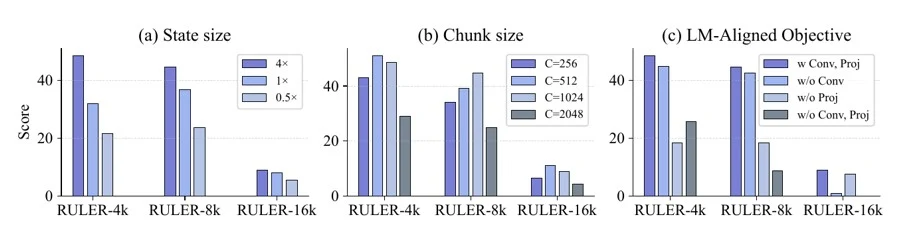
图3 性能比较的结果,同时去除状态大小,块大小,以及LM对齐目标的组件. 资料来源:Paper p. 10,图3.
减速结果显示,快重的状态尺寸越大,RULAR性能越高,支持了将大型MLP矩阵作为动态状态重新使用设计的优势. 512和1024的块大小竞争最激烈,该文件在考虑效率时评价1024是一个有利的选择. 此外,在使用创造未来象征性信息的Conv1D和转换表述的Woctar预测时,取得了最佳业绩。 Conv1D在长时期内发挥了特别重要的作用,预测在短时期内发挥了特别重要的作用。
7.5 效率:与业绩改进相比,间接费用是否很小?
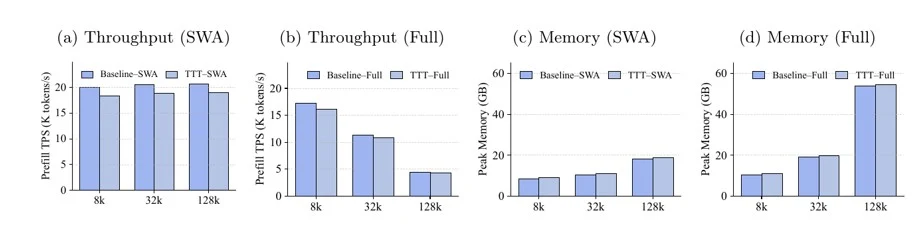
图4 H800环境下8k-32k-128k语境中的预填吞吐量和峰值内存比较. 论文评价认为,实际的间接费用很小. 资料来源:Paper p. 图4。
查看图,应用In-Place TTT时,吞吐量略有下降,内存略有增加,但与关注本身的成本相比,差异并不大,特别是在长时间内. 然而,这一结论是在Nvidia H800、批量尺寸1和纸张执行等具体条件下的预填量度。 其结果并不泛指多用户服务、解码步骤和各种硬件的成本。
8. 报纸到底能证明什么? 还没有证明什么?
有必要区分该文件所显示的范围与尚未显示的范围。 虽然我们看到了欧盟驻科法治团的改进和长期情况下的滑动窗口的模糊性,但我们不能保证,在所有长期推理或代理任务中,业绩将自动改善。 通过在Qwen3和LLaMA的4B至14B尺度上进行持续培训,模型兼容性也得到了确认,这并不意味着可以立即适用于任意的检查站,而无需额外学习。
此外,快速权重在文档或序列中不断变化,但在文档结束时被重置,因此不会在会话中保持持续的知识. 在效率方面,吞吐量和内存间接费用在H800的预填环境中是很小的,但是解码阶段,大规模部署,以及多租户环境的总成本没有得到评价. 虽然长文本更新的数字稳定性是通过规范裁剪确保的,但是对于恶意的提示,数据腐败,或快重的中毒,并没有进行核查. 理论分析也处于解释LM-对齐目标在诱导环境下对登录的影响的层面上,并不是涵盖现实中所有情况的通用定理.
最重要的关键点是,虽然该文件旨在不断学习,但实际执行在每个文件边界上启动快速权重。 因此,在现阶段将In-Place TTT看成一个在会话内运行的适应性内存或上下文压缩设备,而不是一个持续的知识更新,更为准确.
9. 从专门研究AI专利的专利代理师的角度来看,本发明的中心
本节是对专利不同于纸作者实验性主张的实用解释. 为了确定实际的新颖/创造性,需要单独进行包括专利和非专利文献在内的现有技术搜索。
9.1 综合关系比单一因素更重要
快速权重,测试-时间训练,分块更新,变形器FFN作为内存视角,未来令牌预测,以及前缀扫描各有之前的研究轴. 因此,仅仅在推理期间更新权重就把专利权放在这一短语上,很可能导致广泛但软弱的索赔。
本文中相对强烈的发明概念是以下三层的结合:
在本文中,相对强烈的发明概念可以在三层的组合中找到. 在架构方面,从预习变形器的向导块中最后的输出投影被选为快速的权重,以便在不取代结构的情况下实现温暖的开始. 在目标功能方面,我们没有恢复当前符号,而是创建了包含一个或多个后续符号信息的目标表示方式,以使更新方向与语言模型的下一个符号预测一致. 在执行方面,对当前块应用了更新前的矩阵,当前块中计算出的三角洲只反映在后续的块中,与独有的前缀扫描平行.
9.2 索赔内容和技术影响
在提出权利要求时,重要的是将这些要素的组合与技术效果而不是单个要素联系起来。 首先,通过将向导区块的产出预测定为快速权重,可以强调在维持学习前结构的同时实施动态适应的效果。 应用-当时更新方法用当前块输出后计算出的三角洲创建下一个状态,并将其应用于后续块,从而保持因果关系并防止信息泄露。
LM 相匹配的目标可以组织成构造,生成一个目标表示,包含从当前块嵌入的随后的符号信息,从而存储用于下一个符号预测的有用上下文. 块法是通过多个符号而不是符号来更新矩阵的,它与GPU并行主义相关联,并改进了吞吐量,前缀扫描法,它同时计算每个块的三角形,然后累积到之前的块,可以看作是同时保持顺序意义和上下文并行主义的配置. 结合到文档边界重设,规范裁剪,和近零初始化,我们可以进一步展示防止跨文档泄漏,数值稳定性,以及保持初始行为的效果.
9.3 实施战略和权利行使观点
在应用策略中,除了对推理方法的独立主张之外,持续训练方法本身使得快速的权重能够学习,可以作为一个独立主张来审查。上下文并行执行具有硬件效率的单独技术效应,因此存在分离为并行处理方法或系统索赔的空间。将设备、服务器系统和计算机可读录音媒介等类别结合起来,可以补充执行实体和可执行性。 然而,由于在只有服务器内部重量变化的进程中很难证明来自外部的侵权,所以有必要考虑那些与外部可识别线索相连的组件,如模型文件,运行时日志,更新状态API,开源代码,以及性能/记忆痕迹。此外,长期性能改进和小型间接费用等纸质数字可以作为数据来解释软件发明的技术效果,但重要的是在实际说明书中留下足够的可复制的化身和参数范围。
10个 B. 工业影响:可加以利用的地方
In-Place TTT特别有吸引力的领域是上下文较长,模式在同一文件或会话中重复,而认真重新读取所有符文是代价高昂的操作. 实例包括分析长合同和专利说明书,了解大型代码储存库,记录长代理业务,分析流体记录,以及调整会话内用户的偏好。
反之,快速重量通过输入直接更新也意味着攻击表面可以增加. 恶意输入是否污染了临时内存,如何隔离多个用户请求,何时重设更新状态,如何离开审计日志,是现实世界服务中的重要设计问题. 这些文件没有经过实验测试。
11个 常问问题
问题1. In-Place TTT与一般微调相同吗?
亦不相应. 精细调整通常涉及使用单独的训练数据和程序对模型进行长期修改. In-Place TTT在处理输入序列时临时更新一些Wdown,并在文档边界处返回. 然而,需要不断进行培训,使这一机制运作良好。
问题2. 所有模型的权重在推理期间会改变吗?
没有。 纸张修补了Gated MLP的Wup和Wgate,并使用Wdown作为快速重量. 在大规模模型实验中,我们把它应用到每第六层.
问题3. 这是取代注意力的技术吗?
没有。 本文的主要不同之处在于,人们继续关注这一问题,而MLP的适应对它起到补充作用。 因为注意处理块内的符号关系,In-Place TTT可以使用更大的块式更新.
问题4: 上下文长度几乎无限吗?
你不能这么确定。 128k训练的型号比256k的RALLL的基线要好,但绝对分数是43.9. 这证明长句的使用和推算得到了改进,但并不是无限制上下文的完美内存的证据.
问题5. 从专利角度看,最重要的一行是什么?
它是一种组合关系,它使用学前变形器现有的MLP输出投影作为快速权重,将更新前的状态应用到当前块上,并反映从下一个块中算出的目标更新,包括后续的符号信息.
12. 结论
In-Place Test-Time Train并没有提出全新的架构,为LLM带来动态的适应能力. 我们以快速变化的状态重新诠释现有的MLP的Wdown,并设计了适合语言模型目的和平行硬件的整块扫描. 这是技术上和专利上最有趣的部分。
实验在长文本RULER基准及困惑度指标上取得明显改善,但不应将“drop-in”误解为无需训练即可直接应用。该方法使用了350亿词元规模的持续训练,并在文档边界重置快速权重;其在真实智能体、安全及多租户环境中的表现仍未经验证。
最终,本文更接近于实用设计,将预先训练的LLM的内部MLP转换成一个会话特定的适应性内存,而不是完成永久的自学LLM. 从专利的角度来说,将Wdown在位适应,LM对齐目标,应用时更新的因果关系,以及上下文平行扫描而不是单个元素相结合的关系集中起来是恰当的.