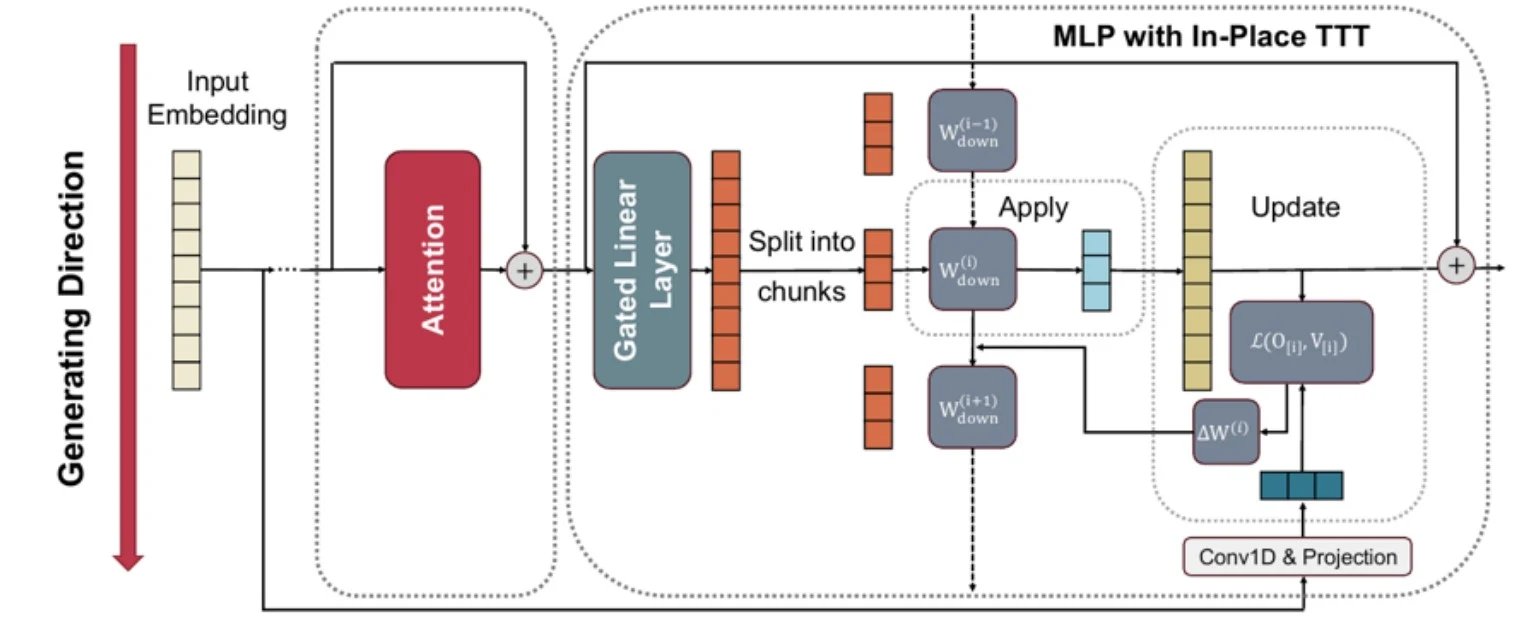
式がなければ、ゲートされたMLPの2つの投影パスは、中間の活発化価値Zを作成するために結合され、出力Oを得るために現在のWdownはZに加えられます。 その後、Wdownの更新量ΔWdownは、ターゲット式VとZを用いて計算されます。 紙に提示された簡略化された形はΔWdown = η・VT・Zです。
図1. 社内TTTの全体的な構造。 注意は維持され、MLPのWdownだけは高速に更新される重み(fast weights)と更新されます。 ソース: Feng ら。、ペーパー p。 6、図1。
この設計の実用的利点は構造変更が小さいことです。 ランダムな初期化で新しい大きなメモリモジュールを投入する代わりに、既に言語能力を持つMLPの出力行列を出発点として取ります。 紙は、このドロップインの強化を呼び出します。
ここで注意すべきのは、式ドロップインが追加の学習を必要としないという意味ではないことです。 Qwen3-4B実験では、32kコンテキストで約20Bのトークンと約128kコンテキストで約15Bのトークンを継続的に訓練しました。 つまり、キーは、モデル構造を完全に置き換えたり、スクラッチから事前に学習することなく、既存のチェックポイントから始めることができるということです。
3。 コア原則2:チャンクを最初に適用し、後で更新して下さい
入出力シーケンスを複数のチャンクに分割します。 各チャンクでは、出力を作成するために、現在の高速重みが最初に適用され、Wdownは、そのチャンクから得られる中間の活性化とターゲット値で更新されます。 更新された行列は、次のチャンクから始まります。 このシーケンスは、application-then-update です。 論文 pp. 4-5.
操作の順番は次のとおりです。最初のチャンクは、あらかじめ訓練された初期のWdownとして処理され、次の状態のWdownは、ZとターゲットVを使用して作成されます。 2番目のチャンクは、この更新されたWdownで処理され、3番目のチャンクに使用するアップデートが再び計算されます。 重要なことは、現在のチャンクの出力が、更新前の状態から常に生成されることです。 この順序を保ち、現在のチャンクが正しい答え情報を事前に反映する漏れを避けます。
既存の TTT レイヤーは、注目を交換するトークンミキサーの役割も果たしましたので、小さなチャンクが必要でした。 一方、In-Place TTT では、注意はチャンク内の詳細なトークン相互作用を担当しており、MLP の高速重みはチャンクを超える適応状態に責任があります。 紙は、この役割の分裂のおかげで、パフォーマンスは512や1024などの大きなチャンクでも良いと説明しています。
4。 Core Principle 3: 現在のトークンを復元しない、次のトークンを予測
既存の TTT は通常、現在の入力トークンの表現を回復する目的を使用します。 しかし、実際に言語モデルは、現在のトークン自体を再現していないが、これまでの文脈に基づいて、次のトークンを予測する。 論文は、コアの問題として、この矛盾を見ます。
目標表現は、トークン埋め込みX0に1次元畳み込みと学習可能な射影Wtargetを適用して生成します。式はV̂ = Conv1D(X0) · Wtargetです。畳み込みカーネルの調整により、次のトークンや近い将来の複数トークンを目標に含められます。更新式はΔWdown = η · V̂ᵀ · Zと簡略化されます。論文5ページ参照。
たとえば、A のパターンが B で続くと、B がコンテキストで初期表示され、A はコンテキスト内で再び表示されます。 LM 整列対象は A を調べて A の表現を格納することで動作する傾向がありますが、LM 整列対象は Aを調べ、それに従う B の表現を格納します。 そのため、高速な重みは、再登場時にBのロイトを増加させる方向で動作させることができます。
5。 5。 理論的分析:正しい回答トークンが上昇するのはなぜですか?
紙の理論1は、誘導ヘッドの形で単純化された状況を分析します。 キートークンと次の値トークンが前面に一度現れ、同じキーが再びバックに現れた場合、次の値トークンを推測する必要があります。 トークンの埋め込みは、それぞれにほぼ正当性であり、同じキーの中央の有効化が整列されていると仮定して、LM 整列対象は、正しいトークンの予想されるログイトを大幅に増加させ、他のトークンのログを大きく変更します。 一方、再構築対象は正しいログを増加させることは保証されません。 論文 pp. 5-6、付録A。
これらの理論的な結果は、限られただけ読むべきです。 Theorem 1 は、すべての LLM とすべての入力に対して保証されるものではありませんが、埋め込みやキークエリアライメントの近接的な正当性など、想定される値解析です。 そのため、実験結果を説明するための理論的な基礎として意味がありますが、一般的な性能保証として解釈されるべきではありません。
6。 。 コンテキスト並列: 並列でシーケンシャル更新を計算する方法
chunk-wise の更新は概念的にシーケンシャルであるが、ペーパーの更新のデルタは添加剤および同化剤です。 研究者は、このプロパティを使用して、各チャンクのΔWを並列に計算し、排他的な接頭辞の合計を使用して各チャンクの前に累積的な更新を得る、そして、各チャンクに必要な効果的なWdownと出力を並列で計算します。 論文 pp. 6-7, アルゴリズム 1.
実装では、中間のアクティベーション値 Z とすべてのチャンクでデルタ ΔW を更新すると、最初に並行して計算され、プレフィックススキャンは、現在のチャンクまでのデルタだけをまとめるために実行されます。 その後、初期のWdownに蓄積されたデルタを追加し、各チャンクで使われる高速に更新される重み(fast weights)を生成し、各チャンクの出力を並列で計算します。
チャンクバウンダリは、ゴール生成のコンボリューションが他のチャンクから将来の情報を引き出すことができないことを確実にするために、パディングと境界を管理します。 独立した文書が終了すると、文書間の情報漏洩を防ぐため、高速な重みが前学習状態にリセットされます。
Qwen3-4Bの長期評価では、更新デルタのフロブニウス規範を1e-5のしきい値に制限することで数値的安定性が確保されました。 付録C.2.
実装では、TTT をすべての MLP 層に適用する代わりに、州のサイズと計算コストを制御するために、6 番目の MLP ブロックごとに適用します。 ターゲット式は、近近未来のトークンの予測信号を、深さのConv1DとカーネルサイズのWtarget 5 で埋め込むように構築されました。 Conv1D は 0 に初期化され、Wtarget は、初期更新が 0 で始まるように、スパースの対角形状に初期化されます。 また、ドキュメント境界では、Wdown は、独立したシーケンス間のコンテクストの漏れを防止するために、事前学習状態に戻り、長いシーケンスの洪水による累積的な更新を防止するために標準クリップを更新しました。
7。 実験結果:LLMの長期コンテクスト性能が向上したのはどれくらいですか?
7.1 Qwen3-4Bのためのドロップインの継続訓練
研究者は、Qwen3-4B-Baseを訓練し、同じ継続訓練カリキュラムを使用して、In-Place TTTが適用されたモデルを訓練しました。 約20Bのトークンを32kの長さで使用し、約15Bのトークンを128k長さで使用し、128kステップでYaRNを拡張しました。 評価メトリックはRULER平均精度で、長いテキストコンテキストの使用を測定します。 論文 pp. 7-8. .
コンテキスト長で4kのQwen3-4BのRULERの結果を見ると、In-Place TTTは96.1、ベースライン96.6よりも低い0.5ポイントでした。 しかしながら、94.1から95.6までの1.5ポイントで改善した8kでは、92.1から92.7までの0.6ポイントが向上し、32kでは88.7から89.3までの0.6ポイントが向上しました。
改善は、より長い文脈で大きくなった。 最大の改善点は、74.3から78.7までの4.4ポイント増加で64kで見られました。128kでは74.8から77.0までの2.2ポイントが増加し、トレーニング長の256kでは41.7から43.9までの2.2ポイントが増加しました。 そのため、短い文脈で常に優れていると言うのではなく、コンテキストが長くなるにつれて増加する利点の傾向としてそれを解釈する方がより正確です。
最大の改善点は、64kの+4.4点です。 それぞれ、トレーニングの長さを超えて128kおよび256kで+2.2ポイントを維持しました。 しかし、4Kでは0.5ポイント下がりました。 そのため、本論文を短い文脈でも常に優れた方法としてまとめるのではなく、コンテキストが長くなるにつれて、その利点が増加する傾向としてそれを読みやすくなります。
LLaMA-3.1-8BおよびQwen3-14Bの7.2の改善
他のモデルの家族やサイズに同じ考えが加えられたとき、64kの性能は改善されました。 LLaMA-3.1-8B は 81.6 から 83.7 までのバラで、Qwen3-14B は 67.9 から 70.6 までバラバラ。 YaRNがQwen3-14Bに適用された64k設定でも、81.3から82.5まで改善され、位置埋め込み拡張技術と並行して使用できることを示しています。 ペーパーp。 8、テーブル2
また、他のベースモデルでも改良が確認されました。 LLaMA-3.1-8BのRULER 64kのスコアは81.6から83.7に2.1ポイント増加し、Qwen3-14Bは67.9から70.6に2.7ポイントによって増加しました。 YaRN を Qwen3-14B に適用する 64k の設定でも、81.3 から 82.5 までの 1.2 ポイントの改善がありました。
7.3 ゼロから学習するときの比較
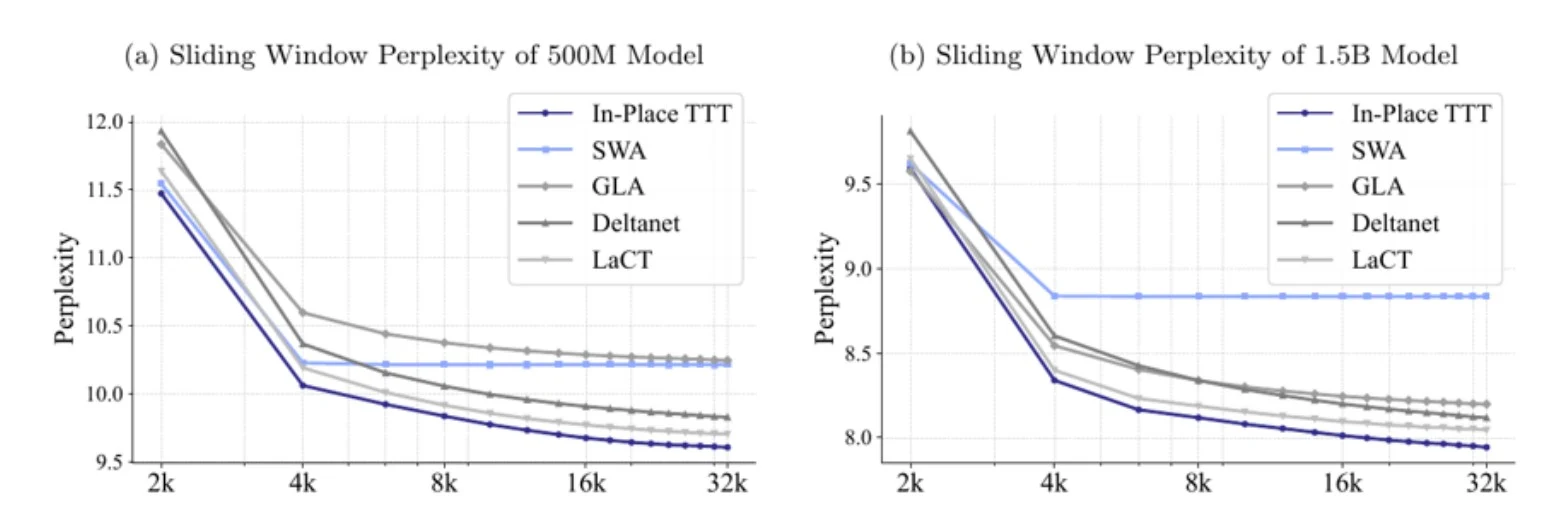
500Mと1.5Bのスケールで、スライドウィンドウの保持、ゲートリニアの保持、DeltaNet、およびLaCTと比較しました。 図2の滑走窓の複雑さは、前回の文脈が提供され、より低いときに、最後のブロックの予測の難しさがどれだけ減少するかの指標です。 2kから32kまでの両方のモデルスケールでTTTが最も低いパープレキシティを持っていた場所。 ペーパーp。 9 月 9 日
4Bモデルでは、In-Place TTT をフルアテンションとスライディングウィンドウアテンションに追加します。 一般的な意味推論タスクの変更は、一般的に小さいが、長いRULERで重要な改善が見られた。
4Bスケールでの実験学習も、長いRULER性能の改善を披露しました。 十分に注意して、4kは45.77から49.98に4.21ポイントによって増加しました、8kは38.09から43.82に5.73ポイント増加し、16kは6.58から19.99までの13.41ポイント増加しました。
滑走窓の注意点では、改善が大きくなった部分がいくつかありました。 RULER 4kは、14.77から28.33までの13.56ポイントで改善され、16.89ポイントは9.91から26.80、および16kは5.07から7.57までの2.50ポイントで改善しました。 この実験の重要なポイントは、一般的な意味推論タスクの変更が一般的に小さいものの、長いテキストの文脈を必要とするRULERの明確な改善がありました。
7.4 アブレーション: 本当に重要
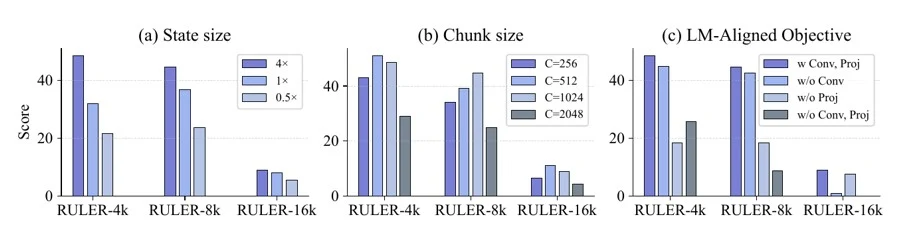
図3。 LM 整列された目的の状態のサイズ、チャンク サイズおよび部品を取除いながら、性能比較の結果。 ソース: ペーパー p. 10、図3
アブレーションの結果は、高速に更新される重み(fast weights)、RULERのパフォーマンスが向上し、大きなMLPマトリックスを動的状態として再利用するという利点をサポートする、より大きい状態のサイズが大きいことを示しています。 512と1024のチャンクサイズは最も競争力があり、効率を考慮すると、紙は1024を有利な選択肢として評価しました。 また、今後のトークン情報を作成するConv1Dと、Wtarget のプロジェクションを組み合わせて表現を変換する際、最高のパフォーマンスが達成されました。 Conv1D は、長い文脈で特に重要な役割を果たし、予測は短い文脈で特に重要な役割を果たしました。
7.5 効率:性能改善と比較して、オーバーヘッドの小型ですか。
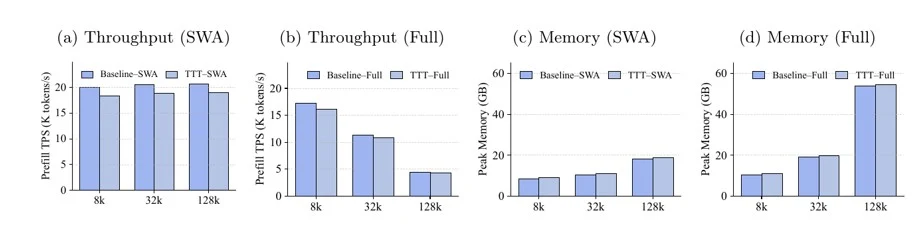
図4. H800環境の8k・32k・128kコンテキストにおけるプレフィルスループットとピークメモリの比較。 論文は実用的な頭上が小さいことを評価します。 ソース: ペーパー p. 10、図4
グラフを見ると、In-Place TTT を適用すると、スループットがわずかに減少し、メモリがわずかに増加しますが、特に長い文脈では、注意自体のコストと比較して、差は大きくありません。 しかし、この結論は、Nvidia H800、バッチサイズ1、紙実装の特定の条件下で満たされた測定です。 結果は、マルチユーザーサービング、デコード手順、さまざまなハードウェアのコストに一般化されていません。
8月8日 紙が実際に証明するものと、それがまだ証明されていないもの
紙が示す範囲とまだ示されていない範囲を区別する必要があります。 RULERの改良や、長期の文脈における窓の複雑さの滑走などを見てきましたが、その性能がすべての長期的な推論やエージェントのタスクで自動的に改善されることを保証することはできません。 また、4Bから14BスケールのQwen3とLLaMAの継続的トレーニングによってモデルの互換性が確認され、追加の学習なしで任意のチェックポイントにすぐに適用することができるという意味ではありません。
また、ドキュメントやシーケンス内では高速な重みが変化していますが、ドキュメントが終わるとリセットされますので、セッション全体で永続的な知識を維持しません。 効率性面では、H800のプレフィル環境では、スループットとメモリオーバーヘッドが小さくなりましたが、デコードステージのトータルコスト、大規模展開、マルチテナント環境の評価はありませんでした。 長いテキストの更新の数値的安定性は規範のクリッピングによって保護されますが、悪意のあるプロンプト、データの破損、または高速な重みの中毒に対する検証はありません。 理論分析は、誘導設定で、LM 整列ターゲットの効果を説明するレベルでも、現実のすべての状況をカバーする普遍的な理論ではありません。
最も重要なポイントは、紙が継続的に学習することを目的としているが、実際の実装は各文書境界で高速に更新される重み(fast weights)を初期化することです。 そのため、永続的な知識更新ではなく、セッション内で動作する適応的なメモリやコンテクスト圧縮デバイスとして、現在のステージでIn-Place TTTを表示する方がより正確です。
9 月 9 日 AI特許に特化した特許弁理士の視点から現在に至る発明の中心
このセクションは、論文の作者の実験的な主張とは異なる特許の実用的な解釈です。 実際の新規性/進歩性を決定するには、特許および非特許文献を含む別の先行技術検索が必要です。
9.1 結合された関係は単一の要素よりより重要です
Fast weights、Test-Time Training、チャンク単位の更新、TransformerのFFNをメモリと捉える視点、将来のトークン予測、prefix scanには、それぞれ先行研究があります。そのため、単に「推論中に重みを更新する」という点を特許性の中心に据えると、範囲は広くても無効化されやすい請求項になる可能性があります。
この紙の比較的強い発明の概念は、次の3層の組み合わせです。
本論文では、比較的強い発明の概念が3つの層の組合せで見つけることができます。 アーキテクチャの面では、前学習トランスのフィードフォワードブロックから最終出力投影が高速な重みとして選択され、構造を交換することなくウォームスタートを可能にしました。 ゴール関数の観点から、現在のトークンを復元するのではなく、その後のトークンについての情報を含むターゲット表現を作成して、言語モデルの次のトークン予測で更新方向を調整します。 実行の観点では、更新前の行列は現在のチャンクに適用され、現在のチャンクで計算されたデルタは、その後のチャンクでのみ反映され、排他的なプレフィックススキャンで並列化します。
9.2 クレーム要素と技術的効果
特許クレームを構成するときは、個々の要素ではなく、これらの要素の組み合わせを技術的効果に結びつけることが大切です。 まず、フィードフォワードブロックの出力プロジェクションを高速重みとして指定することで、事前学習構造を維持しながら動的適応を実装する効果を強調することができます。 Apply-then-update メソッドは、現在のチャンクの出力後に計算されたデルタで次の状態を作成し、その後のチャンクに適用します。したがって、因果性を維持し、情報漏洩を防ぎます。
LM 整列されたターゲットは、現在のチャンクの埋め込みから続くトークン情報を含むターゲット表現を生成し、次のトークン予測のために有用なコンテキストを保存することで構成することができます。 トークンではなく複数のトークンで行列を更新するチャンクメソッドは、GPU並列と改良されたスループットにリンクされ、各チャンクのデルタを並列に計算し、以前のチャンクまで蓄積するプレフィックススキャンは、同時にシーケンシャルの意味とコンテキスト並列性を維持する構成として見ることができます。 文書の境界リセット、規範のクリッピング、およびニアゼロの初期化と組み合わせることで、クロスドキュメントの漏洩、数値的安定性、初期動作の保存を防ぐ効果をさらに実証することができます。
9.3 アプリケーション戦略と権利演習の視点
出願戦略としては、推論方法の独立請求項とは別に、fast weightsを学習可能にする継続学習方法そのものを独立請求項として検討できます。コンテキスト並列の実装はハードウェア効率という別の技術的効果を持つため、並列処理方法やシステムの請求項として分ける余地もあります。装置・サーバーシステム・コンピュータ可読記録媒体の各カテゴリーを用意することで、実施主体に応じた権利行使を補完できます。ただし、サーバー内部だけで重みが変化する処理は、外部からの侵害立証が困難です。モデルファイル、実行時ログ、更新状態API、公開ソースコード、性能やメモリ使用の痕跡など、外部から確認できる手掛かりにつながる構成要素を検討する必要があります。論文に示された長文処理性能の向上や小さなオーバーヘッドは技術的効果の説明資料になりますが、明細書には再現可能な実施例とパラメータ範囲を十分に記載することが重要です。
10月10日 産業影響:それが有用であることができる場所
In-Place TTT が特に魅力的である領域は、コンテキストが長く、パターンは同じ文書やセッション内で繰り返され、注意を払ってすべてのトークンを再読み込みするコストリーな操作です。 長い契約と特許明細書を分析し、大規模なコードリポジトリを把握し、長いエージェントの操作をログに記録し、ストリーミングログを分析し、セッション内でユーザーの好みを適応させます。
逆に、高速に更新される重み(fast weights)が直接入力によって更新されるという事実はまた攻撃面が増加することができることを意味します。 悪意のある入力が一時的なメモリを汚染するかどうか、複数のユーザーリクエストを分離する方法、更新状況をリセットするとき、監査ログを離れる方法は、実際のサービスで重要な設計課題です。 これらの項目は、実験的に論文にテストされていない。
11月11日 よくある質問
Q1。 In-Place TTTは、一般的なファインチューニングと同じですか?
同じではありません。 ファインチューニングは通常、別々のトレーニングデータと手順を使用してモデルへの長期変更を含みます。 入出力シーケンスを処理し、文書の境界でそれらを逆転させる間、TTT を一時的に更新します。 しかし、この機構がうまくいくためには、継続的なトレーニングが必要です。
Q2. 仕様 すべてのモデル重みは、侵入時に変化しますか?
いいえ。 論文は、ゲート付きMLPのWupとWgateを固定し、Wdownを高速に更新される重み(fast weights)として使用します。 大規模モデル実験では、6層毎に適用します。
Q3。 注意を交換する技術はありますか?
いいえ。 この論文の重要な差別化要因は、注意が維持され、MLPの適応はそれを補完することです。 注意は、チャンク内のトークン関係を扱うため、In-Place TTT はより大きなチャンク単位の更新を使用できます。
Q4. 仕様 コンテキストの長さは事実上無制限ですか?
確かにそうではありません。 256k RULERのベースラインよりも128kの訓練されたモデルは、絶対的なスコアは43.9であった。 これは、長い文章の改良された使用と延期の証拠ですが、制限されていないコンテキストのための完璧なメモリの証拠ではありません。
Q5。 特許の観点から最も重要なラインは何ですか?
既存のMLP出力投影を高速な重みとして使用したコンビネーションの関係で、更新前の状態を現在のチャンクに適用し、その後のトークン情報を含む目標として計算された更新を、次のチャンクから反映します。
12月12日 コンクルージョン
In-Place Test-Time Training は、LLM に動的適応機能をもたらすために、まったく新しいアーキテクチャを提案しません。 既存のMLPのWdownを急速に変化させる状態に再解釈し、言語モデルの目的と並列ハードウェアに適したチャンクワイズスキャンを設計します。 これは、技術的に、特許の両面で最も興味深い部分です。
実験では、長時間のRULERとパープレクシリティが大幅に改善されますが、ドロップインは、非学習アプリケーションとして誤解されるべきではありません。 35Bトークンスケールの継続的トレーニングが使用され、ドキュメント境界で高速に更新される重み(fast weights)がリセットされ、実際のエージェント、セキュリティ、マルチテナント環境がまだ検証されていない。
最終的には、この論文は、恒久的に自己学習するLLMを補完するのではなく、セッション固有の適応メモリにあらかじめ訓練されたLLMの内部MLPを変換する実用的な設計に近づいています。 特許の観点から、Wdownの所定の適応、LM-alignedターゲット、適用-update の因果性、個々の要素ではなくコンテキスト並列スキャンを組み合わせた関係に焦点を合わせることは適切です。