
El documento y el problema técnico
US20260065050A1 se publicó el 5 de marzo de 2026 a nombre de DEEPX Co., Ltd. y trata del entrenamiento de redes neuronales y la inferencia con procesadores heterogéneos. El código A1 identifica una solicitud publicada, no acredita una patente concedida. Este análisis no determina su situación jurídica actual ni afirma que DX-M1 incorpore todas las características reivindicadas.
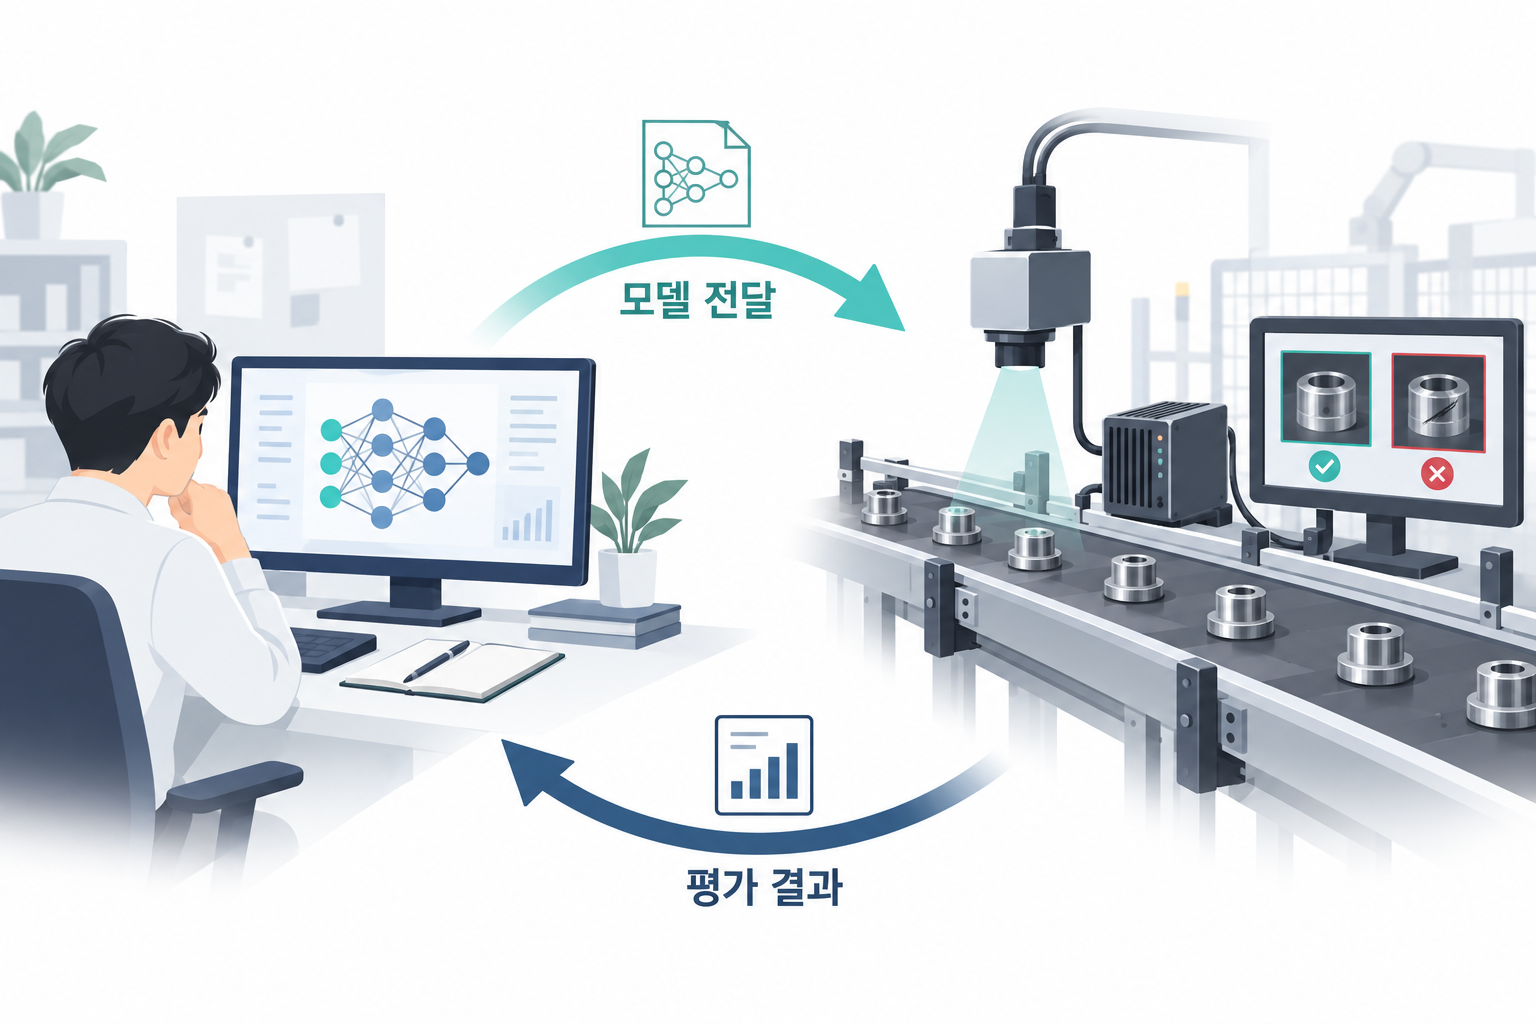
Imaginemos una cámara que detecta arañazos en una línea de producción. El modelo entrenado en un ordenador potente debe ejecutarse junto a la cámara, con otra memoria, operaciones compatibles y limitaciones energéticas. La conversión puede alterar la precisión. Es un ejemplo hipotético, no una instalación de cliente ni una medición de rendimiento.
Entrenamiento e inferencia cumplen funciones distintas
El entrenamiento ajusta parámetros a partir de ejemplos; la inferencia aplica el modelo entrenado a una entrada nueva. Las imágenes etiquetadas de productos sirven para entrenar, y las nuevas imágenes de la línea, para clasificar. La arquitectura descrita asigna el entrenamiento a un primer procesador y la inferencia a un segundo, de configuración diferente y capacidad más limitada.
Desplegar el modelo exige más que copiar un archivo. Hay que comprobar las operaciones admitidas y evaluar su comportamiento después de convertirlo. Que el modelo quepa en el dispositivo no garantiza que siga detectando los mismos defectos.
Pesos, estructura y optimización
Los pesos son parámetros numéricos; la estructura define las etapas de cálculo y sus conexiones. Actualizar unos no equivale necesariamente a modificar la otra. La poda elimina determinadas conexiones o componentes y la cuantización reduce la precisión de representación. Ambas pueden disminuir recursos, pero también afectar a la exactitud y hacer necesario un nuevo entrenamiento.
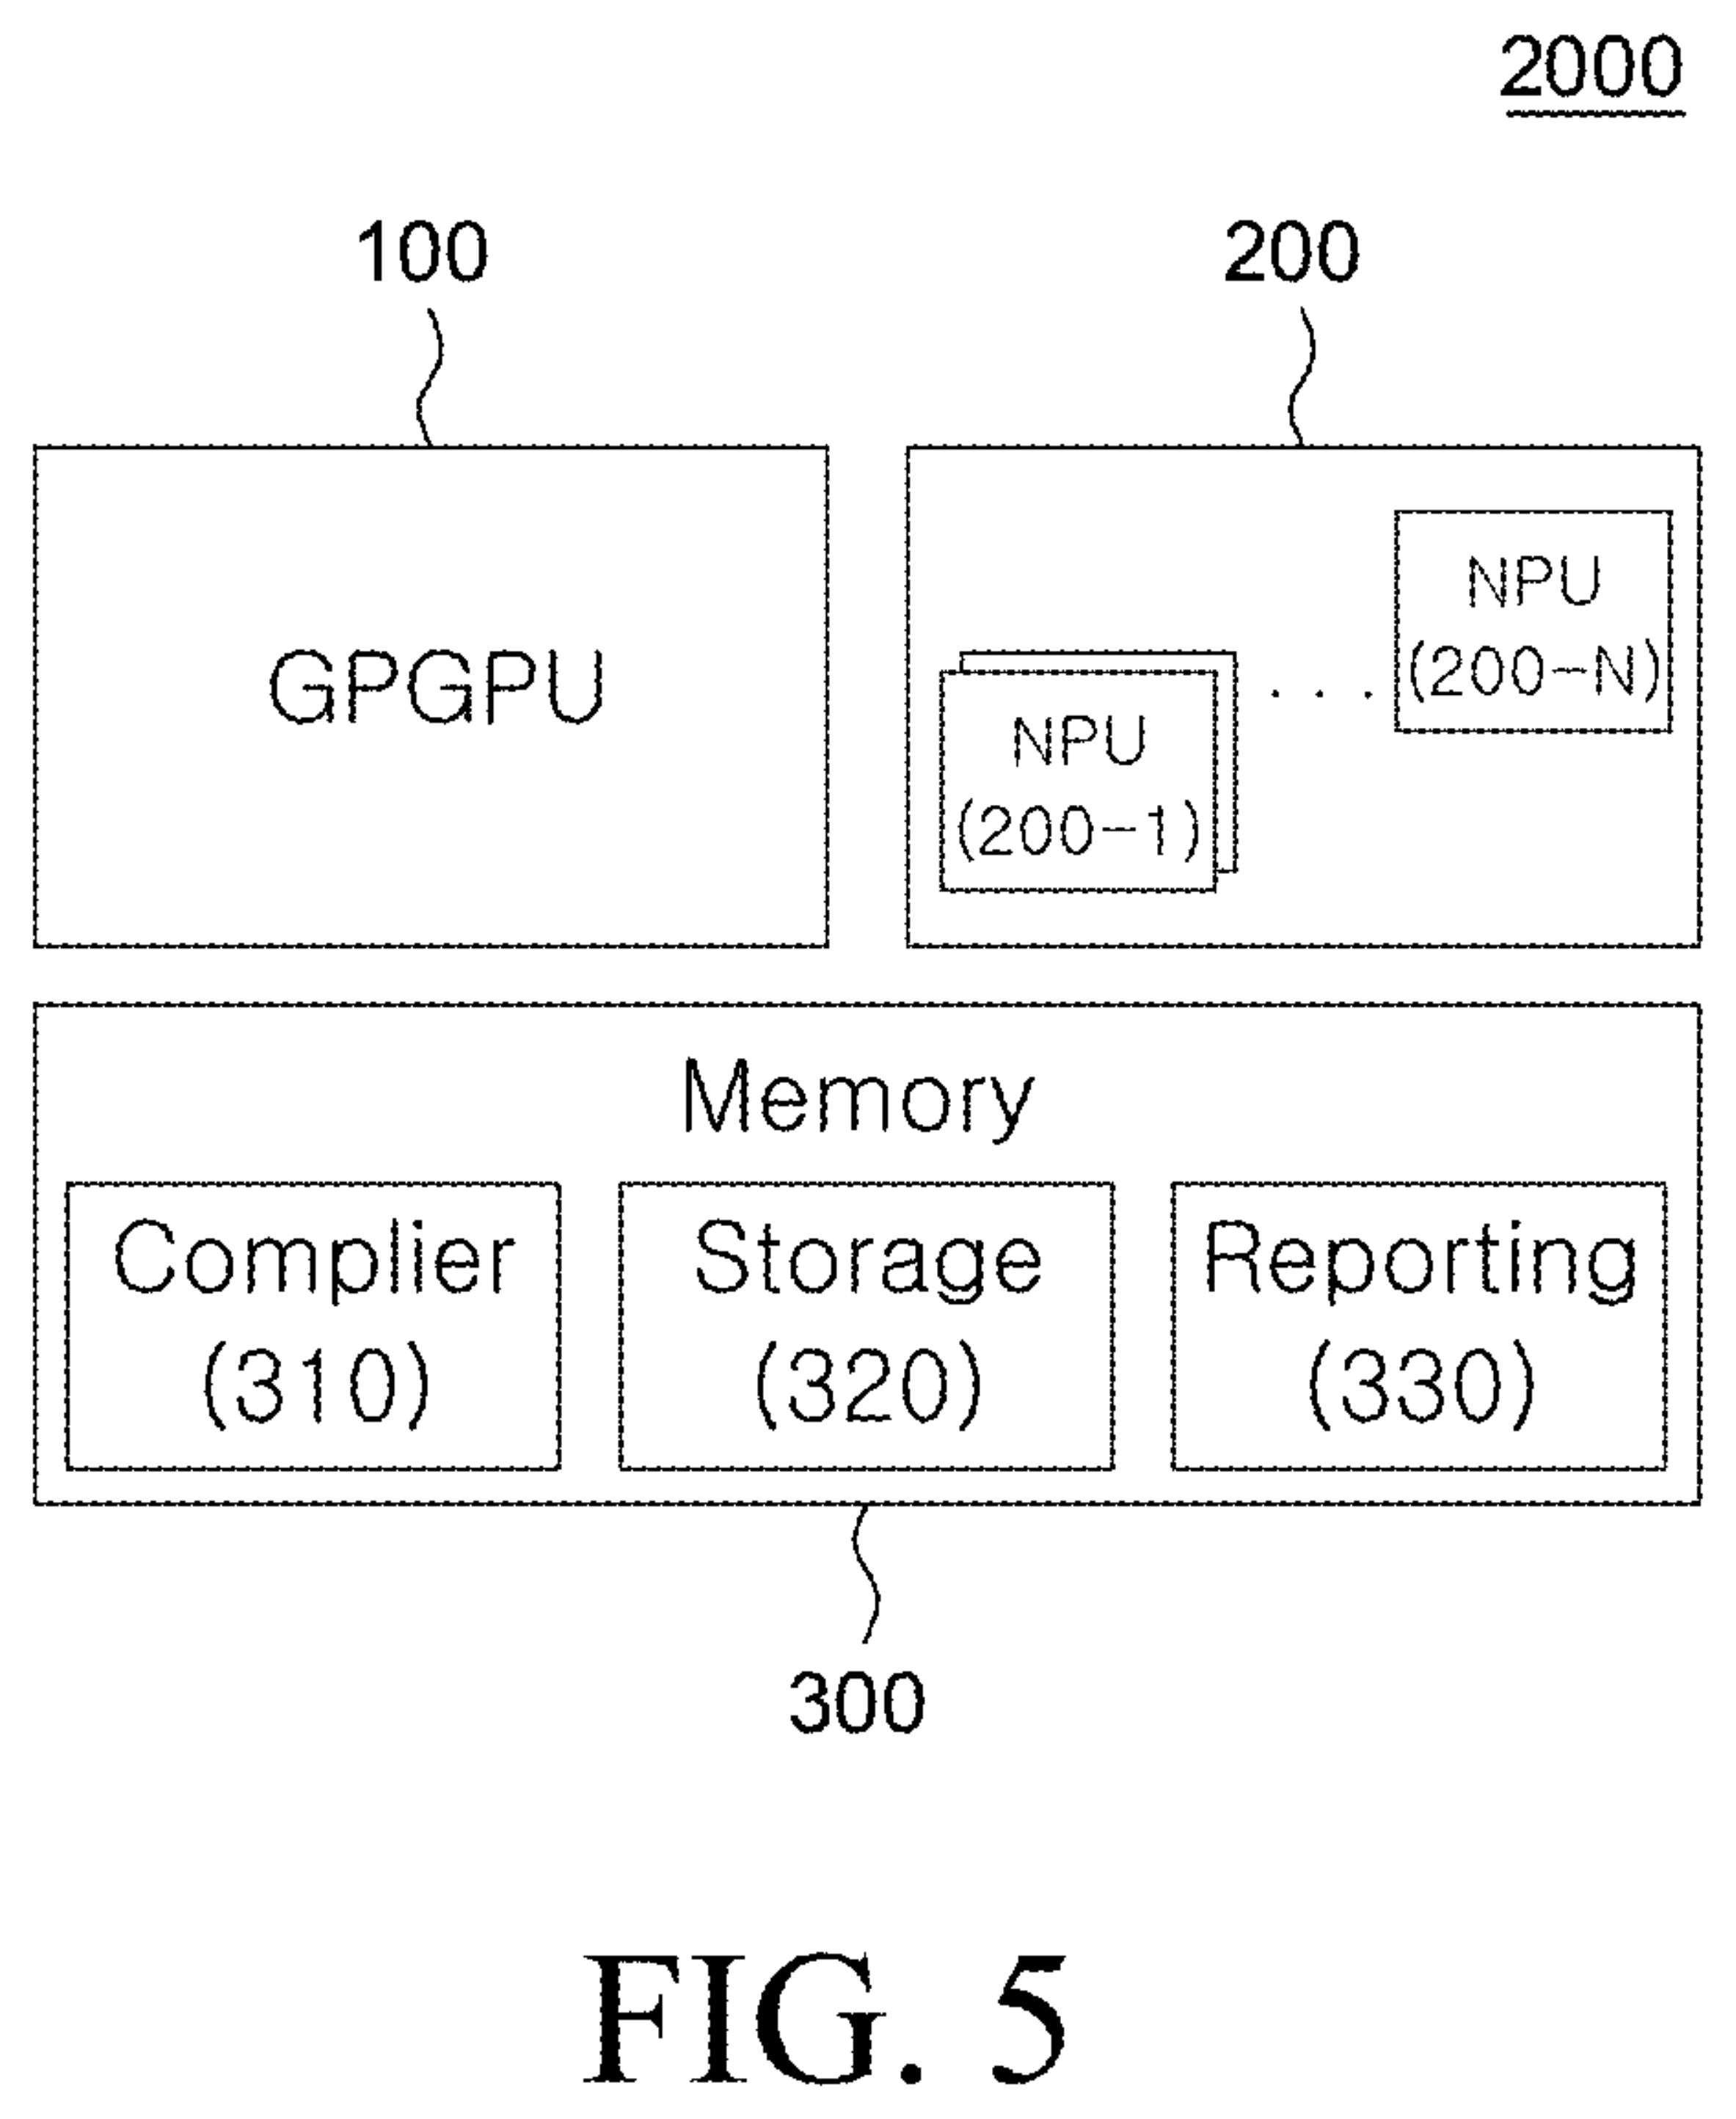
La figura 5 muestra una GPGPU de entrenamiento (100), unidades NPU de inferencia (200) y memoria (300), con compilador (310), almacenamiento (320) e informes de resultados (330). El compilador adapta el cálculo al destino; los demás módulos facilitan conservar e intercambiar modelos y resultados. La figura no acredita la configuración interna de un chip comercial concreto.
La evaluación cierra el ciclo
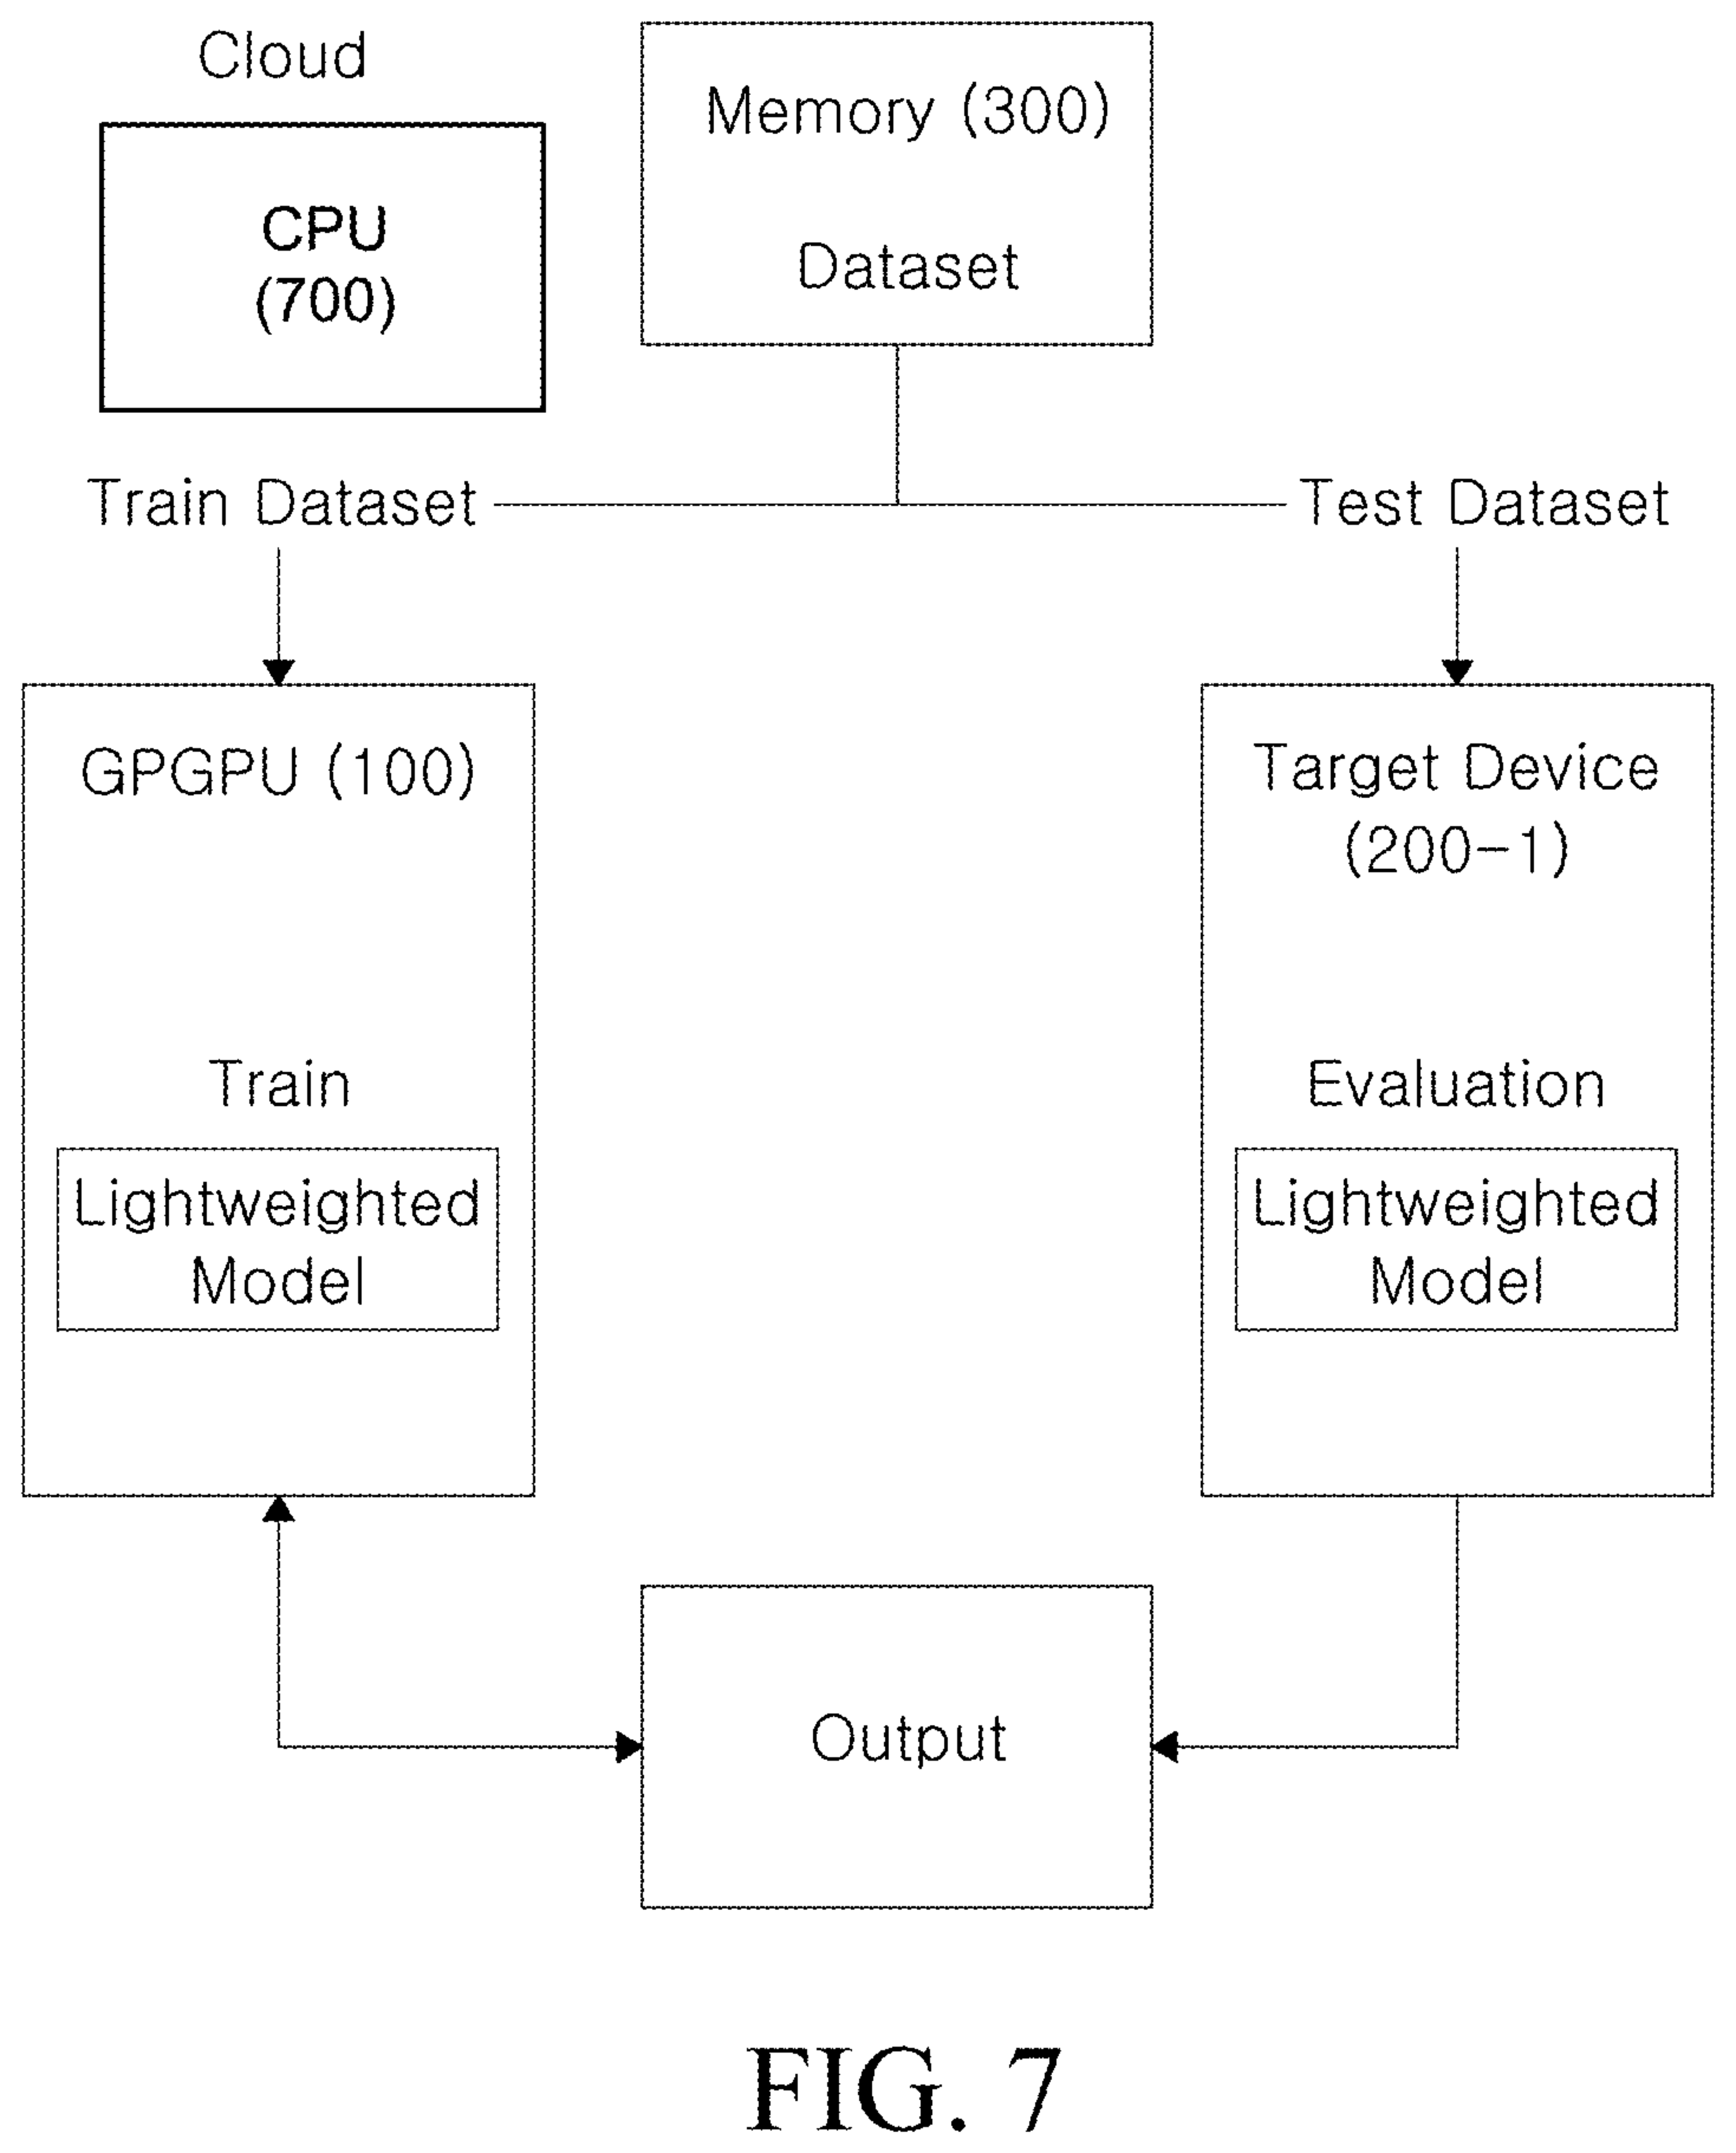
La secuencia comprende entrenamiento, envío de pesos, inferencia y evaluación en destino, devolución de resultados, revisión del modelo y nueva inferencia. El procesador de entrenamiento usa la evaluación para modificar la estructura y actualizar los pesos, que vuelve a remitir para ejecutar el modelo modificado. No se presupone que la NPU de campo realice el reentrenamiento.
La figura 7 separa los datos de entrenamiento para la GPGPU de los datos de prueba para el dispositivo y representa el retorno de resultados. En la fábrica hipotética, imágenes con respuesta conocida permiten detectar omisiones, revisar el modelo y evaluarlo de nuevo en el equipo. El diagrama de la fábrica es explicativo, no una prueba experimental.
GPU, NPU y el contexto de DX-M1
Una GPU permite cálculos paralelos; GPGPU designa su utilización para tareas de propósito general. Una NPU está concebida para operaciones de redes neuronales. La solicitud utiliza entrenamiento en GPGPU e inferencia en NPU como ejemplo, con compilación ajustada a las operaciones y a la representación de datos del destino.
DEEPX presenta DX-M1 como procesador de IA en el borde. La inferencia se ejecuta cerca del origen de los datos, en lugar de enviar cada entrada a un servidor remoto. Puede reducir comunicaciones, pero la latencia, la energía, la memoria y la precisión dependen del sistema. El posicionamiento del producto y el alcance de la solicitud son cuestiones diferentes.
Documentación útil para el análisis de patentes
Interesa precisar cómo la evaluación del dispositivo modifica la estructura y los pesos del siguiente modelo, no únicamente que existan dos procesadores. Conviene documentar sus funciones, los datos intercambiados, las optimizaciones, las condiciones de evaluación y las diferencias entre versiones, separando cambios del grafo de cálculo y actualizaciones paramétricas.
IPLEX presta apoyo en análisis y redacción de solicitudes sobre IA y software. Un esquema no confidencial, una explicación de los cambios técnicos y condiciones reproducibles de evaluación ayudan a identificar la aportación. Los contenidos relacionados sobre IA y aprendizaje durante la prueba aportan contexto, sin equiparar mecanismos distintos de actualización del modelo.
Se conservan las indicaciones originales y se explica su significado técnico en el texto.
Análisis relacionado: actualizar pesos durante la prueba