
著者:IPLEX 知的財産権法律事務所 金容德, 弁理士
最近は人工知能の分野において最もよく聞かれた用語の1つがAIエージェントです。 しかし、エージェントが何であるかを説明しようとすると、スコープは非常に広いです。 一部の人々は、エージェントの検索機能でチャットボットを呼び出しますが、他の人は、計画を立て、エージェントとして様々なツールを実行するためのシステムだけを参照してください。 また、最近では、記憶を更新するためのメカニズム、経験から学び、複数のエージェントの間で役割を分かち合う仕組みが現れています。
この混乱をクリアするために、この論文は、一貫した視点として有価な推論を提示します。 キーワードは、言語モデルがテキストを一度生成しても止まらないことですが、環境と継続的にやり取りしながら、計画、演技、学習のプロセス全体を見ることです。 そのため、新しい単一モデルを提案する研究ではなく、この論文は2025年までの膨大な量の研究を体系的に分類するロードマップに近いです。
本稿の要点は三つです。第一に、エージェント型推論は思考と行動を結び付けます。第二に、論文はこれを基礎的推論、自己進化型推論、協調的推論の三層に整理しています。第三に、同じ機能を推論時のプロンプトやワークフローで実装する方法と、ファインチューニングや強化学習でモデルに学習させる方法があります。
紙基本情報
論文「Agentic Reasoning for Large Language Models」は、エージェント型推論の研究を整理した大規模なサーベイ論文です。Tianxin Wei、Ting-Wei Li、Zhining Liuらが執筆し、イリノイ大学アーバナ・シャンペーン校、Meta、Amazon、Google DeepMind、カリフォルニア大学サンディエゴ校、イェール大学が参加しています。2026年1月18日にarXiv v1として公開され、計画、ツール利用、検索、フィードバック、メモリ、自己進化、マルチエージェント、応用、ベンチマーク、今後の課題を広く扱っています。新しいアルゴリズムを実験で立証する論文ではなく、既存研究の流れと設計上の選択肢を俯瞰するものです。
1。 1。 紙が提示した全体像
論文の最初の図は、サーベイ全体を1ページにまとめています。上部には、利用者が課題を示し、エージェントが解決し、その成果を他の課題にも一般化する流れがあります。中央では、従来のLLM推論からエージェント型推論への移行に伴い、入力は静的な文脈から動的な文脈へ、計算は受動的な生成から相互作用へ、学習は固定された事前学習状態から継続的に変化する状態へと移ることを示しています。
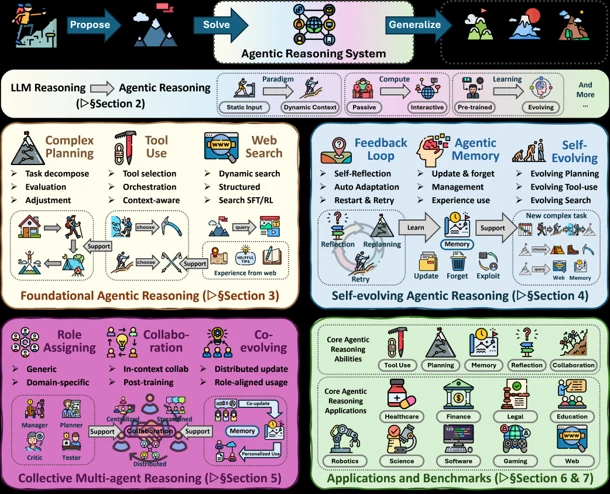
図1. エージェント推論の全体的なマップ。
ソース: Tianxin Wei ら., 大規模言語モデルのための有能な共鳴, 図 1, P. 2。
映像の底部は4つの主要な区域に分けられます。 左上は、計画、ツーリング、Web検索から成るエージェントベースの推論です。 トップ右は、フィードバック、メモリ、自己進化による自己進化するエージェント推論です。 左下は集合的マルチエージェントの推論、役割の割り当て、コラボレーション、共同進化をカバーしています。 これらの機能は、医療、金融、法律、教育、ロボティクス、科学、ソフトウェア、ゲーム、Webなどの分野で使用および評価されている方法を示しています。
一般的なチャットボットがすぐに質問に答えるカウンセラーであるならば、エージェント型システムは目標を確認し、タスクを分割し、必要なデータを見つけ、ツールを実行し、結果が間違っている場合は、プロジェクトマネージャーに近づいています。
重要なことは、ツールを呼び起こすチャットボットと同じくらい、エージェントを狭く表示しないことです。 この論文では、内部文を生成するプロセスには、推論は限られません。 観察するべきこと、次の行動を決めるもの、障害を解釈する方法、記憶する経験、そして他のエージェントと交換する情報はすべて、推論の一部として見られます。
2。 一般的なLMMの推論とエージェント型推論の違い
一般的な言語モデルの推論は、セットプロンプトを受信し、または複数の生成プロセスで回答を提供します。 複数の候補を比較するために考えやテクニックのチェーンを使用する場合でも、実際に外部環境に影響を及ぼさないと、比較的クローズされた計算です。
エージェントベースの推論では、モデルの出力は、次の入力を変更するアクションになります。 検索語を送信しますと、検索結果が返されます。コードを実行すると、エラーメッセージが返され、Webページをクリックすると画面の状態が変更されます。 エージェントは、これらの新しい観察をとり、その計画を変更し、再び行動します。 これは、単一の応答の品質よりも、複数のステージ間で状態管理と回復能力をより重要になります。
一般的なLMMの推論とエージェントのような推論は、入力、計算方法、外部の世界への接続、状態管理、エラー処理、および目標が異なります。 一般的なLLM推論は、通常、入力として固定されたプロンプトをとり、ワンタイム作成または限られた内部探査を実行し、外部の世界への直接アクセスがなく、現在の会話コンテキストに関する状態を管理します。 エラーが発生した場合は、回答を再生成し、目標を閉じて、盗用可能な応答を生成することによって対応します。
一方、エージェント型推論は、アクションの結果に応じて継続的に変化する動的なコンテキストを入力し、思考、行動、観察、変更が繰り返されるマルチステップのプロセスを実行します。 検索、API、コード、ブラウザ、ロボットなどに接続し、外部メモリ、タスクステータス、環境状態を一緒に管理し、エラーが発生した場合は、別のツールで選択、逆転、リプラン、および回復を検証します。 究極の目標は、環境内での目標を達成することです。
そのため、エージェント型推論は、アイデアのチェーンと同義ではありません。 思考のチェーンは内部の計算を延ばす方法かもしれませんが、代理推論は内部の思考を外部の行動に接続し、それらの行動の結果を次の判断に反映するクローズドループを形成します。 長い計画を持つと、自動的にあなたに良いエージェントを作ることはありません。 不正行為を素早く検知し、正しい場所に戻す能力は、より重要である可能性があります。
3。 エージェントベースの推論:計画、ツーリング、検索。
基礎的なエージェント型推論は、複雑で比較的安定した環境において、一つのエージェントが目標を達成するために必要な能力を扱います。論文は、計画、ツール利用、検索の三つに整理しています。実際には相互に結び付き、計画によって不足する情報を特定し、検索で補い、ツールを通じて行動を実行します。
3.1 計画:目標を実用的なステップに変える能力
計画は単なる作業一覧ではありません。現在の状態から次の手順を選び、中間結果を評価し、必要に応じて計画自体を修正します。論文では、ワークフローの設計、木探索、形式化、分解、外部ツールの活用、報酬設計という観点から整理しています。
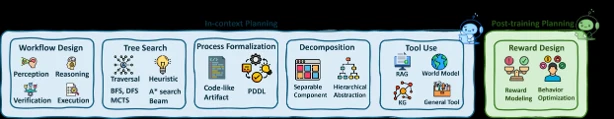
図2. LLMエージェントの計画方法のSchematic分類。
出典:同じ紙、図2、p。 11月11日
- - ワークフロー設計: 認識、推論、実行、検証などの事前のステップを分割し、各ステップが何をすべきかを決定します。
- - ツリーナビゲーション:枝のような複数のオプションをスプレッドアウトし、有望なパスを評価しながら、深さやパントでそれらを探索します。
- - フォーマット: 自然言語だけで計画を離れるよりもむしろ、コード、ステートマシン、グラフ、論理的な表現などの構造を作成します。
- - タスクの分解: 異なるサブゴールに大きな目標を分け、依存関係と実行順序を決定します。
- - 外部ツールの活用:ナレッジグラフ、検索、世界モデル、計算機、コード実行者など あなたの計画プロセスに。
- - ポスト学習: 希望する行動に報酬を割り当てることによって、計画習慣自体はモデルに内部化されるように学習されます。
物品を造る際は、計画の主人より、故障の取り扱いに関するルールが重要になります。 たとえば、決済直前にエラーが発生した場合は、起動したいかどうかをクリアし、最後の成功状態に戻り、ユーザー確認を受け取り、異なる支払い方法を試す必要があります。 これらの状態遷移と回復手順は、実際のエージェントの品質を決定します。
3.2 ツールの使用:外部機能とモデルの制限を補完する能力
言語モデルは、最新の情報、正確な計算、社内データ、および実際のWeb操作などの領域に固有の制限があります。 ツールは、検索API、データベース、計算機、コード実行者、およびビジネスシステムを接続することで、この制限を補います。 しかし、ツールの数が増えるにつれて、どのツールがいつ選ぶべきか、正しいフォーマットで呼び出す方法、失敗の結果を解釈する方法など、新しい推論の問題が発生します。
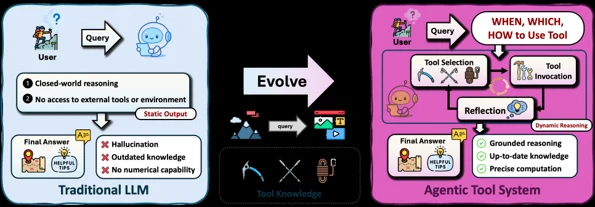
図3。 既存のLLMとエージェントタイプのツール使用システムの違い
出典:同じ紙、図3、p。 15.15.(日)
従来のLLMは、図の左側に、外部ツールにアクセスしていないため、知識が不足しているか、または誤って計算される可能性があります。 右上のエージェントのようなシステムは、ユーザーの質問を探し、必要なツールを選択し、コール結果を確認し、不十分な場合は再び選択します。 キーはツール自体ではありませんが、選択のサイクル、リコール、観察、および再選択。
ツール使用中の一般的な失敗は、非既存のツール名を作成したり、誤って引数を記入したり、ツールのエラーメッセージを成功として解釈したり、同じ失敗した呼び出しを繰り返したりします。 そのため、ツールのスキーマ検証、事前呼び出しチェック、実行時間制限、検索回数、許可制御、結果の起源の徴候を一緒に設計する必要があります。
3.3 検索: 自分で必要な情報を見つける能力
従来のRAGでは、問題が起きたときには、あらかじめ決められた方法で一度検索し、その文書に基づいて回答します。 エージェントベースの検索は、検索するときに各ステップで決定します。, 何を検索するか, 結果が十分かどうか, 追加検索が必要かどうか. つまり、前処理段階ではなく、推論プロセスに入っています。
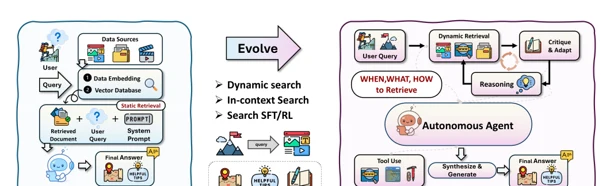
図4. 静的RAGとエージェントベースの検索システムの比較。
出典:同じ紙、図4、p。 18.18.(日) 説明に必要な回路図部分を抜粋しました。
たとえば、特許の事前の検索を行うエージェントは、最初の検索結果が多すぎると、分類コードや出願人を追加することができ、逆に、結果が少ないときに、同義語または高レベルの概念を拡張することができます。 あなたが見つけた文献がすべての重要なコンポーネントを示すかどうかを自分で確認する必要があります。 これは、単にいくつかの検索結果を要約するとは異なります。
論文は、プロンプトで推論時にエージェント型検索を実行する方法、ファインチューニングや強化学習で検索行動を学習させる方法、知識グラフなどの構造化情報を用いる方法に整理しています。三つは競合するものではなく、システムの要件に応じて組み合わせることができます。
4。 自己進化するエージェントの推論:フィードバック、メモリ、および能力の拡張
ベースエージェントは1つのタスクをうまく実行することに焦点を当てていますが、自己進化するエージェントは、次のアクションや次のタスクでより良いになるためにその経験を使用することを目指しています。 理論は、その中心にフィードバックと記憶があることを信じています。 フィードバックは、何が間違っていたかを教えてくれ、メモリは、次の決定書にこれらのレッスンを書き換えることができます。
4.1 フィードバック:誤ったパスを発見し、正しい方法
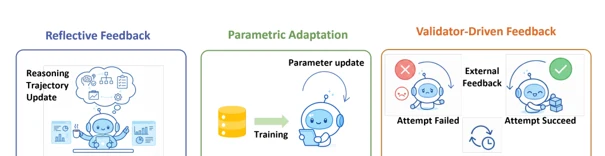
図5. 代理店のフィードバックの3つの形態
出典:同じ紙、図5、p。 21.(日)
論文はフィードバックを三つに分類しています。推論時の自己省察は、パラメータを変えずに回答や計画を批判的に検討し、書き直す方法です。パラメータ適応は、検証済みの軌跡や選好データから学習し、改善した行動をモデルの重みに反映する方法です。検証器によるフィードバックでは、単体テスト、制約チェッカー、シミュレーターなどが成否を判定し、失敗時の再試行につなげます。
3つの方法の違いは、フィードバックが残っているところにある。 リフレクションは、多くの場合、現在の会話内で影響するだけでなく、パラメータの適応は長期的な行動変化をもたらします。 障害の理由を詳しくすることなく、受動可能な結果を選ぶことで、検証ベースの方法は強いです。 これは、コード生成など、検証が安くて明白である領域で特に有用です。
4.2 記憶: 会話記録を蓄積するよりも、後ろに残っていることはより重要です
長い会話の動詞を格納する機能として、メモリは簡単に誤解することができます。 しかし、有能な記憶への鍵は記憶ではなく、選択と構造です。 記録の決定、それを要約する方法、および古い情報を削除するとき。
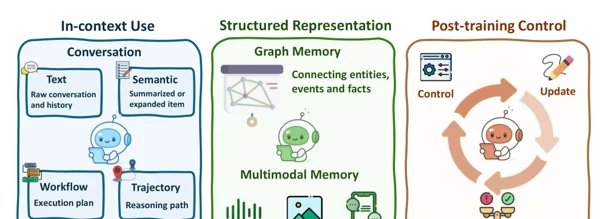
図6. 有能な記憶の3つの設計軸。
出典:同じ紙、図6、p。 24.24.(日) 説明に必要な回路図部分を抜粋しました。
第一の軸は、会話、要約、ワークフロー、過去の実行軌跡を現在のプロンプトにどう活用するかです。第二の軸は、エンティティ間の関係をグラフとして保存したり、画像・音声・文書を併せて扱ったりする構造化メモリです。第三の軸は、メモリの書込み、更新、削除、検索そのものを学習の対象にする方法です。
メモリの主な危険性:誤った事実が長期的メモリに入った場合、それらは繰り返し多くのその後のタスクに影響を与えることができます。 ユーザ固有の情報が混在している場合、プライバシー侵害や権利漏洩が起きる場合があります。 したがって、ソース、作成時間、信頼性、アクセス権、満了条件、および変更履歴を維持することが重要です。
4.3 自己進化:計画、ツール、検索自体を変更する機能
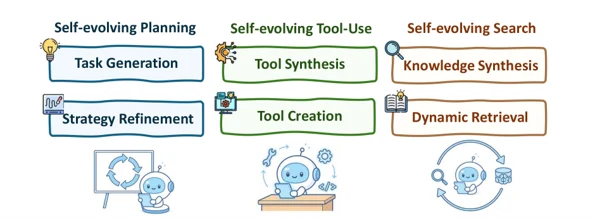
図7. 自分で計画、ツーリング、検索が進化する方法。
出典:同じ紙、図7、p。 28.28.(日) 説明に必要な回路図部分を抜粋しました。
自己進化は、一度の答えを見直しるよりも広範です。 エージェントは、成功と失敗を比較し、計画戦略を変更し、既存のツールで解決しにくい問題に遭遇したときに新しいコードツールを作成することができます。 検索では、頻繁に使用される情報ソースを覚え、検索パスを改善することができます。
しかし、これまでも自己進化の表現をとらえる必要はありません。 現在の研究の多くは限られた環境の固定フィードバックを使用して記憶か方策を更新するレベルにあります。 これは、人が自分の目標や価値観を決めることを意味するものではありません。 システムの要素が変更できるか、変更が承認されるか、変更の誤った変更がリバースできるかをクリアする必要があります。
5。 5。 集合的理由:役割、コラボレーション、集合的な記憶。
複雑な課題では、一つのエージェントがすべてを担う代わりに、複数のエージェントが役割を分担します。例えば、計画の作成、検索、結果の検証を別々のエージェントが担当します。論文は、こうした構造を協調的なマルチエージェント推論として整理しています。
5.1 ロールデザイン:同じプロンプトを全員に与えることはコラボレーションではありません
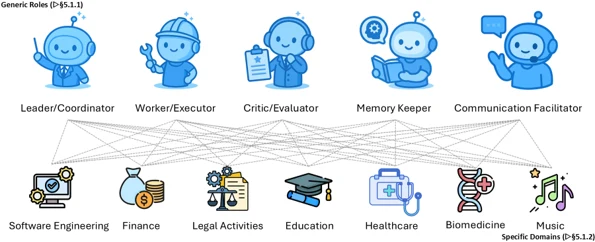
図8. マルチエージェントの一般ロールおよびドメイン固有のアプリケーション
出典:同じ紙、図8、p。 30.30(日)
論文が挙げる代表的な役割は、リーダー・調整役、実行役、批評・評価役、メモリ管理役、通信調整役です。リーダーは目標を分解して進捗を管理し、実行役は検索・コード実行・資料作成を行います。評価役は誤りやリスクを確認し、メモリ管理役は失敗の繰返しを減らして長期的な知識を整理します。通信調整役はメッセージの形式と共有範囲を制御します。
法律業務を例にすると、受付エージェントが事実関係を整理し、分野別の分析エージェントが法令と判例を検討し、検証エージェントが引用と論理の整合性を確認する構成が考えられます。ただし、役割を分けるだけで精度が上がるわけではありません。各役割の入出力形式、責任範囲、停止条件、相互検証の方法を具体的に定める必要があります。
5.2 コラボレーション構造:シーケンシャル、階層、ロール、自動生成
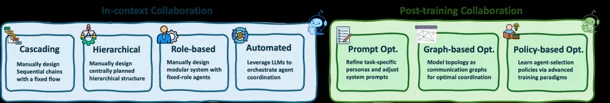
図9。 推論・ポイント・コラボレーションとポスト・ラーニング・ベースのコラボレーションの差別化
出典:同じ紙、図9、p。 34.34.
Inference-point コラボレーションは、エージェント間の注文とロールをプロンプトまたはワークフローで決定します。 シーケンシャルタイプでは、次のステップは前のステップの結果を継承し、階層型では、中央コーディネーターがサブエージェントを管理します。 ロールタイプでは、特殊な機能が事前に分割され、自動生成されたタイプでは、LLMは割り当てに応じてワークフローを設定します。
ポスト学習ベースのコラボレーションは、各ロールのプロンプト、エージェント間の接続グラフ、およびエージェントを選択して、データや報酬を使用して次の呼び出しを行います。 ここで最も困難な問題は、その貢献がジョイント・パフォーマンスに起因する決定です。 最終的な回答が正しい場合でも、前のステップでどれだけの検索や反論が貢献したのかを隔離することは困難です。
5.3 共同メモリ:複数のエージェントが共有するのは何ですか?
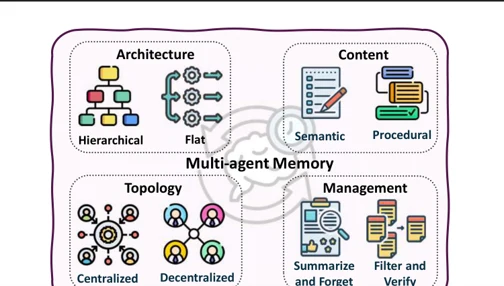
図10. 多試薬の記憶の4つの設計次元。
出典:同じ紙、図10、p。 40. 40. 説明に必要な回路図部分を抜粋しました。
複数のエージェントが協働する場合、メモリの設計は複雑になります。論文は、構造、トポロジー、内容、管理の四つの軸で説明しています。構造は階層型かフラット型か、トポロジーは集中型か分散型か、内容は事実中心か手順中心か、管理は要約・忘却・フィルタリング・検証をどう行うかという論点です。
より多くの情報を共有し、より豊かで、情報だけでなく、コミュニケーションのコストと汚染の危険性が大きい。 逆に、ロールによる情報の分離が不要な場合もある。 特に、企業環境では、共有メモリとプライベートメモリは、個人情報、取引秘密、および部門別アクセス権を考慮し、各情報のソースおよび閲覧履歴を録音する必要があります。
6。 。 推論ポイント設計とポストラーニングの違い
この論文を整理する重要な方法は、エージェント関数が実装されたときに応じて、推論ポイントメソッドとポスト学習方法に分けることです。 2つは置換ではなく、コスト、柔軟性、安定性に基づいて組み合わせるオプションを設計します。
推論点アプローチは、モデルの重みを固定しながら、プロンプト、検索、ワークフロー、および外部メモリで動作を調整します。 既存のモデルに素早く変更し、簡単に適用できる利点がありますが、プロンプトの長さ、コールコスト、および実行の不安定性の対象となります。 そのため、ビジネスルールが頻繁に変化する製品や実験段階にある製品に適しています。 典型的な産業設計は計画のプロンプト、調査ループ、記憶調査、確認およびretry、等を含んでいます。
一方、後学習方法は、強化学習、ファインチューニング、好み学習を通じて行動パターンをモデルウェイトに統合します。 繰り返しタスクで一貫した高速な動作を期待できますが、トレーニングデータやリワードデザインが必要で、更新コストも高くなります。 特定の環境に最適化された大規模な反復タスクやエージェントに適しており、代表的な産業設計には、ツールコールのファインチューニング、検索方策の強化学習、およびメモリ制御学習が含まれます。
実際には、現実的なアプローチは、最初に、推論ポイントメソッドを使用してワークフローを検証し、学習データとして繰り返しの成功パターンを作成し、それらをポスト学習に転送することです。 ゼロからすべてを訓練することは、すべての判断をプロンプトに残しながら、トークンコストとレイテンシを増加させることができます。
優れた混合設計の例は、ツールのデフォルト選択とコールフォーマットが学習、最新ビジネスルール、およびユーザー固有の条件によって安定化されるところであり、外部メモリとポリシーによって管理され、高リスクのアクションは、検証者と人間の承認の対象となります。
7。 実際のアプリケーションとベンチマーク
7.1 どこで適用されますか?
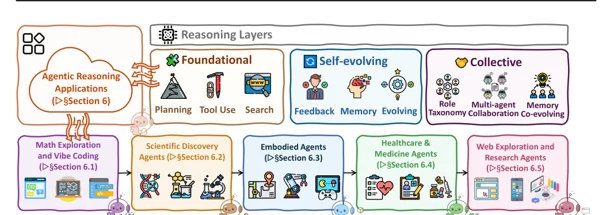
図11. エージェントベースの推論の代表的なアプリケーション領域
出典:同じ紙、図11、p。 43.43. 説明に必要な回路図部分を抜粋しました。
論文は数学的な照会およびコーディング、科学的発見、ロボットおよびエンボディされた代理店、ヘルスケア、網の運行および自律的な研究の代表的な適用をカバーします。 同じ技術でも、フィールドからフィールドに重要な制約が異なります。 実行とテストは、コードエージェント、エビデンス、および責任あるレビューにとって重要なことは、医療エージェントにとって重要であり、安全な物理的な行動とリアルタイムの反応は、ロボティックエージェントにとって重要です。
- - 数学とコーディング:問題の分解、コードの実行、テスト、エラー修正、およびリポジトリレベルでの長期的作業は、キーです。
- - 科学的発見:仮説を生成し、実験を計画し、ツールを実行し、結果を評価し、実験と反復を設計します。
- - ロボットとエンボディエージェント:空間意識と実際の行動で言語の目標を接続し、環境の変化に対応しなければならない。
- - 医療:専門家のエージェント間のコラボレーション, 証拠を検索します。, 患者の状態を覚えています。, 安全な意思決定を支援することが重要です。.
- - Web調査と独立した研究: 複数のサイトとツールの間で戻って、情報を検証し、長期的な結果に合成する必要があります。
7.2 評価するべきこと
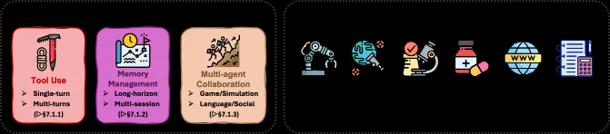
図12. エージェントの推論ベンチマークの範囲
出典:同じ紙、図12、p。 65.65.(税抜き)
エージェントの評価で最終正答率だけを見ると、重要な失敗を見落とす可能性があります。同じ正解に到達しても、不必要に数十回のツール呼出しを行ったか、誤った情報をメモリに残したか、危険な動作を試みたかによって、製品としての評価は変わります。本論文は、ツール利用、メモリ、計画、マルチエージェントといった基本能力のベンチマークと、ロボティクス、科学、医療、ウェブなどの応用分野のベンチマークを整理しています。
実際のサービス評価では、タスクの成功率に加えて、ステップバイステップの精度、ツールコールの成功率、レトリーの数、平均時間、トークンとAPIのコスト、エラー回復率、メモリ破損率、証拠引用精度、人間の介入回数、および危険な行動ブロックレートを測定することをお勧めします。 エージェントは、複数のコンポーネントが接続されているシステムであるため、最終スコアだけでどの部分が問題となっているかを分かりにくいです。
8月8日 人工知能特許に特化した特許弁理士の視点
特許の観点からこの論文を読み込む際の最初のことは、エージェント型推論の広範な概念は、特定の実装発明とは異なることです。 計画、ツール作成、検索、メモリ、コラボレーションのコンポーネントは、すでに多くの事前の研究とオープンソースフレームワークで対処されています。 そのため、これらすべての要素を含むことを示すだけでは差別化が困難です。
逆に、実際の製品を作るときに遭遇した特定のボトルネックを解決する構造で十分な知的財産価値を作成することができます。 例えば、繰り返されたツールのエラー、長期メモリに蓄積された誤った情報、急速に増加するマルチエージェント通信コスト、他のエージェントに露出しているユーザー固有の情報、および長いタスクの中間状態の損失など、技術的な問題が明確になり、権利化の方向が明確になります。
8.1 注目すべき技術領域
6つの主要な技術領域があります: エラー蓄積と長いタスクの高再起動コストの問題を計画し、状態の表現、ステップ遷移条件、中間チェックポイント、逆転範囲、計画再構築ルールの具体的な外観が必要です。 ツールのオーケストレーションでは、ツール選択エラー、無効な引数、繰り返された呼び出し、およびパーミッションの誤用は問題であり、ツールスキーマの正規化、事前呼び出し検証、動的ルーティング、エラーコードによる回復、パーミッション、サンドボックスは主要な実装要素です。
エージェントベースの検索では、不要な検索、証拠の欠如、および競合文献の処理が解決しなければならないので、検索の必需品の決定、クエリの書き換え、ソースの信頼性の評価、情報不足、および検索終了条件が重要である。 記憶制御は、記憶の記憶、冗長記憶、個人情報の混合、および検索遅延を削減し、重要な実装要素には、記録受容、要約、および構造、信頼性および満了、削除および修正、アクセス権、および実証済みの追跡が含まれます。
複数のエージェントのコラボレーション、役割の割り当て、コミュニケーショントポロジ、メッセージの圧縮、共同報酬、合意解除の調整、および貢献の評価では、通信コスト、役割の重複、不明確な責任、および集団的なエラーを減らすように設計する必要があります。 最後に、ガバナンスと監査、経理の追跡と長期的な行動のリスク管理が重要であり、行動ログ、ポリシーの検査、承認手順、リスクレベルによる権限、中断および回復、および再現可能な監査記録が重要である。
8.2 差分は、コンポーネントの名前ではなく、動作条件にあります
名前のエージェント、プランナー、メモリ、およびバディファイアーをリストするだけで、機能的な説明であることを簡単に終わらせることができます。 差別化の鍵は、入力と状態に基づいて決定が何であるか、データ構造が更新され、障害が発生した場合にどのような回復経路が取られるかを示すものです。
状態を具体的なして下さい。 現在のゴール、完了ステージ、未確認の状態、ツールの実行結果、信頼性、および許可ステータスの管理方法を説明する必要があります。
トリガーを絞り込みます。 さらなる検索、再計画、人間の承認、およびメモリ更新がトリガーされる条件を数値または規則に提示することをお勧めします。
データのフローを最適化します。 どのモジュールがどの情報を受信するか、次のモジュールに渡するフォーマットで表現する必要があります。
技術的な有効性を測定します。 コールカウント、レイテンシー、メモリ使用量、エラー回復率、およびリスクのある動作ブロックレートなどの再現可能なメトリックが必要です。
それは代替産業設計の多くを残します。 集中型、分散型、ルールベース、学習ベース、シングルエージェント、マルチエージェントなど、さまざまなエンボディメントを持つことで、急速に変化する市場への対応が容易です。
結論:言語モデルからアクションシステムまで
本論文が示すのは、LLMの発展が長い回答の生成だけを目指しているわけではないということです。目標を理解し、計画を立て、必要なツールと情報を選び、行動の結果を記憶し、失敗から復旧し、必要に応じて他のエージェントと協働するシステムへと進んでいます。
同時に、エージェントがより強力になるため、システム設計に対する責任も増加します。 これは、間違った行動のチェーンが単一の間違った文章よりも大きな影響を与える可能性があるためです。 したがって、状態管理、検証、権限、監査、メモリ衛生、中断および回復は、パフォーマンスとして重要である。
特許の観点から同じ結論が届きます。 以下のブズワードよりも、実際の製品で技術的な問題を再調査し、特定のデータフローを整理し、これらの問題を解決するルールを制御する必要があります。 エージェントの時代における競争力は、モデルの名前からだけでなく、モデルが安全で効率的に動作することを可能にするシステムアーキテクチャから来ている可能性があります。
この記事は公表時点の情報に基づいています。個別の事情については、当事務所にご相談ください。