사내 규정을 찾아 답하는 AI에 정답이 담긴 문서를 넣었는데도 답을 놓치는 경우가 있습니다. Liu 연구팀은 같은 질문과 문서 묶음에서 정답을 담은 문서의 위치만 바꿔, 실험에 사용한 여러 모델이 입력 가운데에 놓인 근거를 활용할 때 정확도가 낮아지는 경향을 확인했습니다. 가상의 출장비 증빙 질문을 따라가며, 문서를 얼마나 많이 넣을지와 어떤 순서로 전달할지를 각각 시험하는 방법을 살펴보겠습니다.
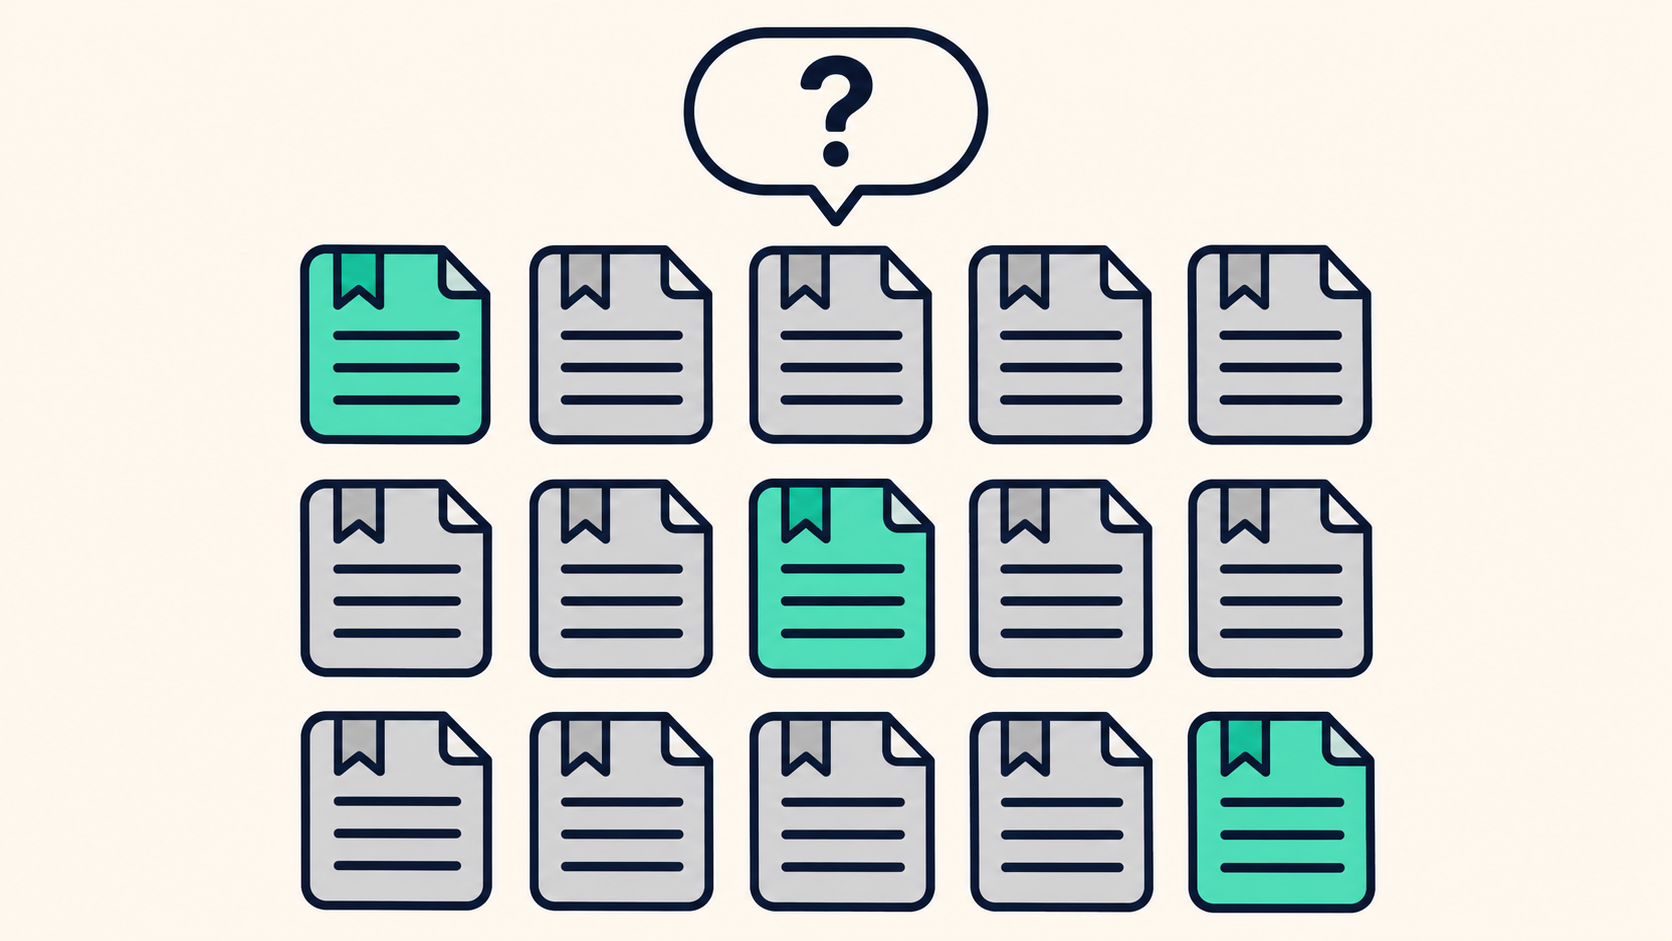
같은 문서 묶음에서 정답을 담은 문서 한 장을 앞, 가운데, 끝에 배치한 개념 그림입니다.
1. AI가 받은 문서와 답변에 쓰인 문서
사내 챗봇에 ‘출장에서 열차를 이용했는데 정산할 때 무엇을 첨부하나요?’라고 물었다고 해 보겠습니다. 검색 시스템은 출장비 규정과 출장 승인 절차, 회계 마감 안내 등 비슷한 자료를 골라 모델에 보냅니다. 모델은 이 자료를 읽고 답합니다. 정답을 담은 문서가 실제로 전달됐는데도 다른 절차를 설명한다면, 검색 결과를 더 늘리기 전에 입력이 어떻게 구성됐는지 살펴볼 수 있습니다.
입력 문맥은 모델이 한 번의 답변을 만들 때 받는 지시, 질문, 참고 문서 등의 묶음입니다. 문맥 창은 모델이 처리할 수 있는 토큰 수의 범위를 가리킵니다. 토큰은 모델이 문장을 처리하기 위해 나눈 글자나 단어의 조각입니다. 같은 분량을 담을 수 있는 모델이라도 그 안의 근거를 고르게 활용하는지는 실험으로 확인할 문제입니다.
Nelson F. Liu 연구팀의 Lost in the Middle은 답변을 뒷받침할 문장이 문서 묶음 속 어디에 있는지에 주목한 연구입니다. 분석은 2024년 Transactions of the Association for Computational Linguistics에 게재된 최종판을 기준으로 합니다.
2. 질문과 문서는 두고 정답 문서의 위치를 바꿉니다
연구팀은 위키백과 문단으로 답할 수 있는 NaturalQuestions-Open 질문 2,655개를 사용했습니다. 질문마다 정답으로 주석된 내용이 들어 있는 문단 하나와, 질문과 관련은 있지만 주석된 정답을 포함하지 않는 문서 조각들을 함께 제시했습니다. 문서가 모두 질문과 무관하면 정답을 담은 문서만 쉽게 눈에 띌 수 있으므로, 주변 문서도 검색 시스템이 찾아낸 관련 자료로 구성했습니다.
위치의 영향을 살필 때에는 질문과 문서 묶음을 유지하고 정답을 담은 문서가 들어갈 순서를 바꿨습니다. 입력의 길이를 비교하는 실험에서는 주석된 정답이 없는 문서의 수를 조절해 전체 문서 수를 10개, 20개, 30개로 구성했습니다. 같은 질문에 같은 답이 기대되므로, 각 조건에서 모델의 출력이 얼마나 달라지는지 비교할 수 있습니다.
답변에는 정답 표현이 여러 가지 있을 수 있습니다. 연구팀은 주석된 정답 중 하나라도 모델 출력에 포함됐는지를 기준으로 정확도를 계산했습니다. 이 지표는 정답을 언급했는지 보여 줍니다. 어떤 문장을 근거로 삼았는지까지 평가하려면 근거 인용을 별도로 채점해야 합니다.
3. 출장비 증빙 규정으로 위치 차이를 살펴봅니다
가상의 회사에서 ‘열차 운임 정산에는 승차권 영수증을 첨부하세요’라는 규정을 운영한다고 가정해 보겠습니다. 질문은 앞서 본 ‘열차를 이용한 출장에서 무엇을 첨부하나요?’로 두고, 출장비 증빙 규정과 회의실 예약 안내, 출장 승인 절차, 회계 마감 안내, 사내 연락처를 함께 전달합니다. 다섯 자료 중 증빙 규정에 답이 들어 있습니다.
첫 번째 입력에서는 증빙 규정을 문서 목록의 첫 번째에 둡니다. 두 번째 입력에서는 그 문서만 가운데로, 세 번째 입력에서는 끝으로 옮깁니다. 질문 문구, 지시, 다른 문서의 내용은 그대로 둡니다. 어느 경우에도 기대하는 답은 ‘승차권 영수증’입니다.
이렇게 준비한 뒤 서비스가 사용하는 모델과 설정으로 세 입력에 답하게 합니다. 가운데 배치에서만 출장 승인 절차를 답하는 사례가 반복된다면, 어떤 위치에 있는 근거를 놓치는지 살펴볼 수 있습니다. 한 번의 오답은 모델이 그 위치를 일관되게 놓친다는 뜻이 아니므로, 여러 질문과 근거 문단에 같은 비교를 적용하는 편이 좋습니다.
4. 20개 문서를 받았을 때 정확도는 어땠을까요?
논문의 그림 1은 GPT-3.5-Turbo의 0613 버전에 문서 20개를 제공한 결과를 보여 줍니다. 이 조건의 입력은 약 4천 토큰입니다. 그림에서 읽은 대략적인 정확도는 정답 문서가 첫 번째일 때 76%, 가운데 부근일 때 54~55%, 마지막일 때 63%입니다. 가운데에서 내려갔다가 끝으로 갈수록 다시 올라가는 모양을 볼 수 있습니다.
논문의 표 1에서 같은 모델의 정확도는 참고 문서를 주지 않았을 때 56.1%, 정답을 담은 문서 한 개만 제공했을 때 88.3%였습니다. 해당 문서를 20개 자료의 가운데에 넣은 일부 조건에서는 문서를 제공하지 않은 기준보다 낮았습니다. 정답 문서를 전달했는지와 전달된 문서를 모델이 답변에 활용했는지를 따로 살펴볼 이유가 여기에 있습니다.
수치의 적용 범위는 논문이 사용한 질문과 모델, 입력 구성에 한정됩니다. 예를 들어 동일한 10개와 20개 문서 조건에서 GPT-3.5-Turbo의 일반 버전과 문맥 창을 16K로 늘린 버전의 위치별 정확도 곡선은 비슷했습니다. 처리할 수 있는 최대 길이와 같은 입력에서 근거를 쓰는 능력을 각각 비교한 결과입니다.
5. 코드 찾기와 실제 문서 검색에서도 비교했습니다
연구팀은 문장 의미를 해석하는 부담을 줄이기 위해 키와 값 찾기 실험도 했습니다. 예를 들어 ‘물품번호 A17’에 연결된 값을 목록에서 찾는 일과 비슷합니다. 실제 실험에는 무작위로 생성한 식별자 쌍을 사용하고, 특정 키와 짝을 이루는 값을 그대로 출력하도록 했습니다. 모델에 따라 거의 정확하게 찾기도 했고, 입력이 길어지거나 찾는 항목이 가운데에 있을 때 더 많이 놓치기도 했습니다.
별도 검색 실험에서는 모델에 전달할 문서를 위키백과에서 검색하게 했습니다. 앞의 비교에서는 정답 문서 한 개를 입력에 넣었지만, 검색 실험의 입력은 실제 검색 결과여서 그 안에 정답 문서가 없거나 여러 개일 수 있습니다. 연구팀은 검색 결과에 정답이 들어 있는 비율과 모델이 정답을 출력하는 비율을 따로 계산했습니다.
이 검색 실험에서 결과를 더 많이 가져올수록 검색 단계는 정답이 담긴 문서를 더 자주 포함했습니다. 반면 모델의 답변 정확도는 그만큼 계속 오르지 않았습니다. 문서를 추가할 때 얻는 정보와 함께, 추가 문서가 모델에 전달되는 순서와 분량도 평가할 수 있습니다.
6. 사내 검색을 평가할 때 남겨 둘 기록
팀에서 먼저 ‘필요한 근거가 있는가’를 확인해 보세요. 검색 결과에 규정이 빠졌다면 검색어 처리나 자료 색인, 검색 순위를 살필 수 있습니다. 규정이 포함됐는데 답을 놓쳤다면, 같은 문서로 순서만 바꾸거나 중복 문단을 줄인 비교를 설계할 수 있습니다. 질문과 정답 근거, 모델에 실제로 넘긴 문서의 목록과 순서를 남겨 두면 두 상황을 구분할 수 있습니다.
문서가 여러 개 필요한 질문도 시험해 보세요. 한 문서에는 정산 기한, 다른 문서에는 증빙 종류가 들어 있다면 둘 중 하나를 줄였을 때 답이 불완전해질 수 있습니다. 문서 수와 위치별 정확도뿐 아니라, 중요한 근거가 빠진 답과 답변에 인용된 문장이 실제 규정에 맞는지도 비교하면 서비스의 실패 원인을 구체적으로 파악할 수 있습니다.
문서 검색 기술을 특허 관점에서 정리할 때에는 팀이 새로 개발한 처리 단계를 설명해 보세요. 후보 문서의 어떤 정보로 순서를 정하는지, 두 근거 문단을 함께 전달해야 할 때 어떻게 묶는지, 답변을 만든 뒤 인용과 근거를 어떻게 대조하는지 등을 입력과 출력에 연결해 기록할 수 있습니다. 같은 질문과 모델로 배치 방식만 바꾼 결과가 있으면, 어떤 설계가 어떤 문제를 줄였는지 비교하기 쉽습니다.
수치는 논문 당시의 질문·모델·입력 조건에 한정되며 그래프 수치는 대략적인 읽기 값입니다. 회사 규정 사례는 가상입니다.
바이두 AI 특허 쉽게 읽기: 모델 답변과 검색 지식이 충돌할 때 RAG가 처리하는 방법
구글 AI 문서 이해 특허: 제목·본문·이미지의 배치를 함께 읽는 원리
문서 검색과 근거 배치, 답변의 근거 연결 기술을 정리하려면 아이피렉스의 AI 프로젝트와 상담 준비 자료를 살펴보세요.